@zhangyy
2020-07-23T03:08:43.000000Z
字数 3863
阅读 584
kubernetes 部署Prometheus
kubernetes系列
一: 组件说明
二: Prometheus的部署
三: HPA 资源限制
一: 组件说明
1.1 相关地址信息
Prometheusgithub 地址:https://github.com/coreos/kube-prometheus
1.2 组件说明
1.MetricServer:是kubernetes集群资源使用情况的聚合器,收集数据给kubernetes集群内使用,如 kubectl,hpa,scheduler等。2.PrometheusOperator:是一个系统监测和警报工具箱,用来存储监控数据。3.NodeExporter:用于各node的关键度量指标状态数据。4.KubeStateMetrics:收集kubernetes集群内资源对象数据,制定告警规则。5.Prometheus:采用pull方式收集apiserver,scheduler,controller-manager,kubelet组件数据,通过http协议传输。6.Grafana:是可视化数据统计和监控平台。
二: Prometheus的部署
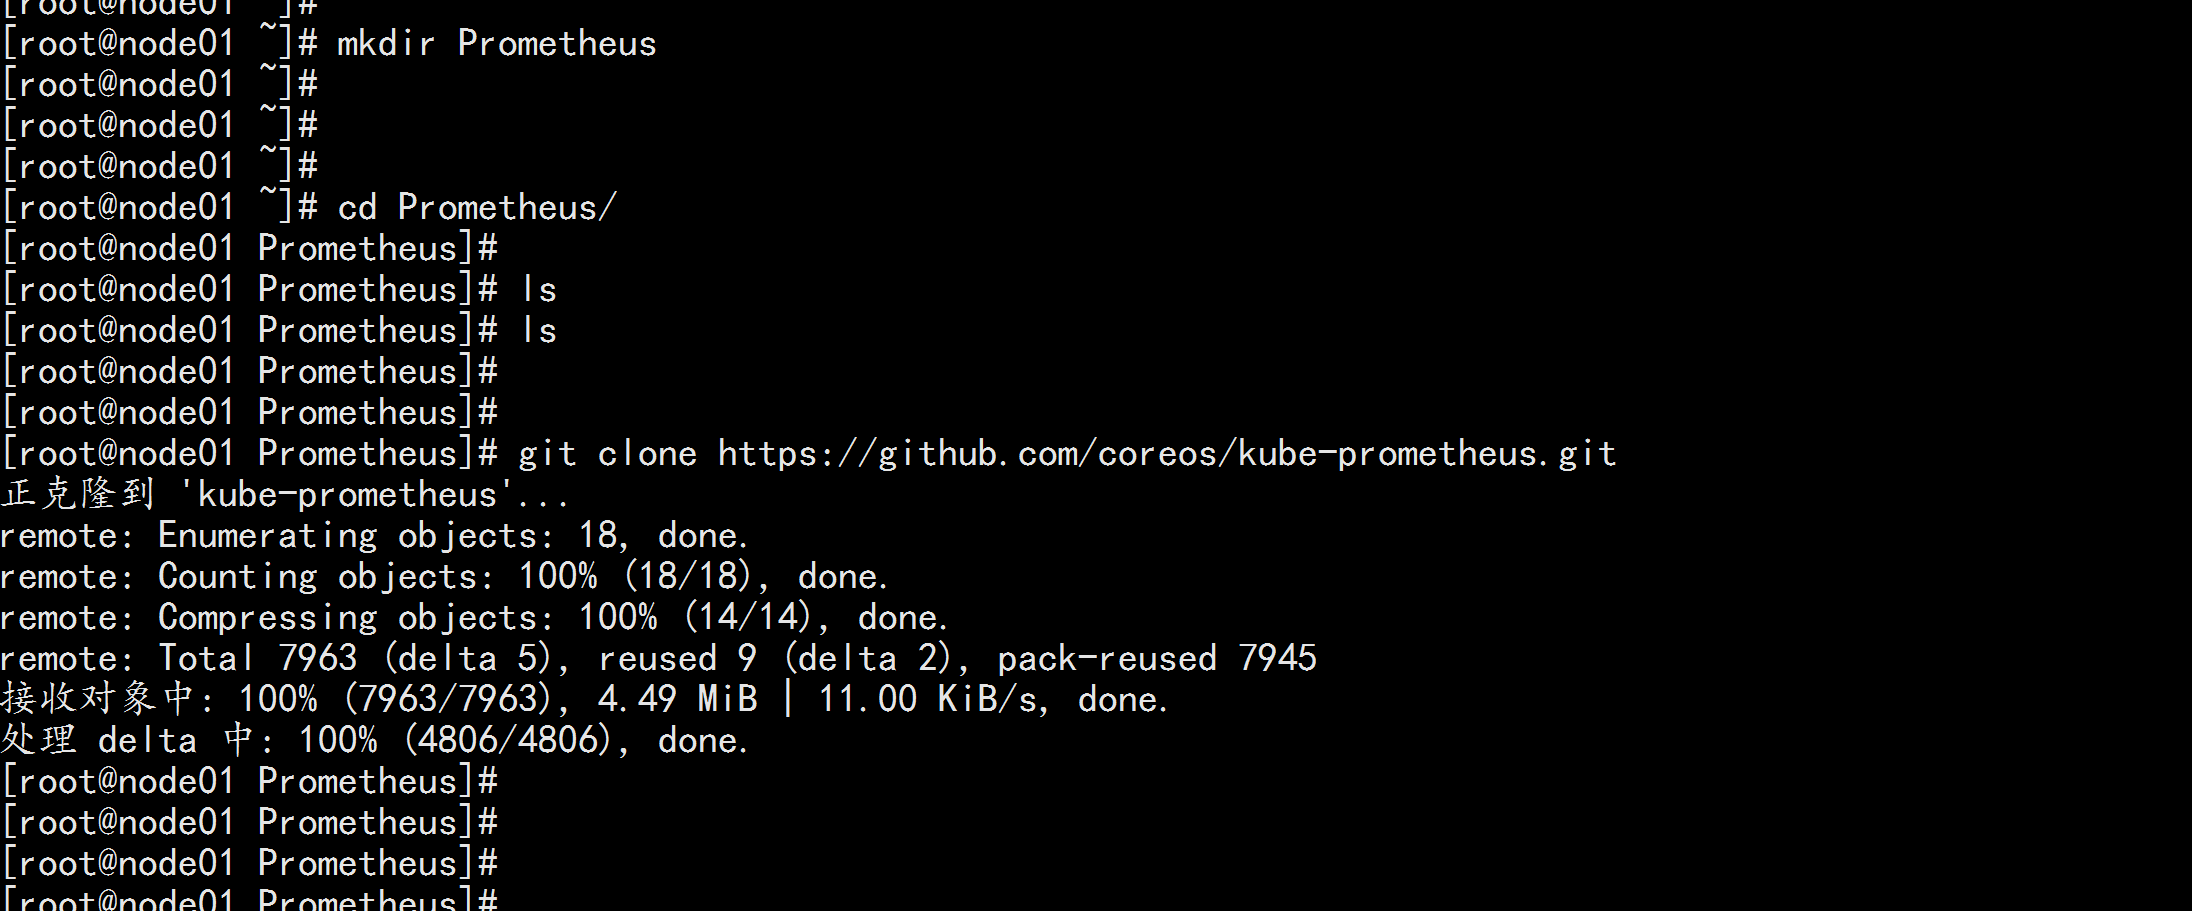
mkdir Prometheuscd Prometheusgit clone https://github.com/coreos/kube-prometheus.git
cd /root/kube-prometheus/manifests修改 grafana-service.yaml 文件,使用 nodeport 方式访问 grafana:vim grafana-service.yaml---apiVersion: v1kind: Servicemetadata:labels:app: grafananame: grafananamespace: monitoringspec:type: NodePortports:- name: httpport: 3000targetPort: httpnodePort: 30100selector:app: grafana---修改 prometheus-service.yaml,改为 nodepodevim prometheus-service.yaml-----apiVersion: v1kind: Servicemetadata:labels:prometheus: k8sname: prometheus-k8snamespace: monitoringspec:type: NodePortports:- name: webport: 9090targetPort: webnodePort: 30200selector:app: prometheusprometheus: k8ssessionAffinity: ClientIP----修改 alertmanager-service.yaml,改为 nodeportvim alertmanager-service.yaml---apiVersion: v1kind: Servicemetadata:labels:alertmanager: mainname: alertmanager-mainnamespace: monitoringspec:type: NodePortports:- name: webport: 9093targetPort: webnodePort: 30300selector:alertmanager: mainapp: alertmanagersessionAffinity: ClientIP---
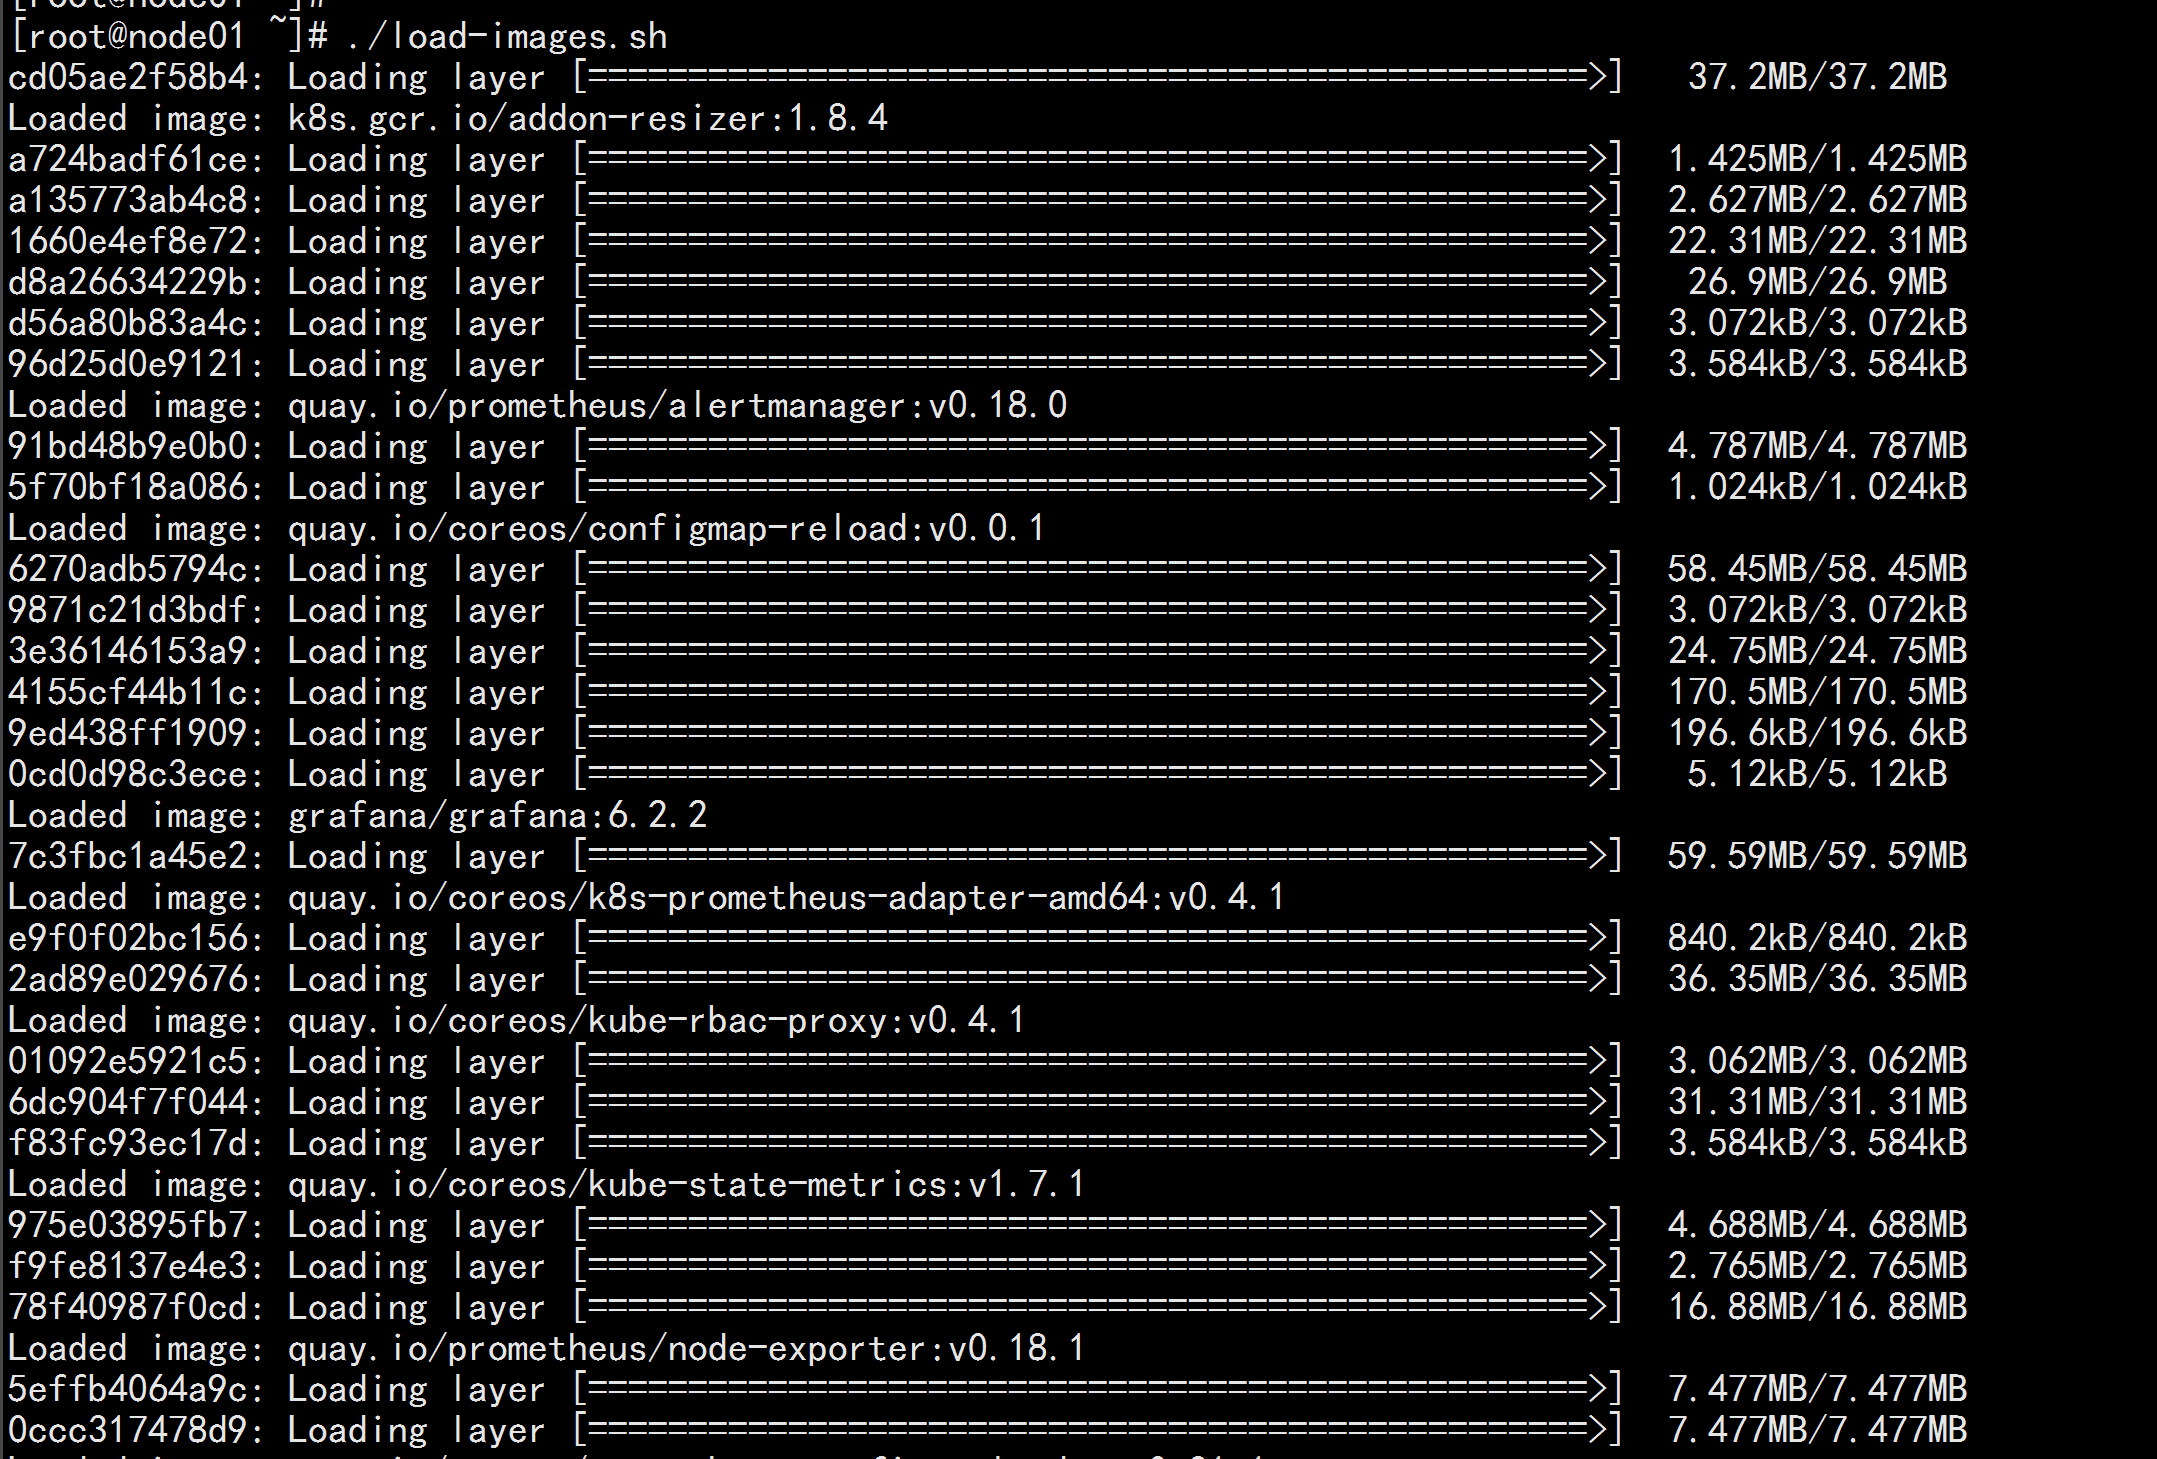
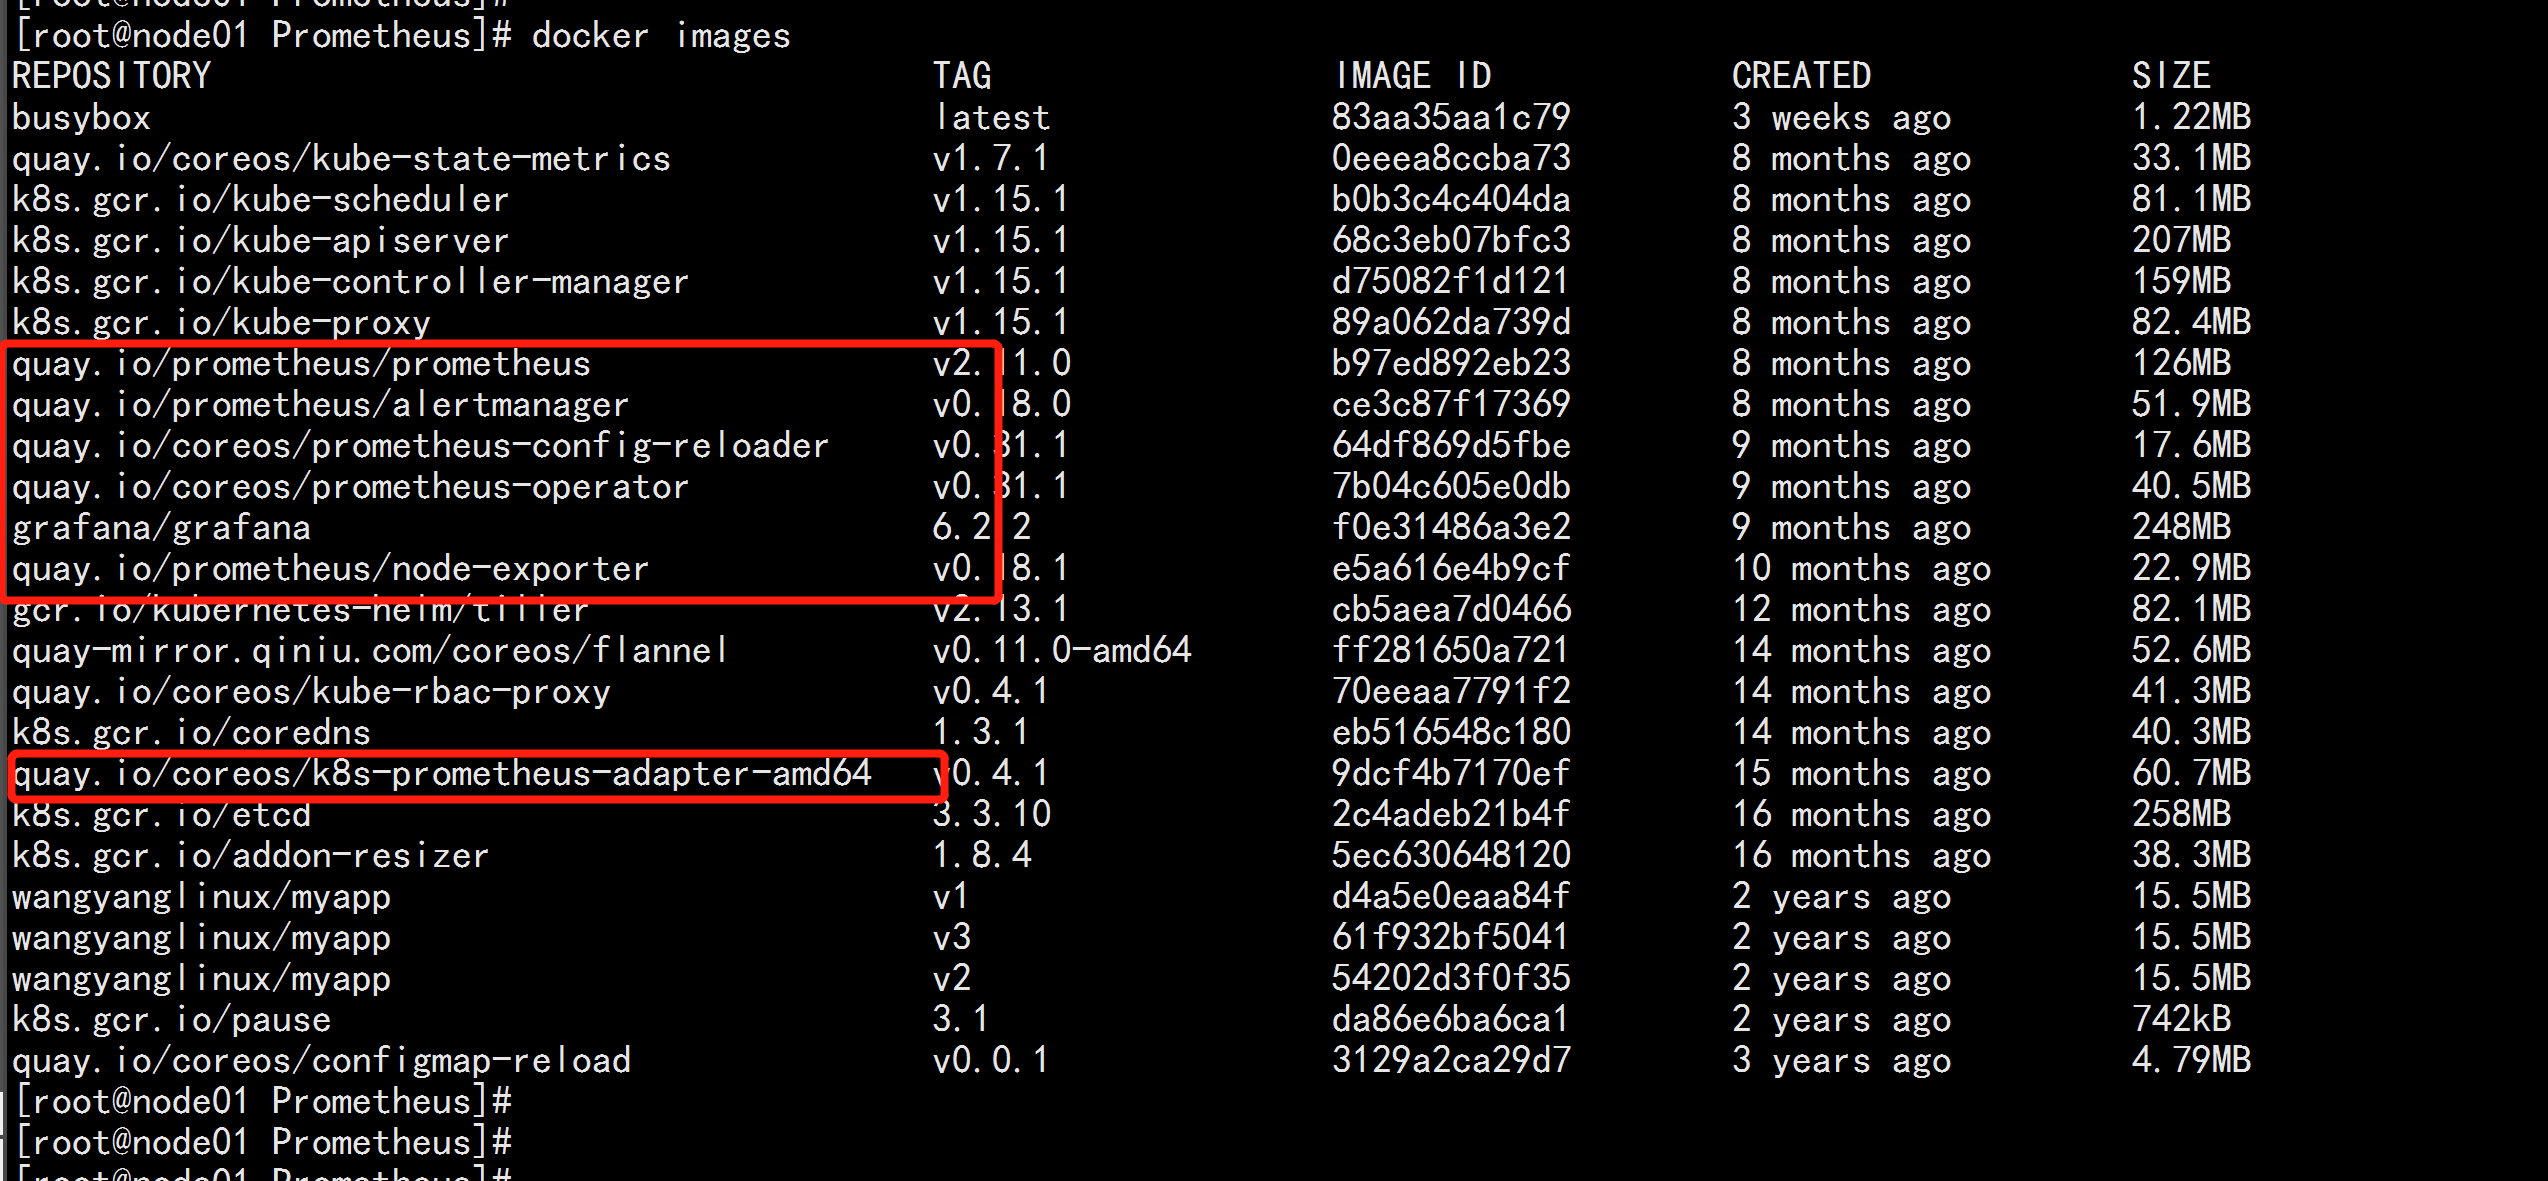
导入镜像处理(节点全部导入)上传 load-images.sh prometheus.tar.gz 到 /roottar -zxvf prometheus.tar.gzchmod +x load-images.sh./load-images.sh
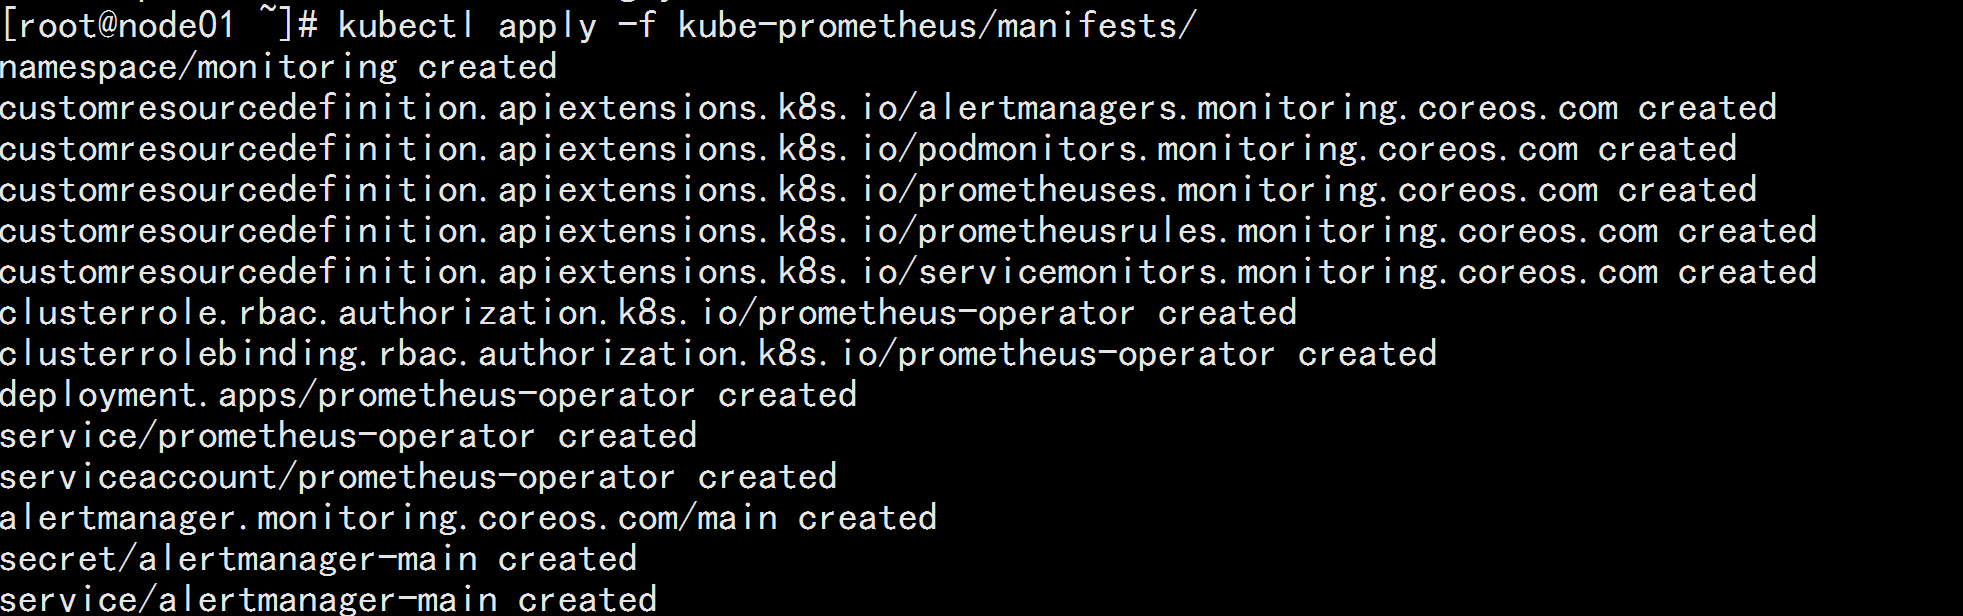
kubectl apply -f kube-prometheus/manifests/连续执行两次: 第一次会报错kubectl apply -f kube-prometheus/manifests/
kubectl get pod -n monitoringkubectl get svc -n monitoringkubectl top node
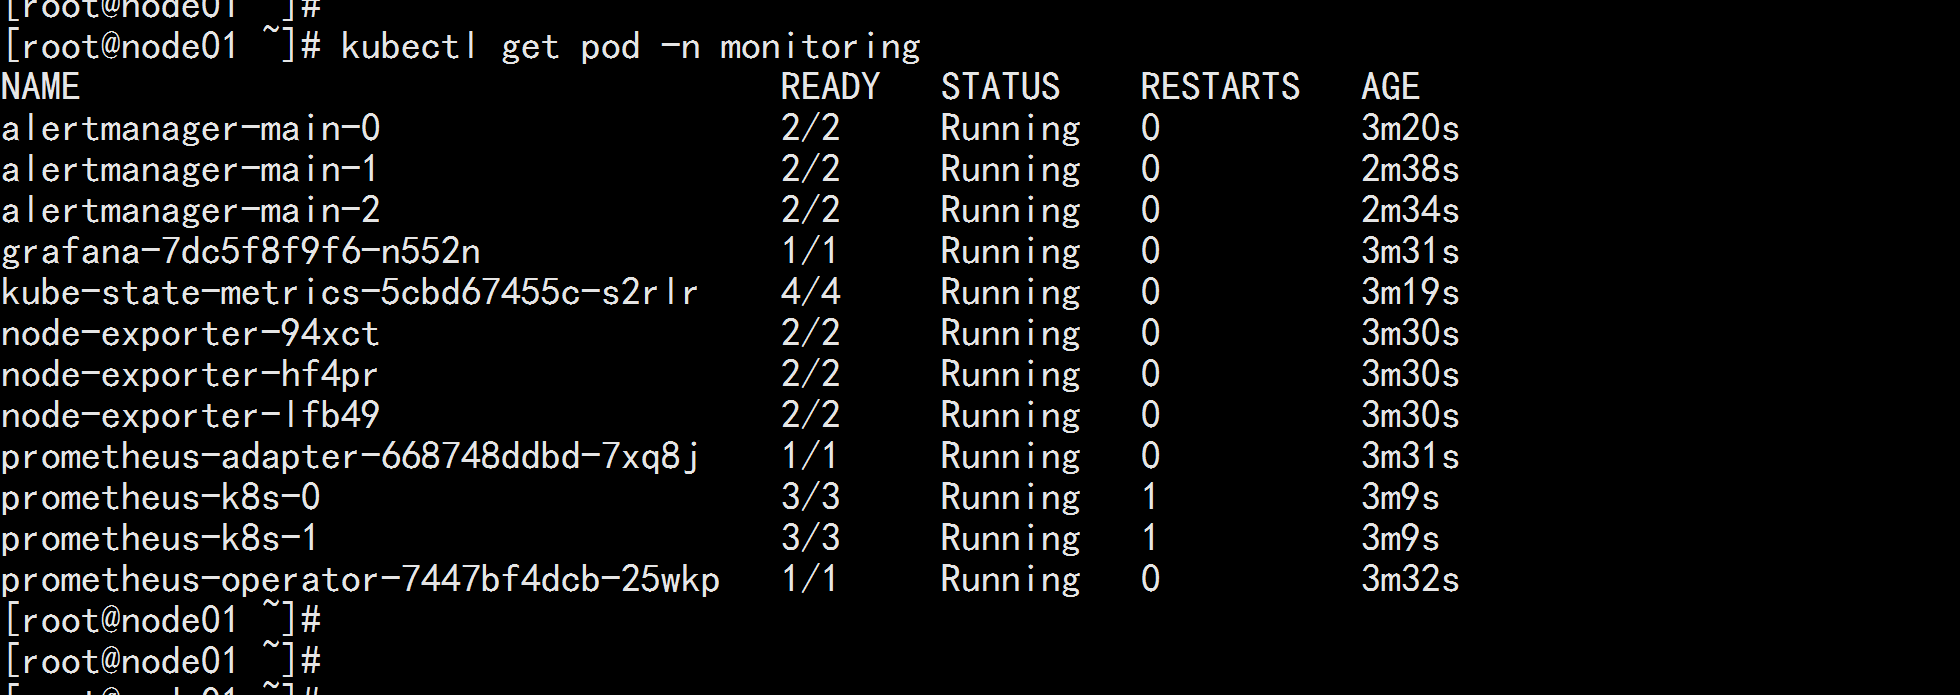
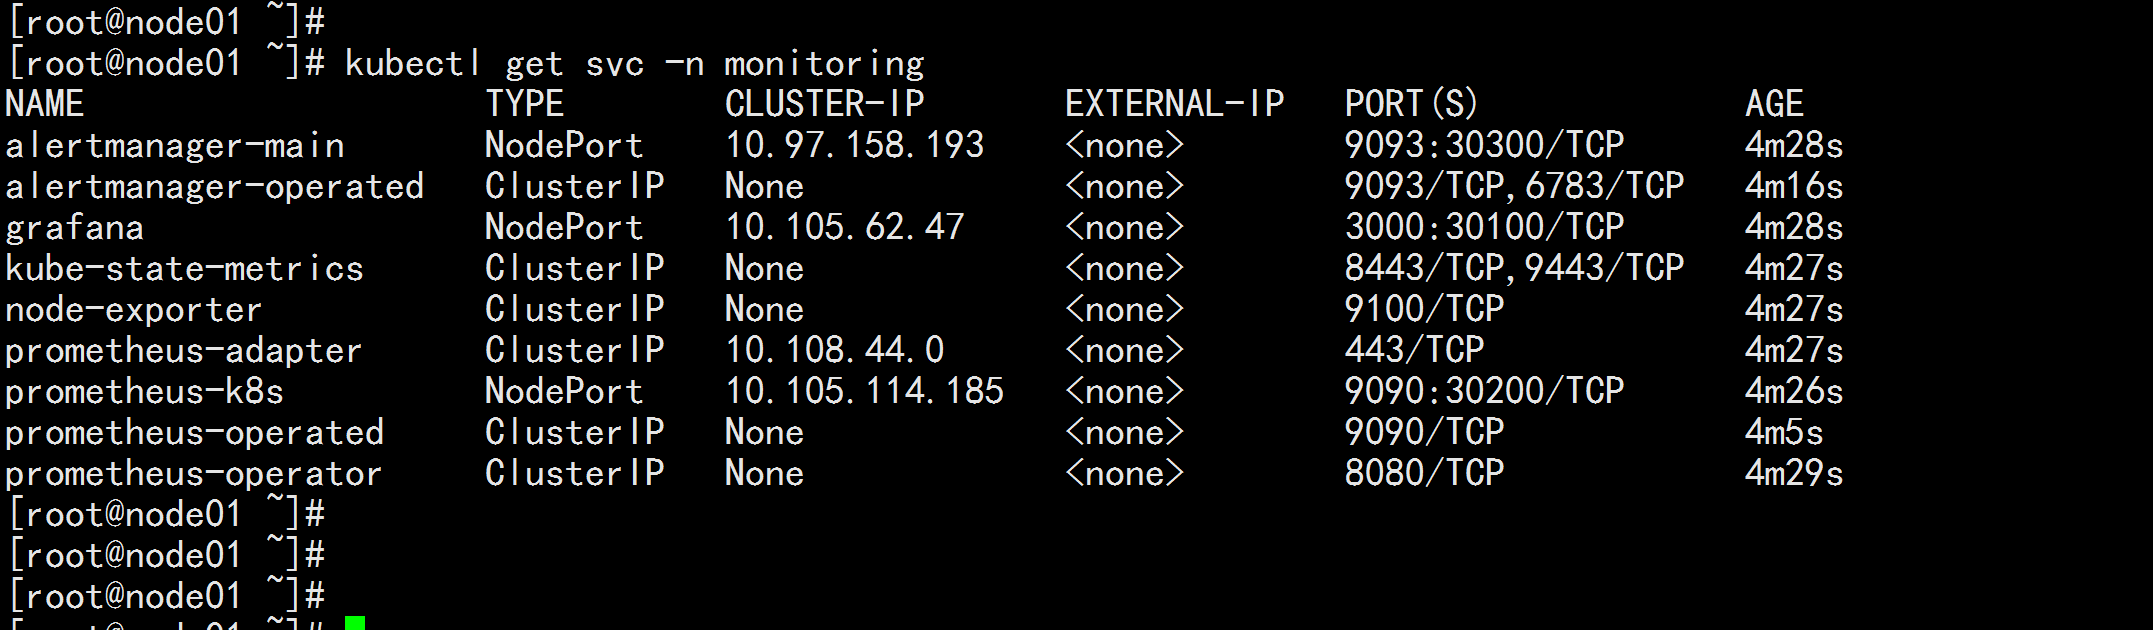
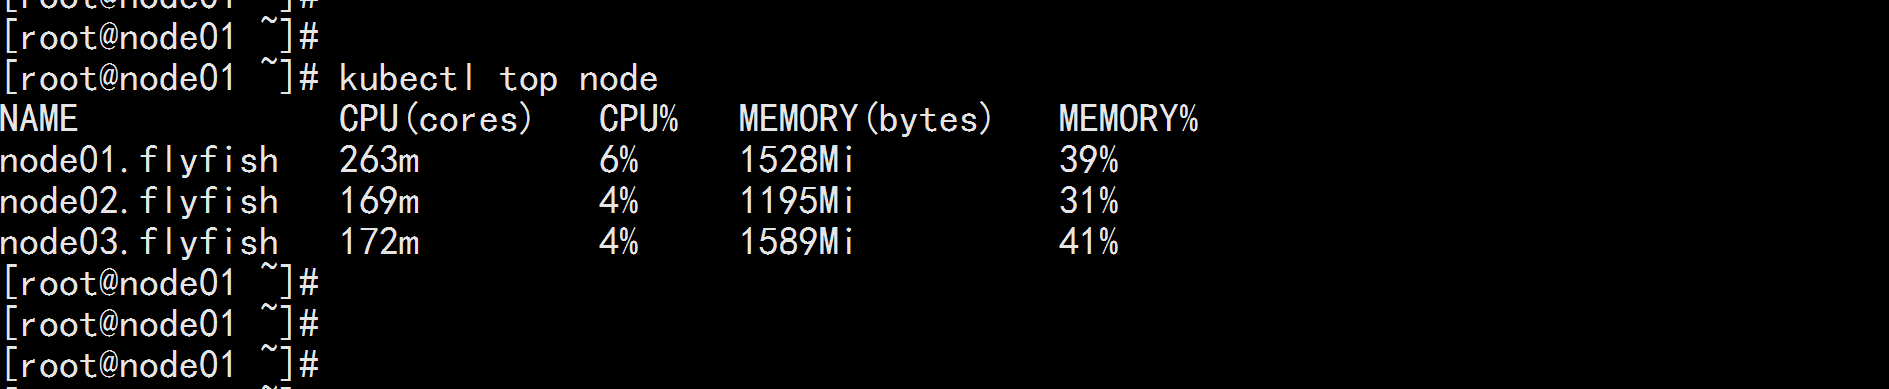
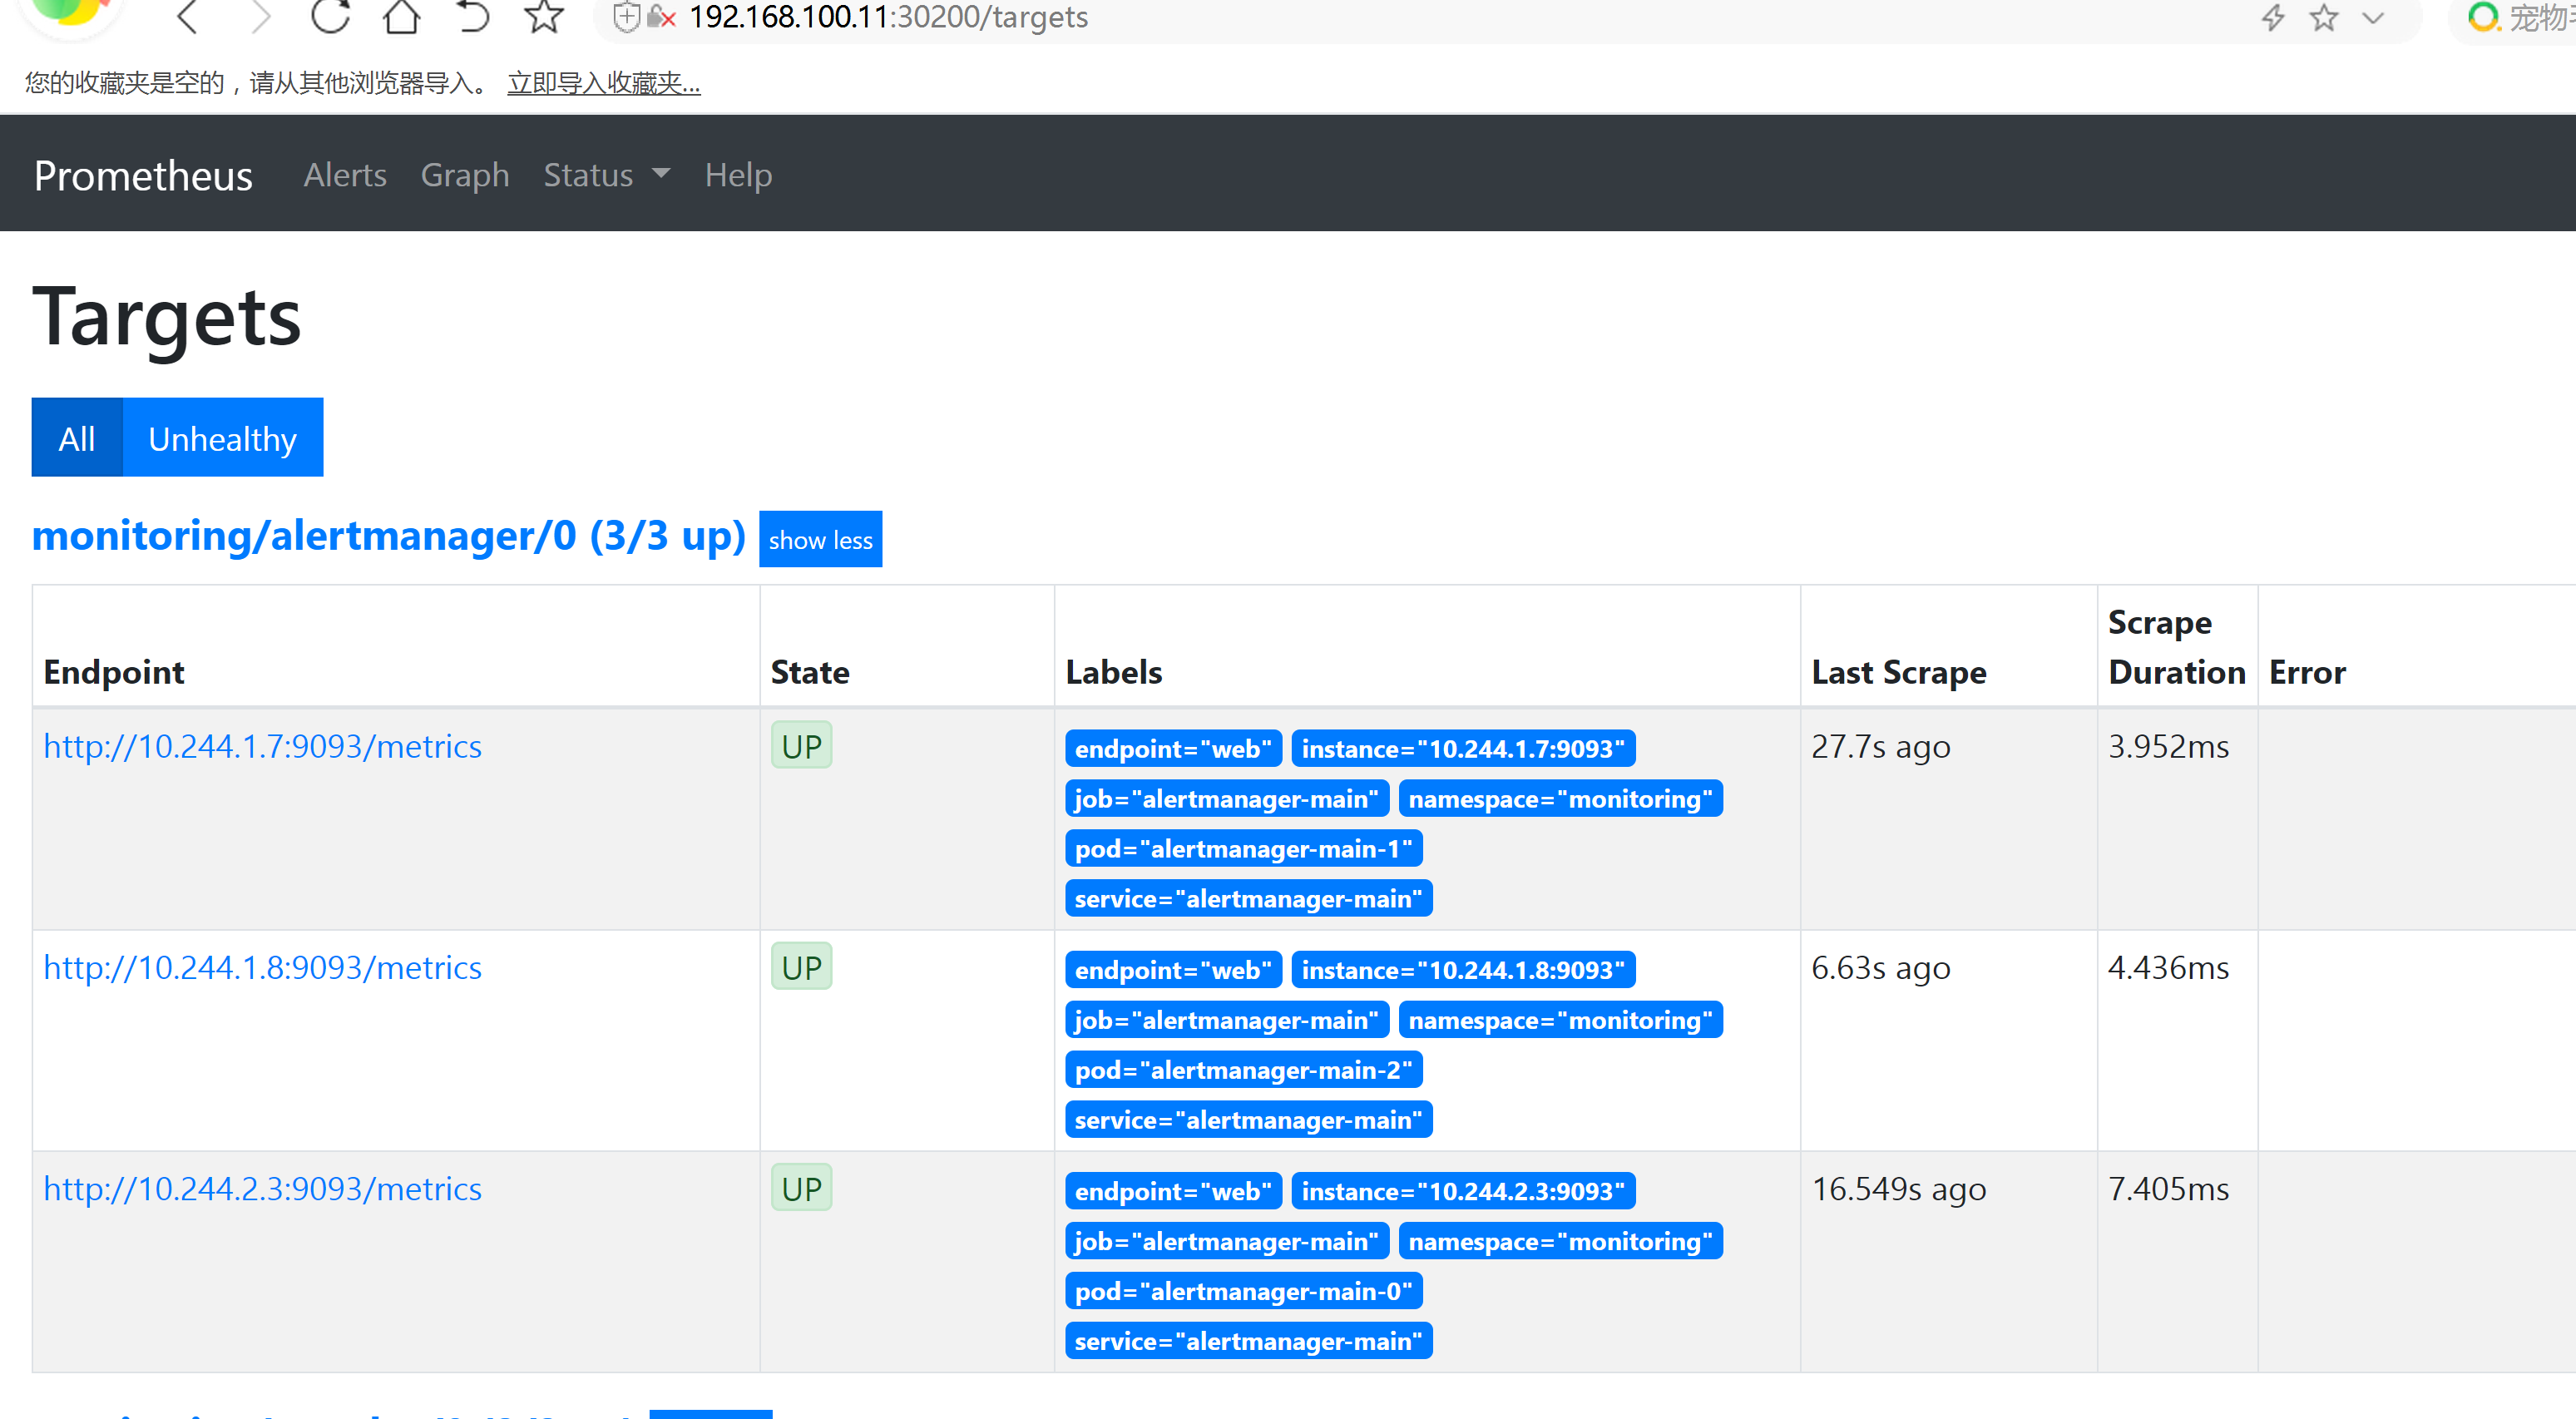
prometheus 对应的 nodeport 端口为 30200,访问 http://MasterIP:30200http://192.168.100.11:30200/graph
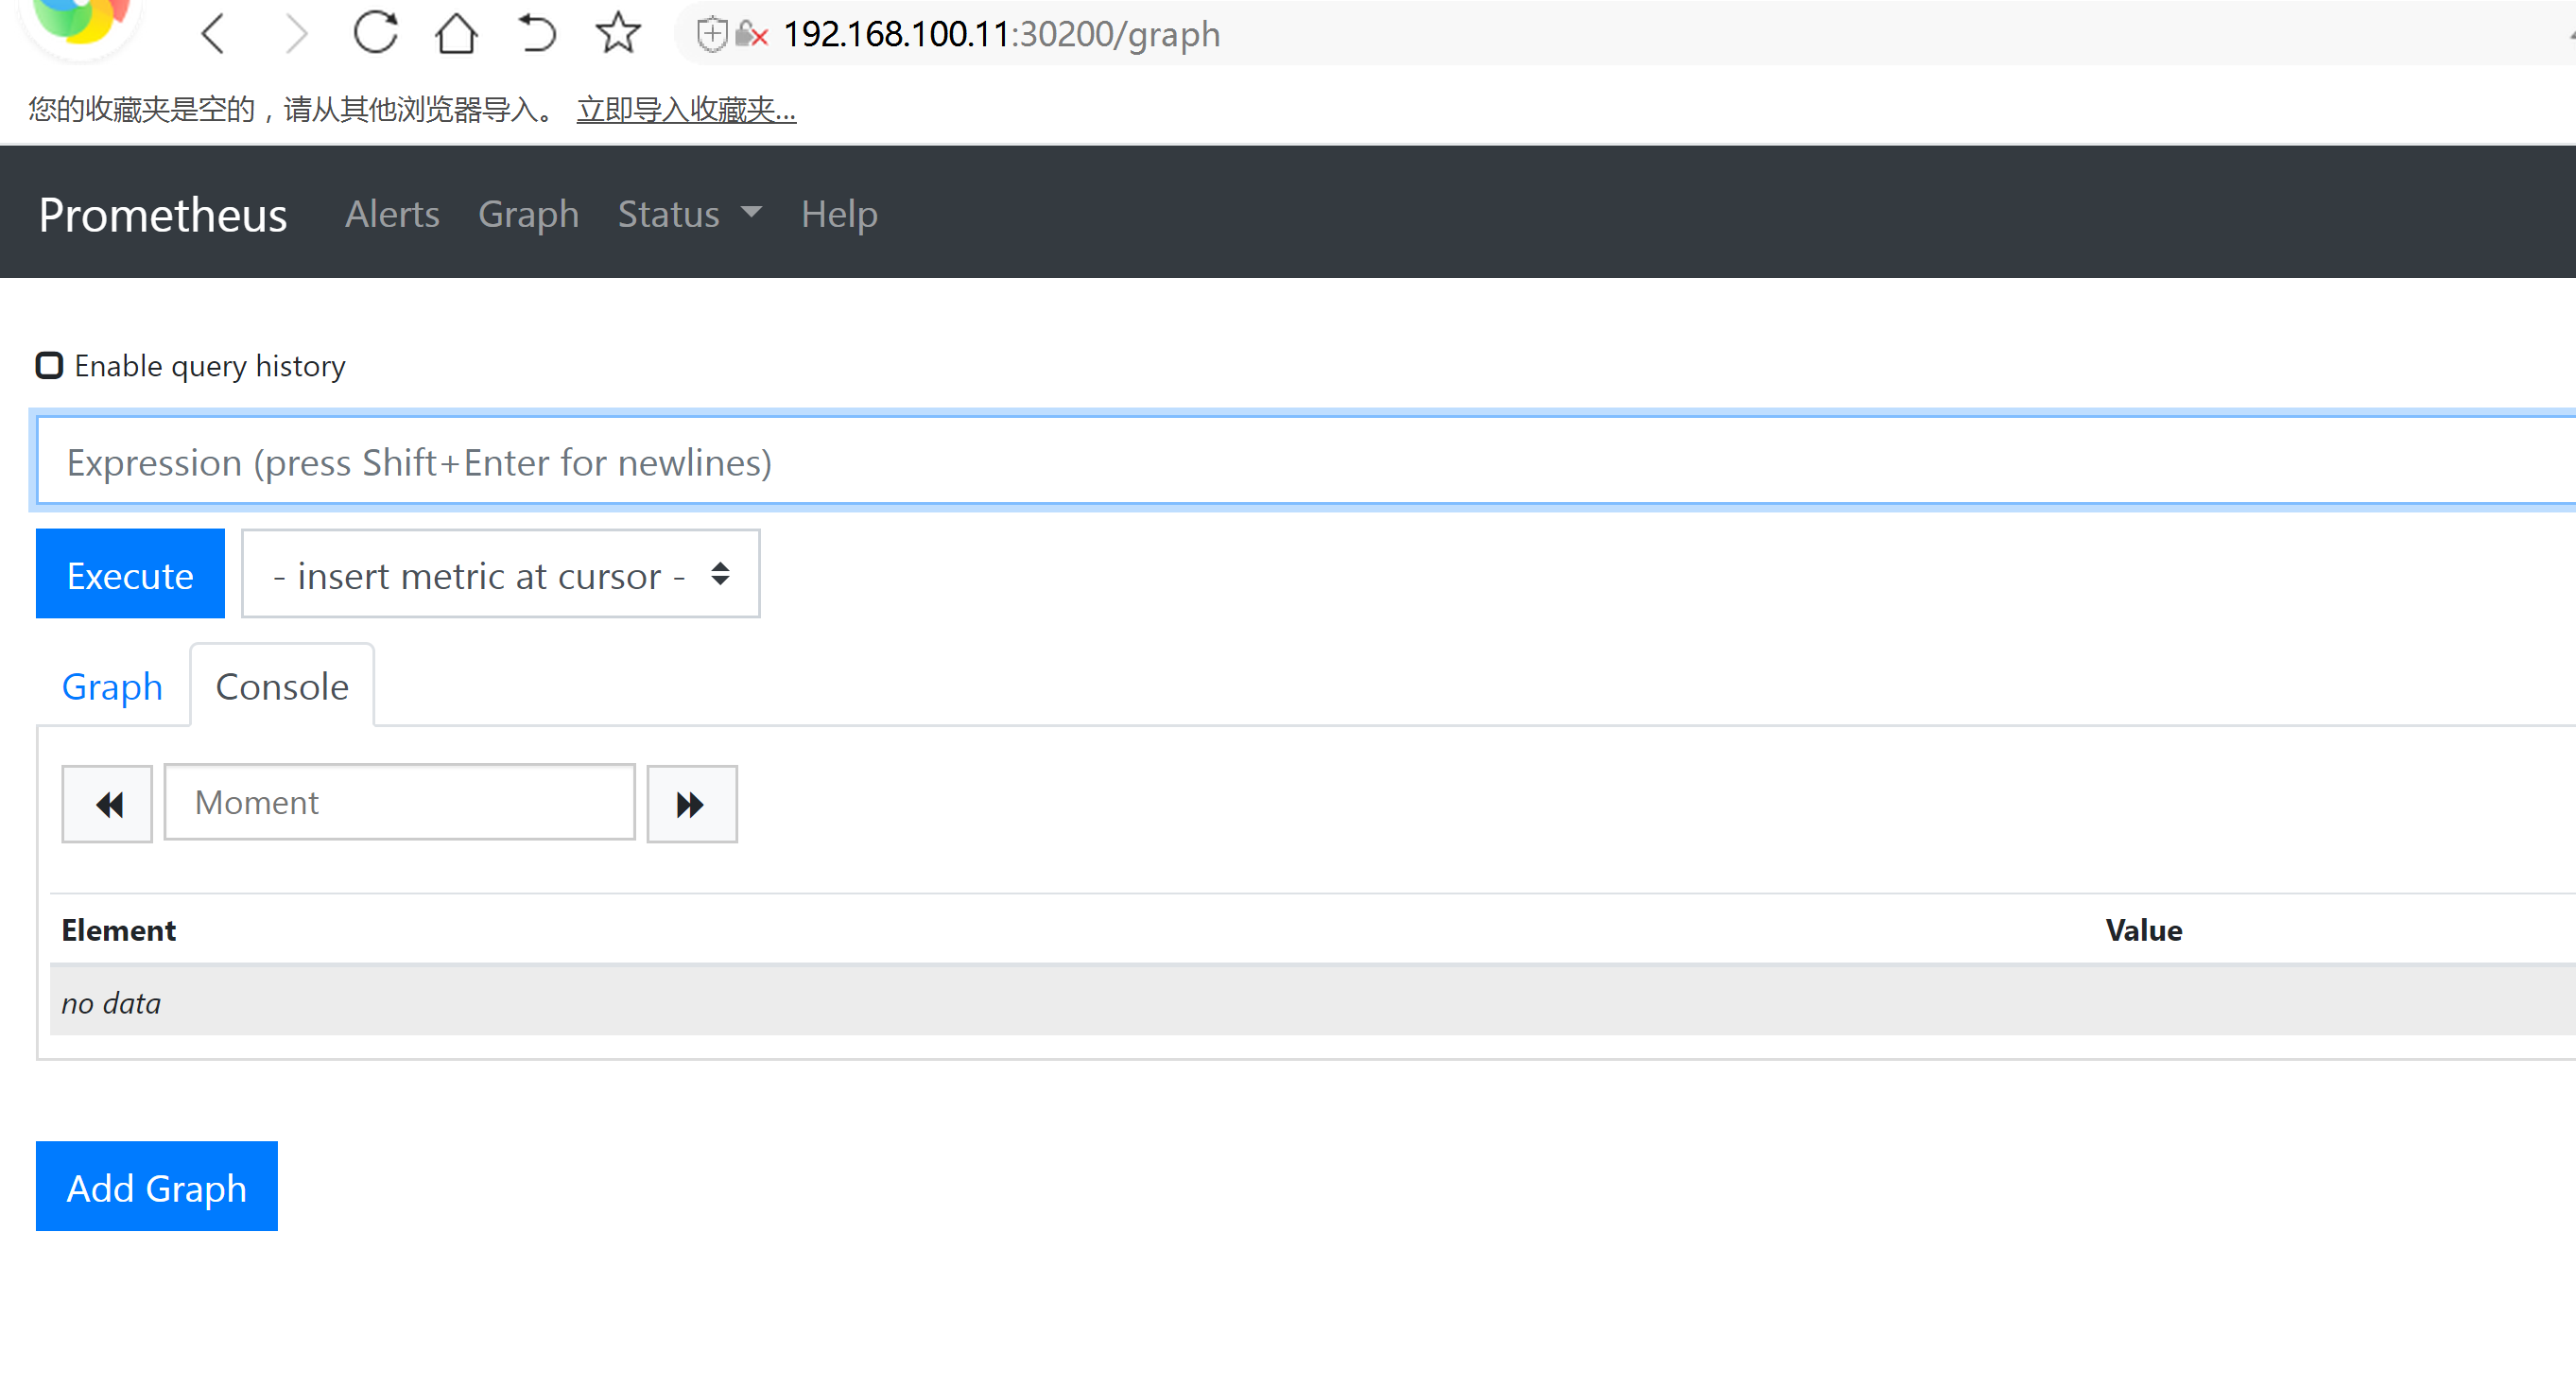
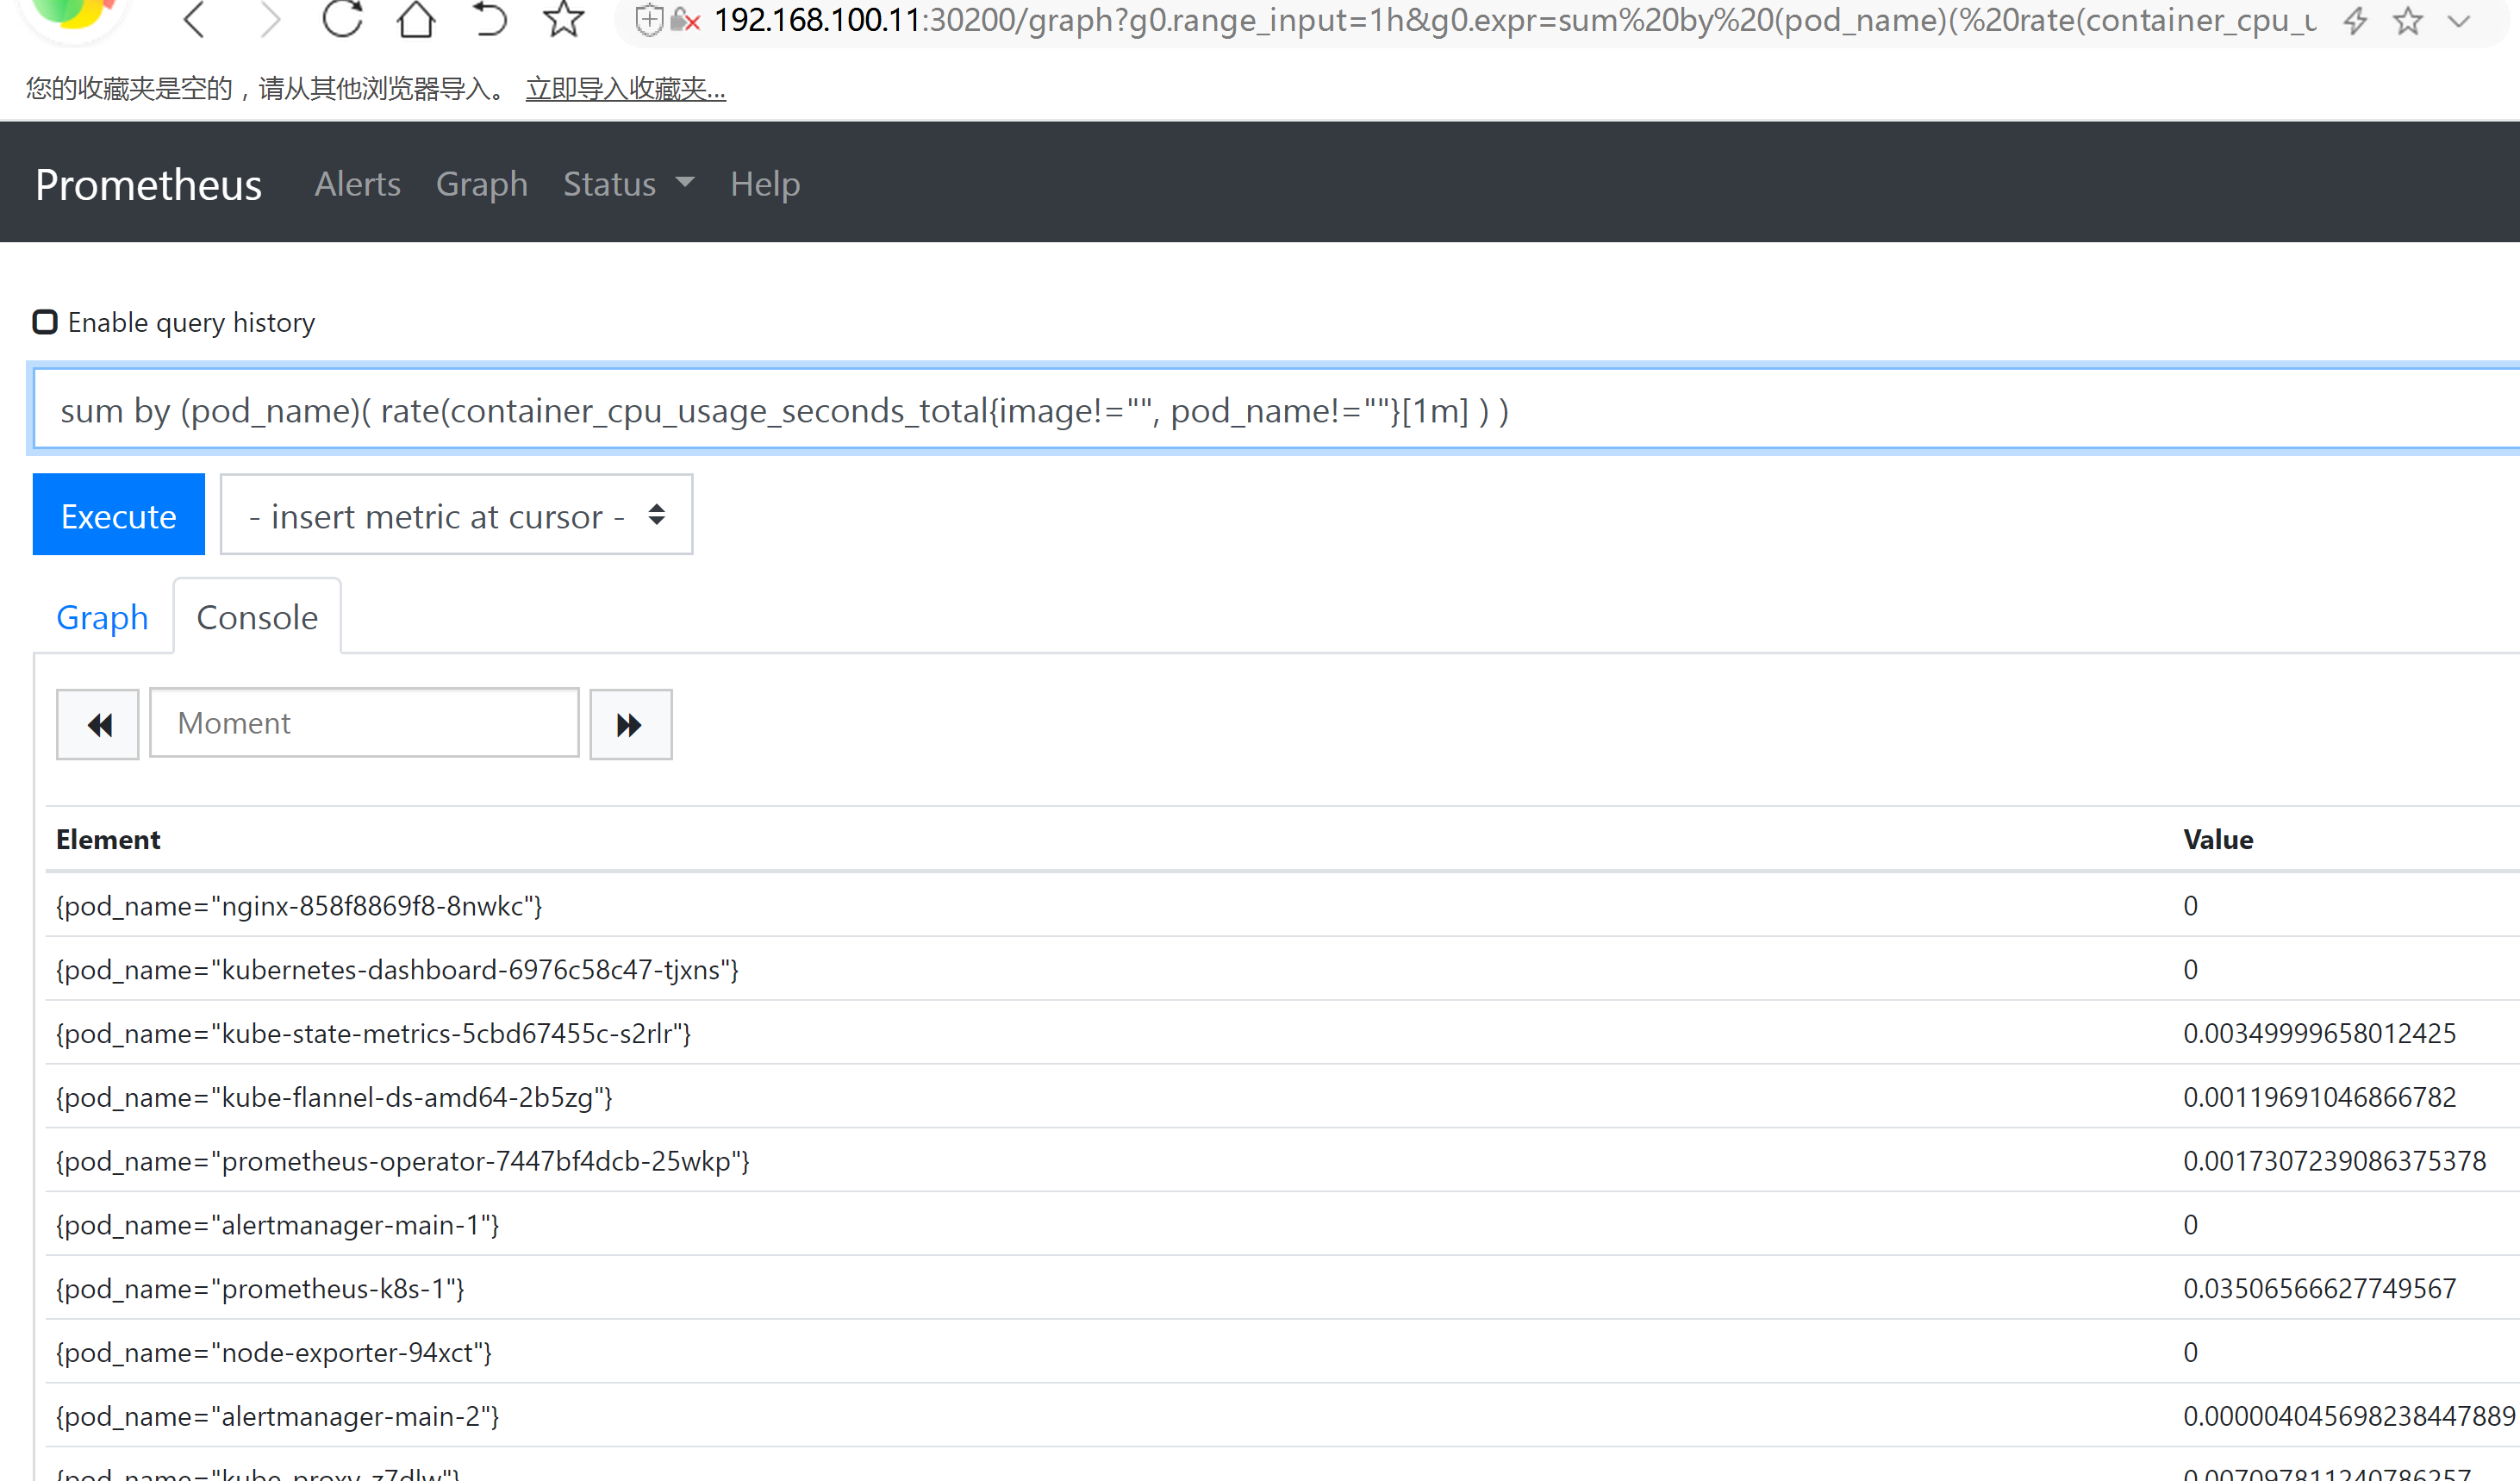
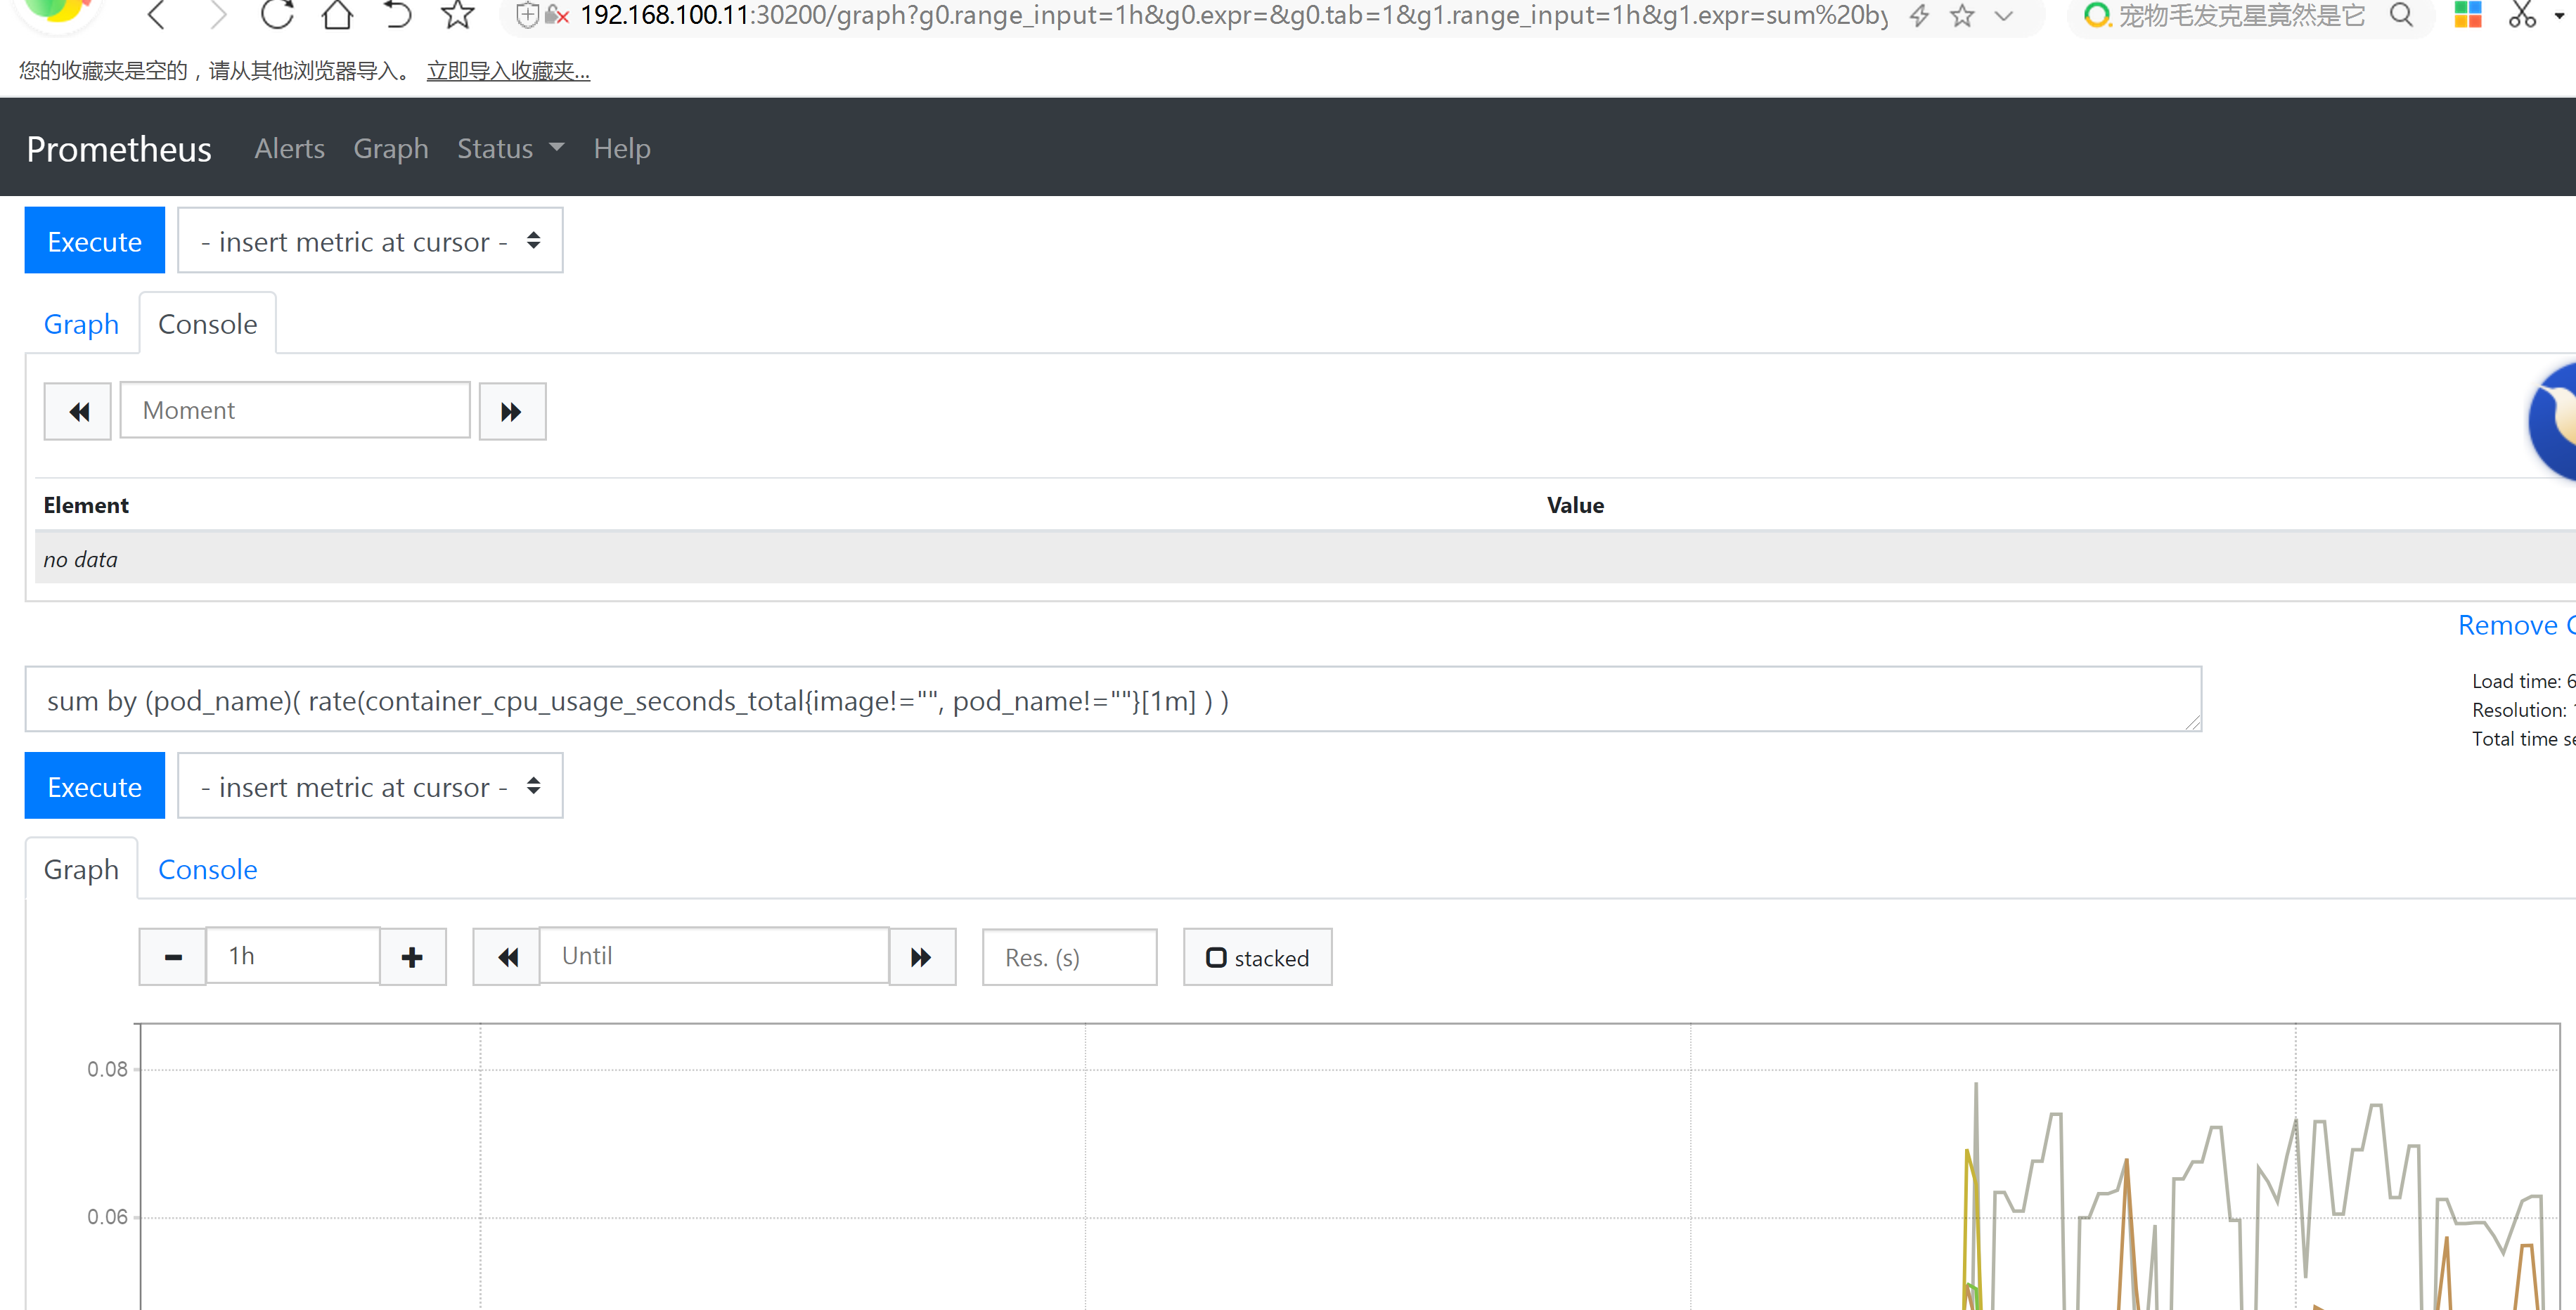
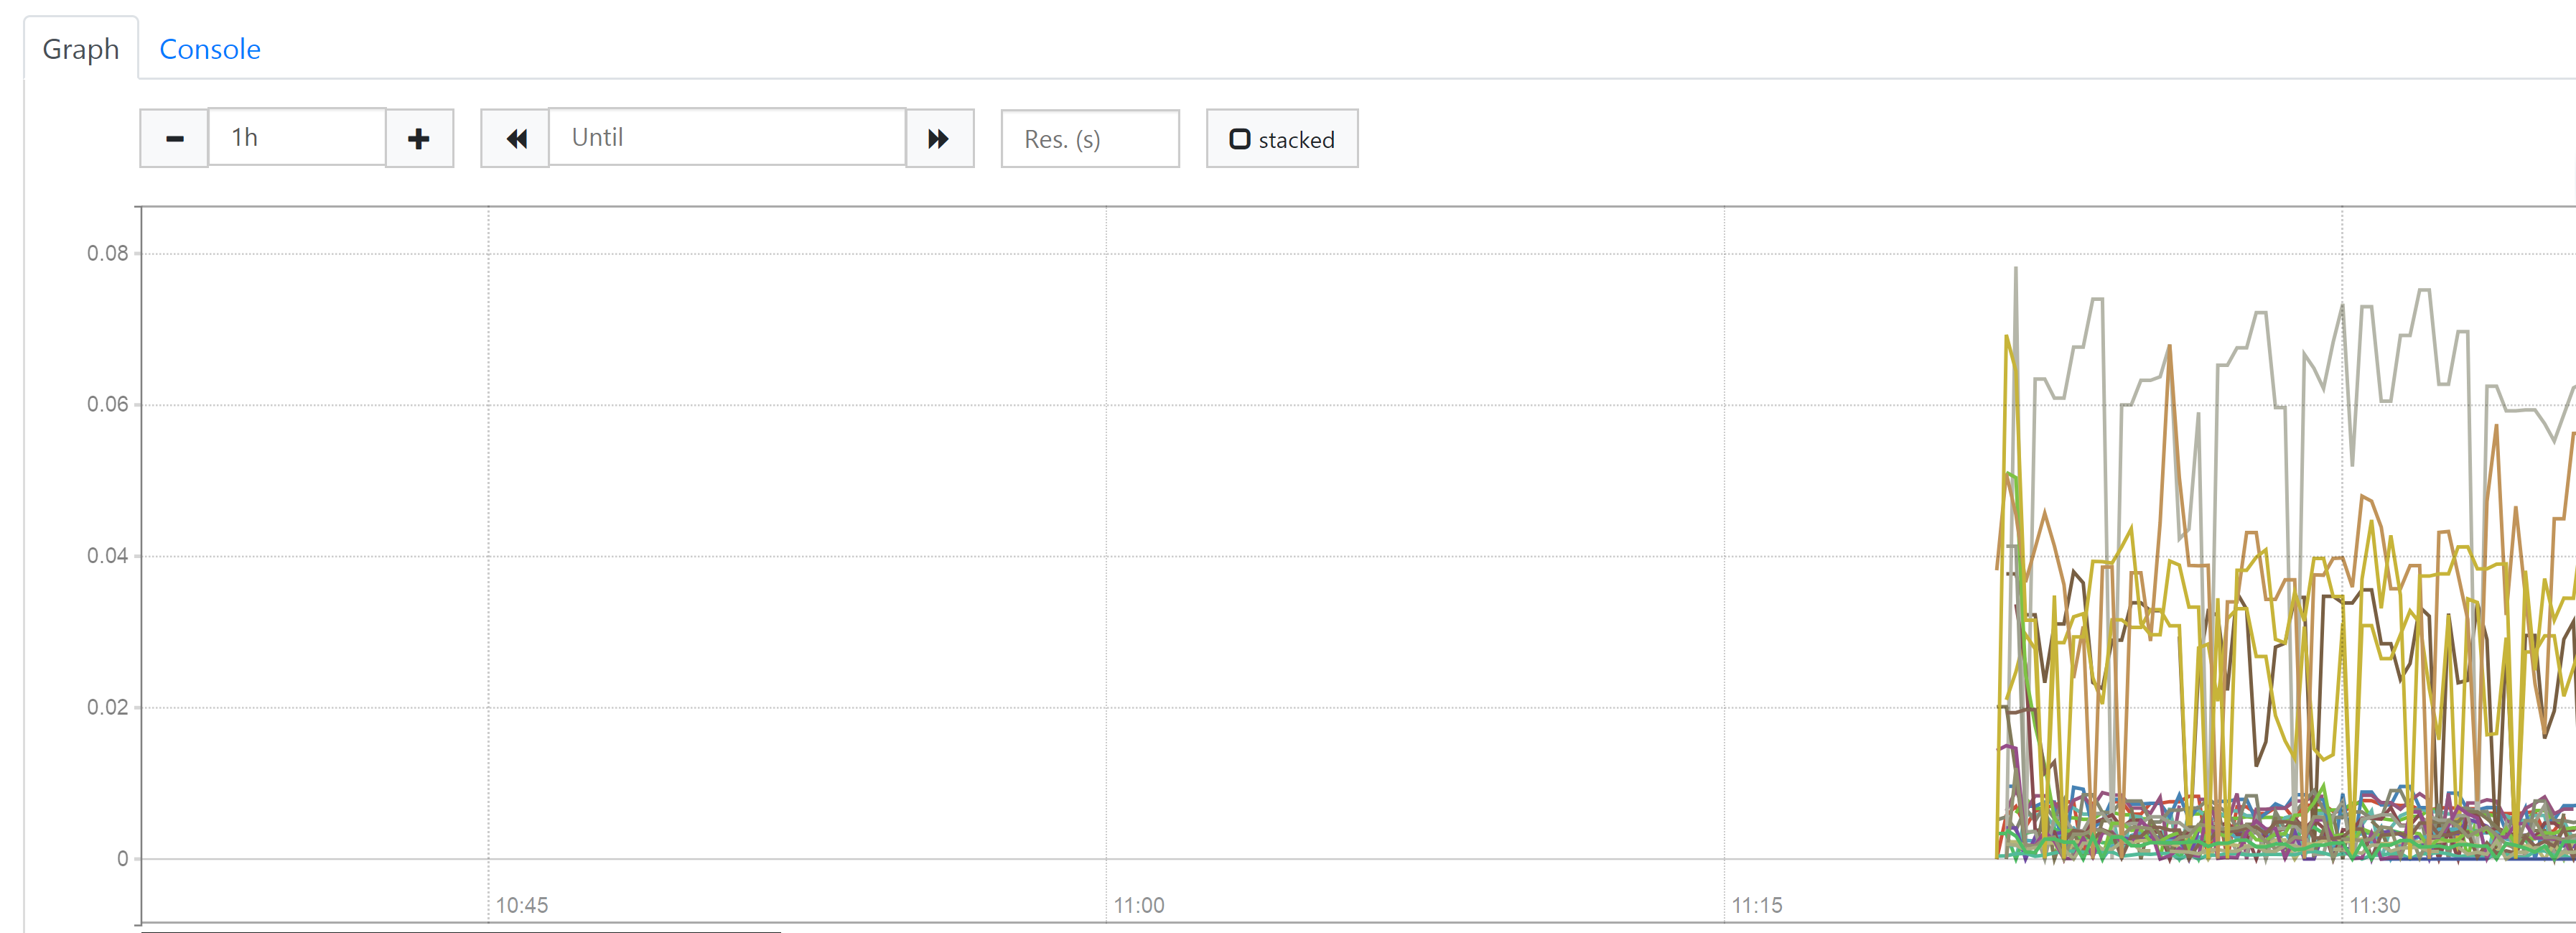
prometheus 的 WEB 界面上提供了基本的查询 K8S 集群中每个 POD 的 CPU 使用情况,查询条件如下:sum by (pod_name)( rate(container_cpu_usage_seconds_total{image!="", pod_name!=""}[1m] ) )
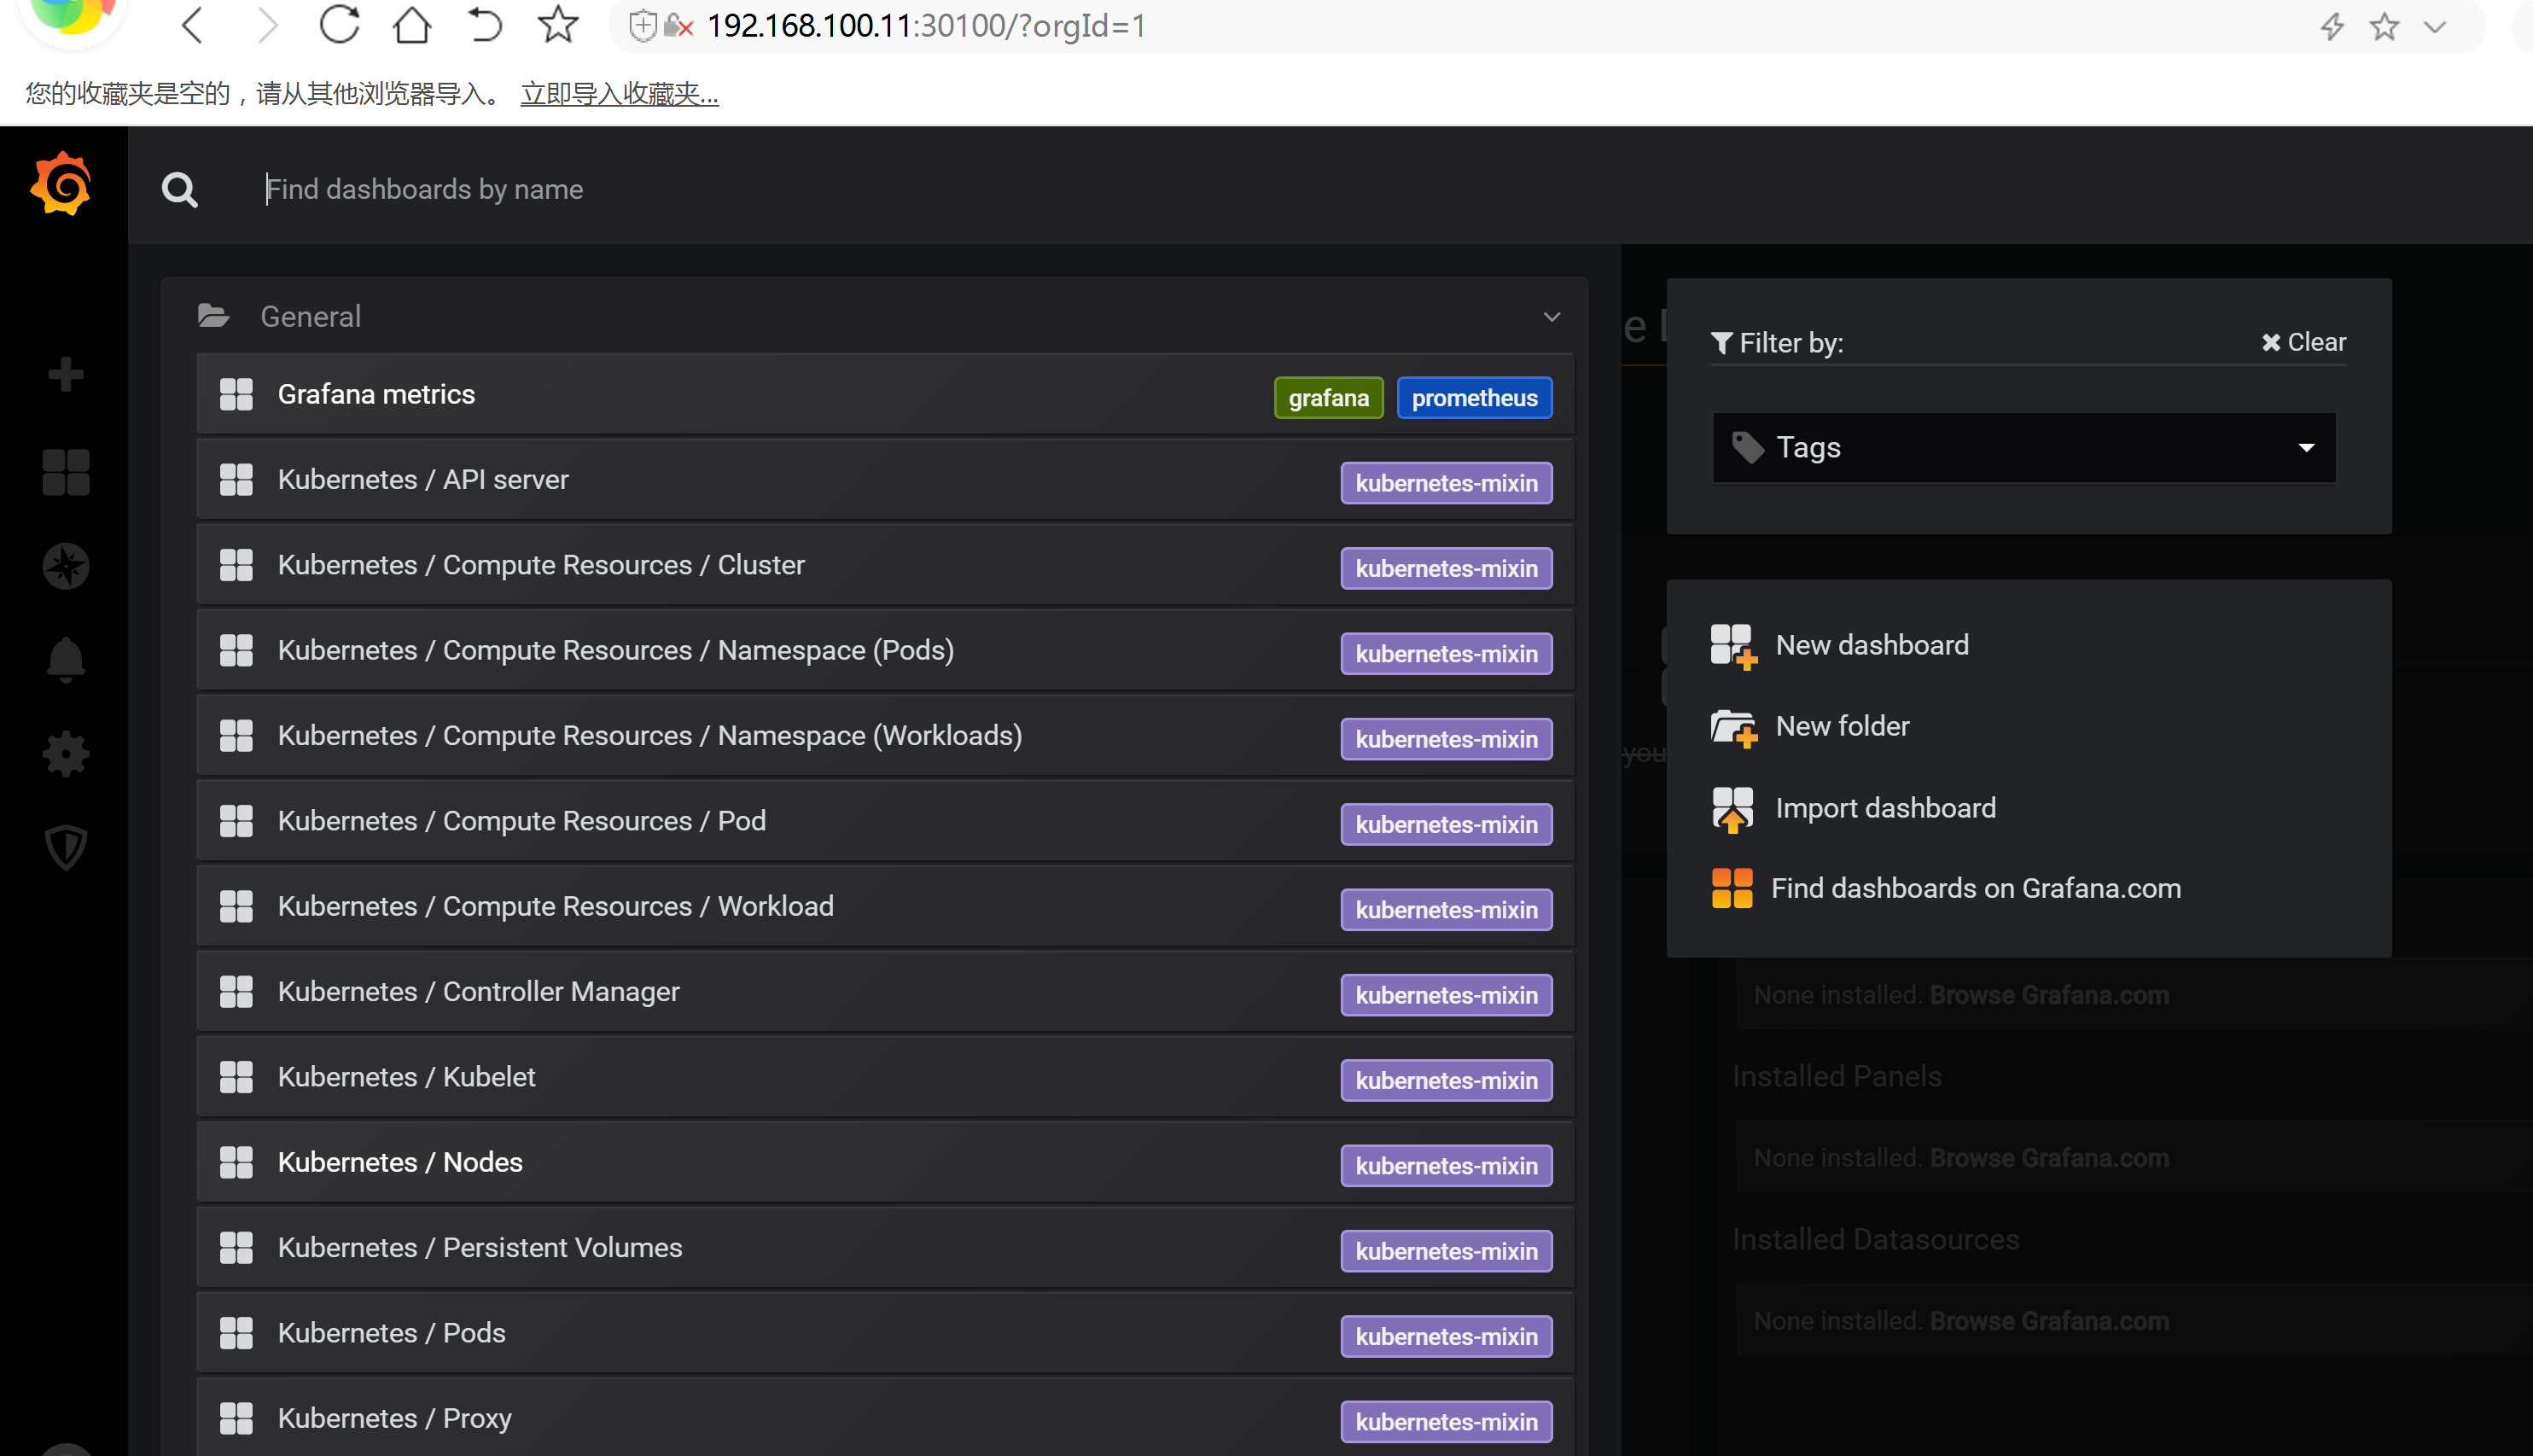
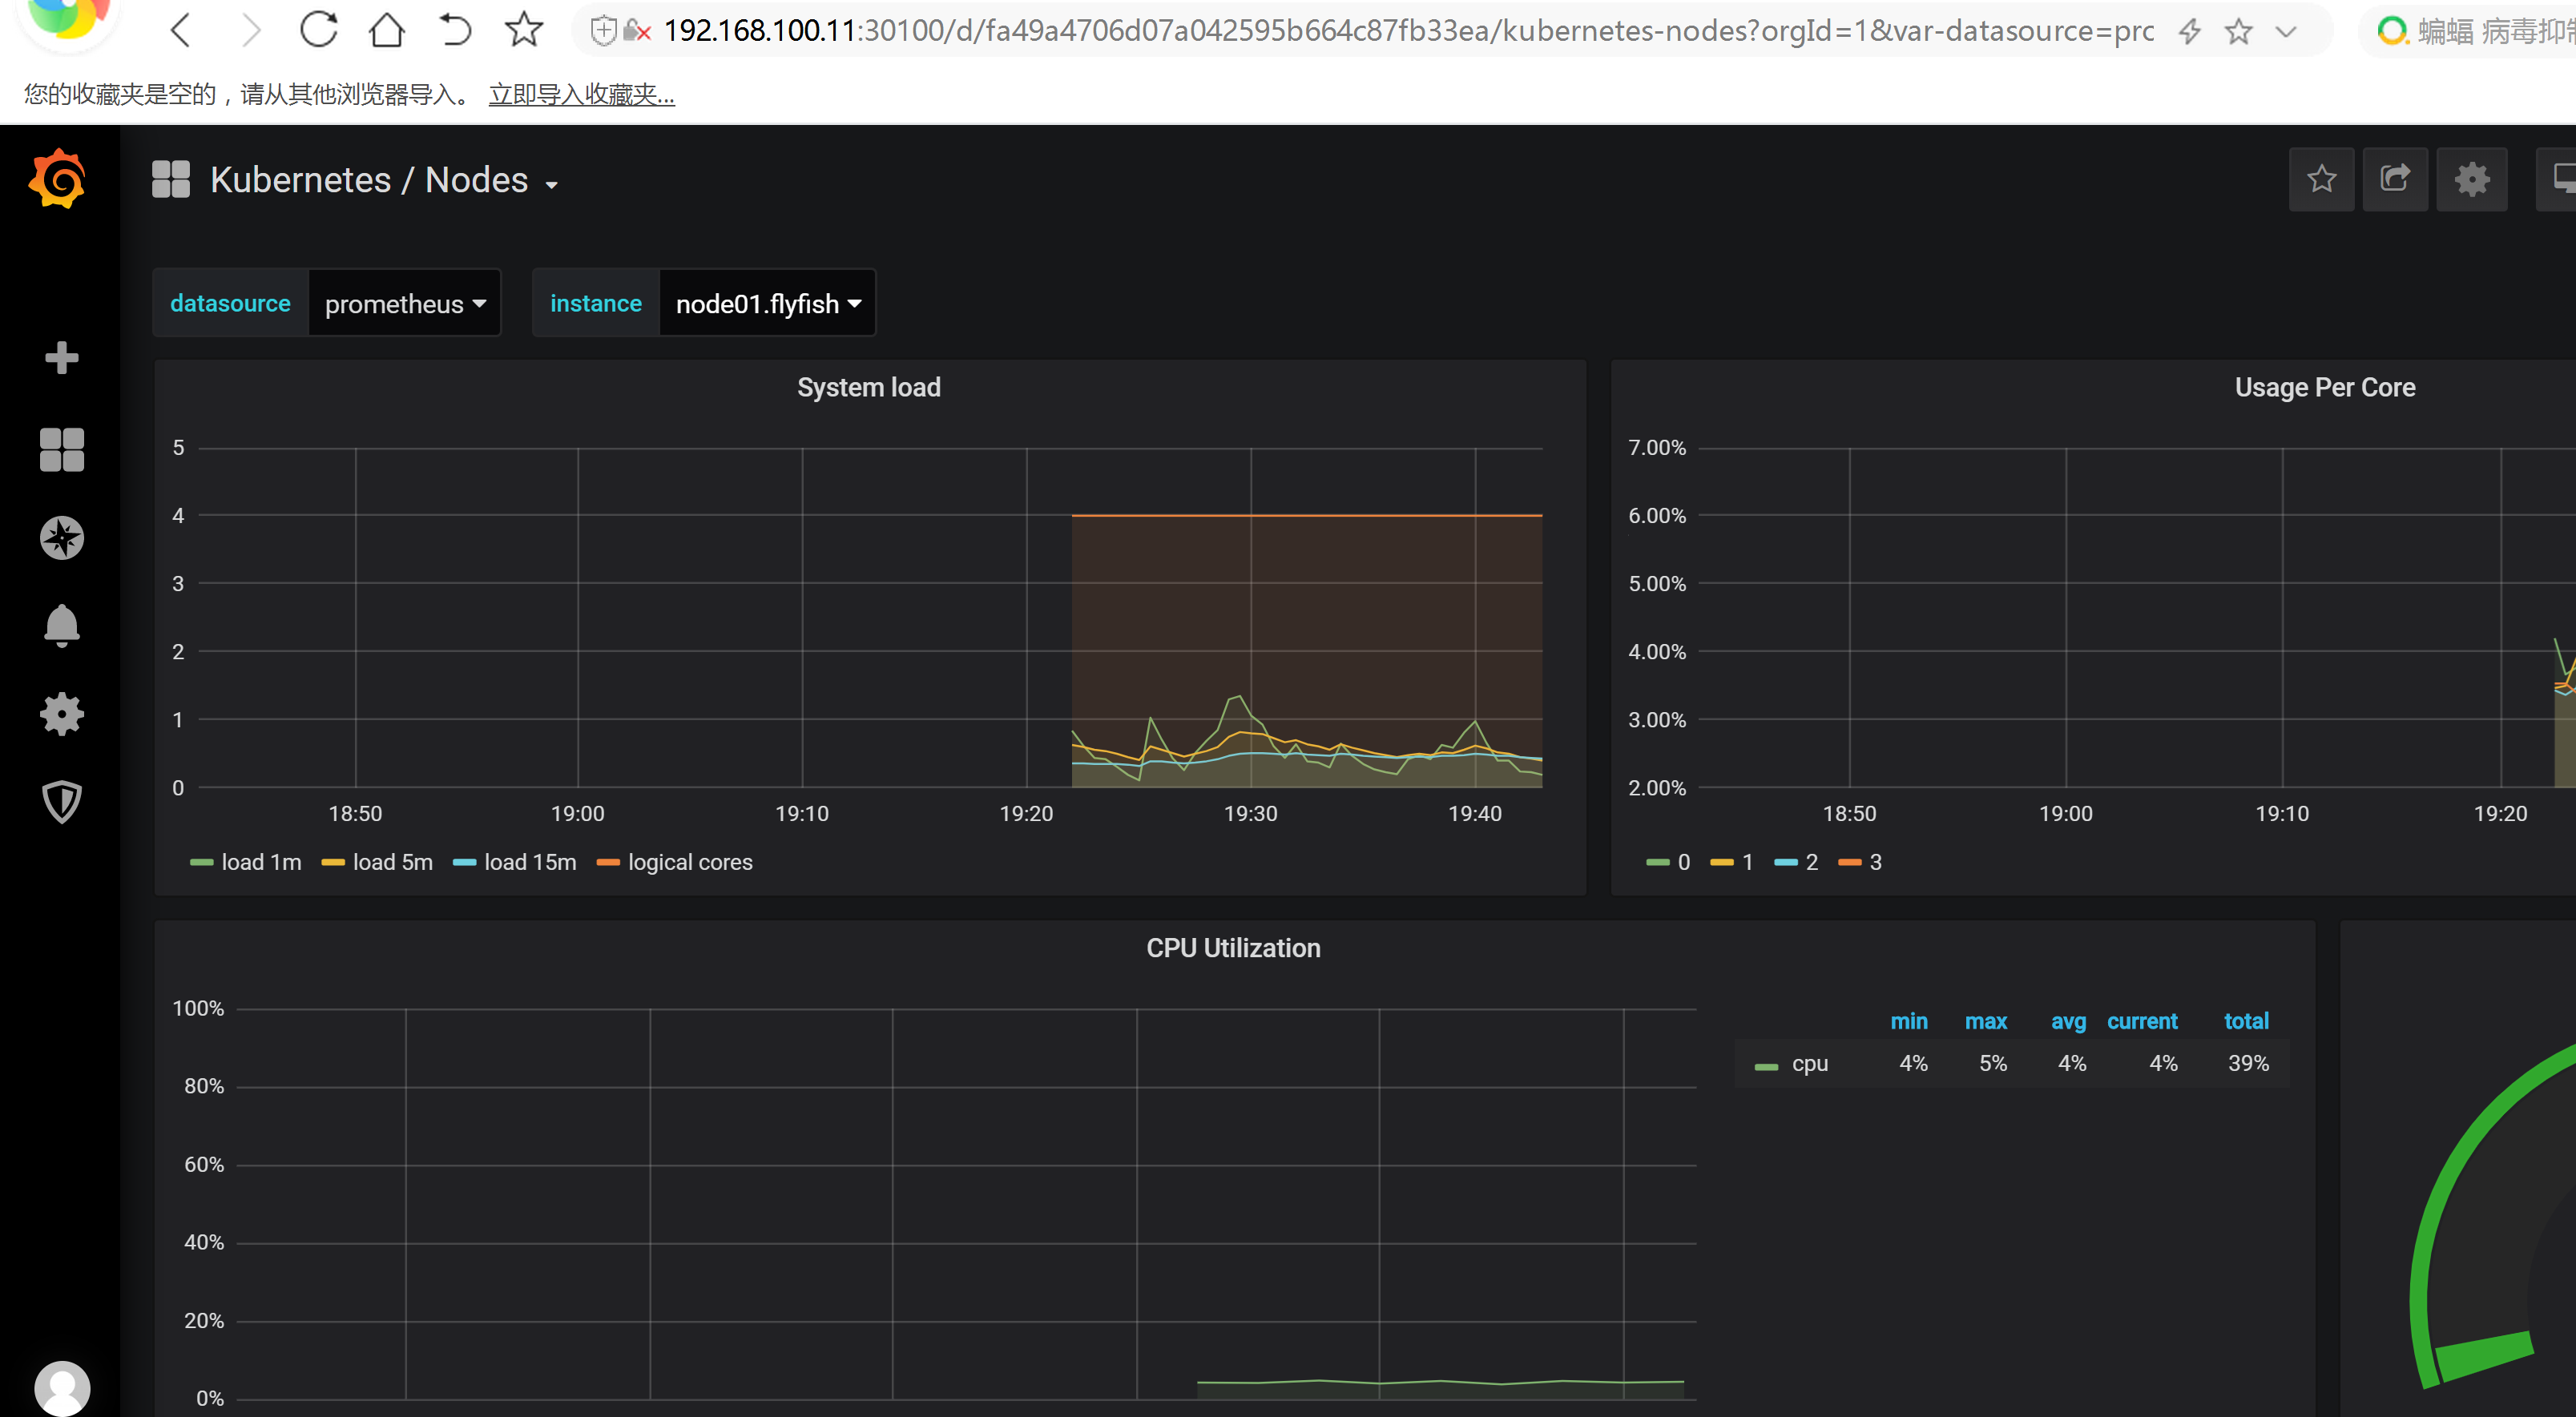
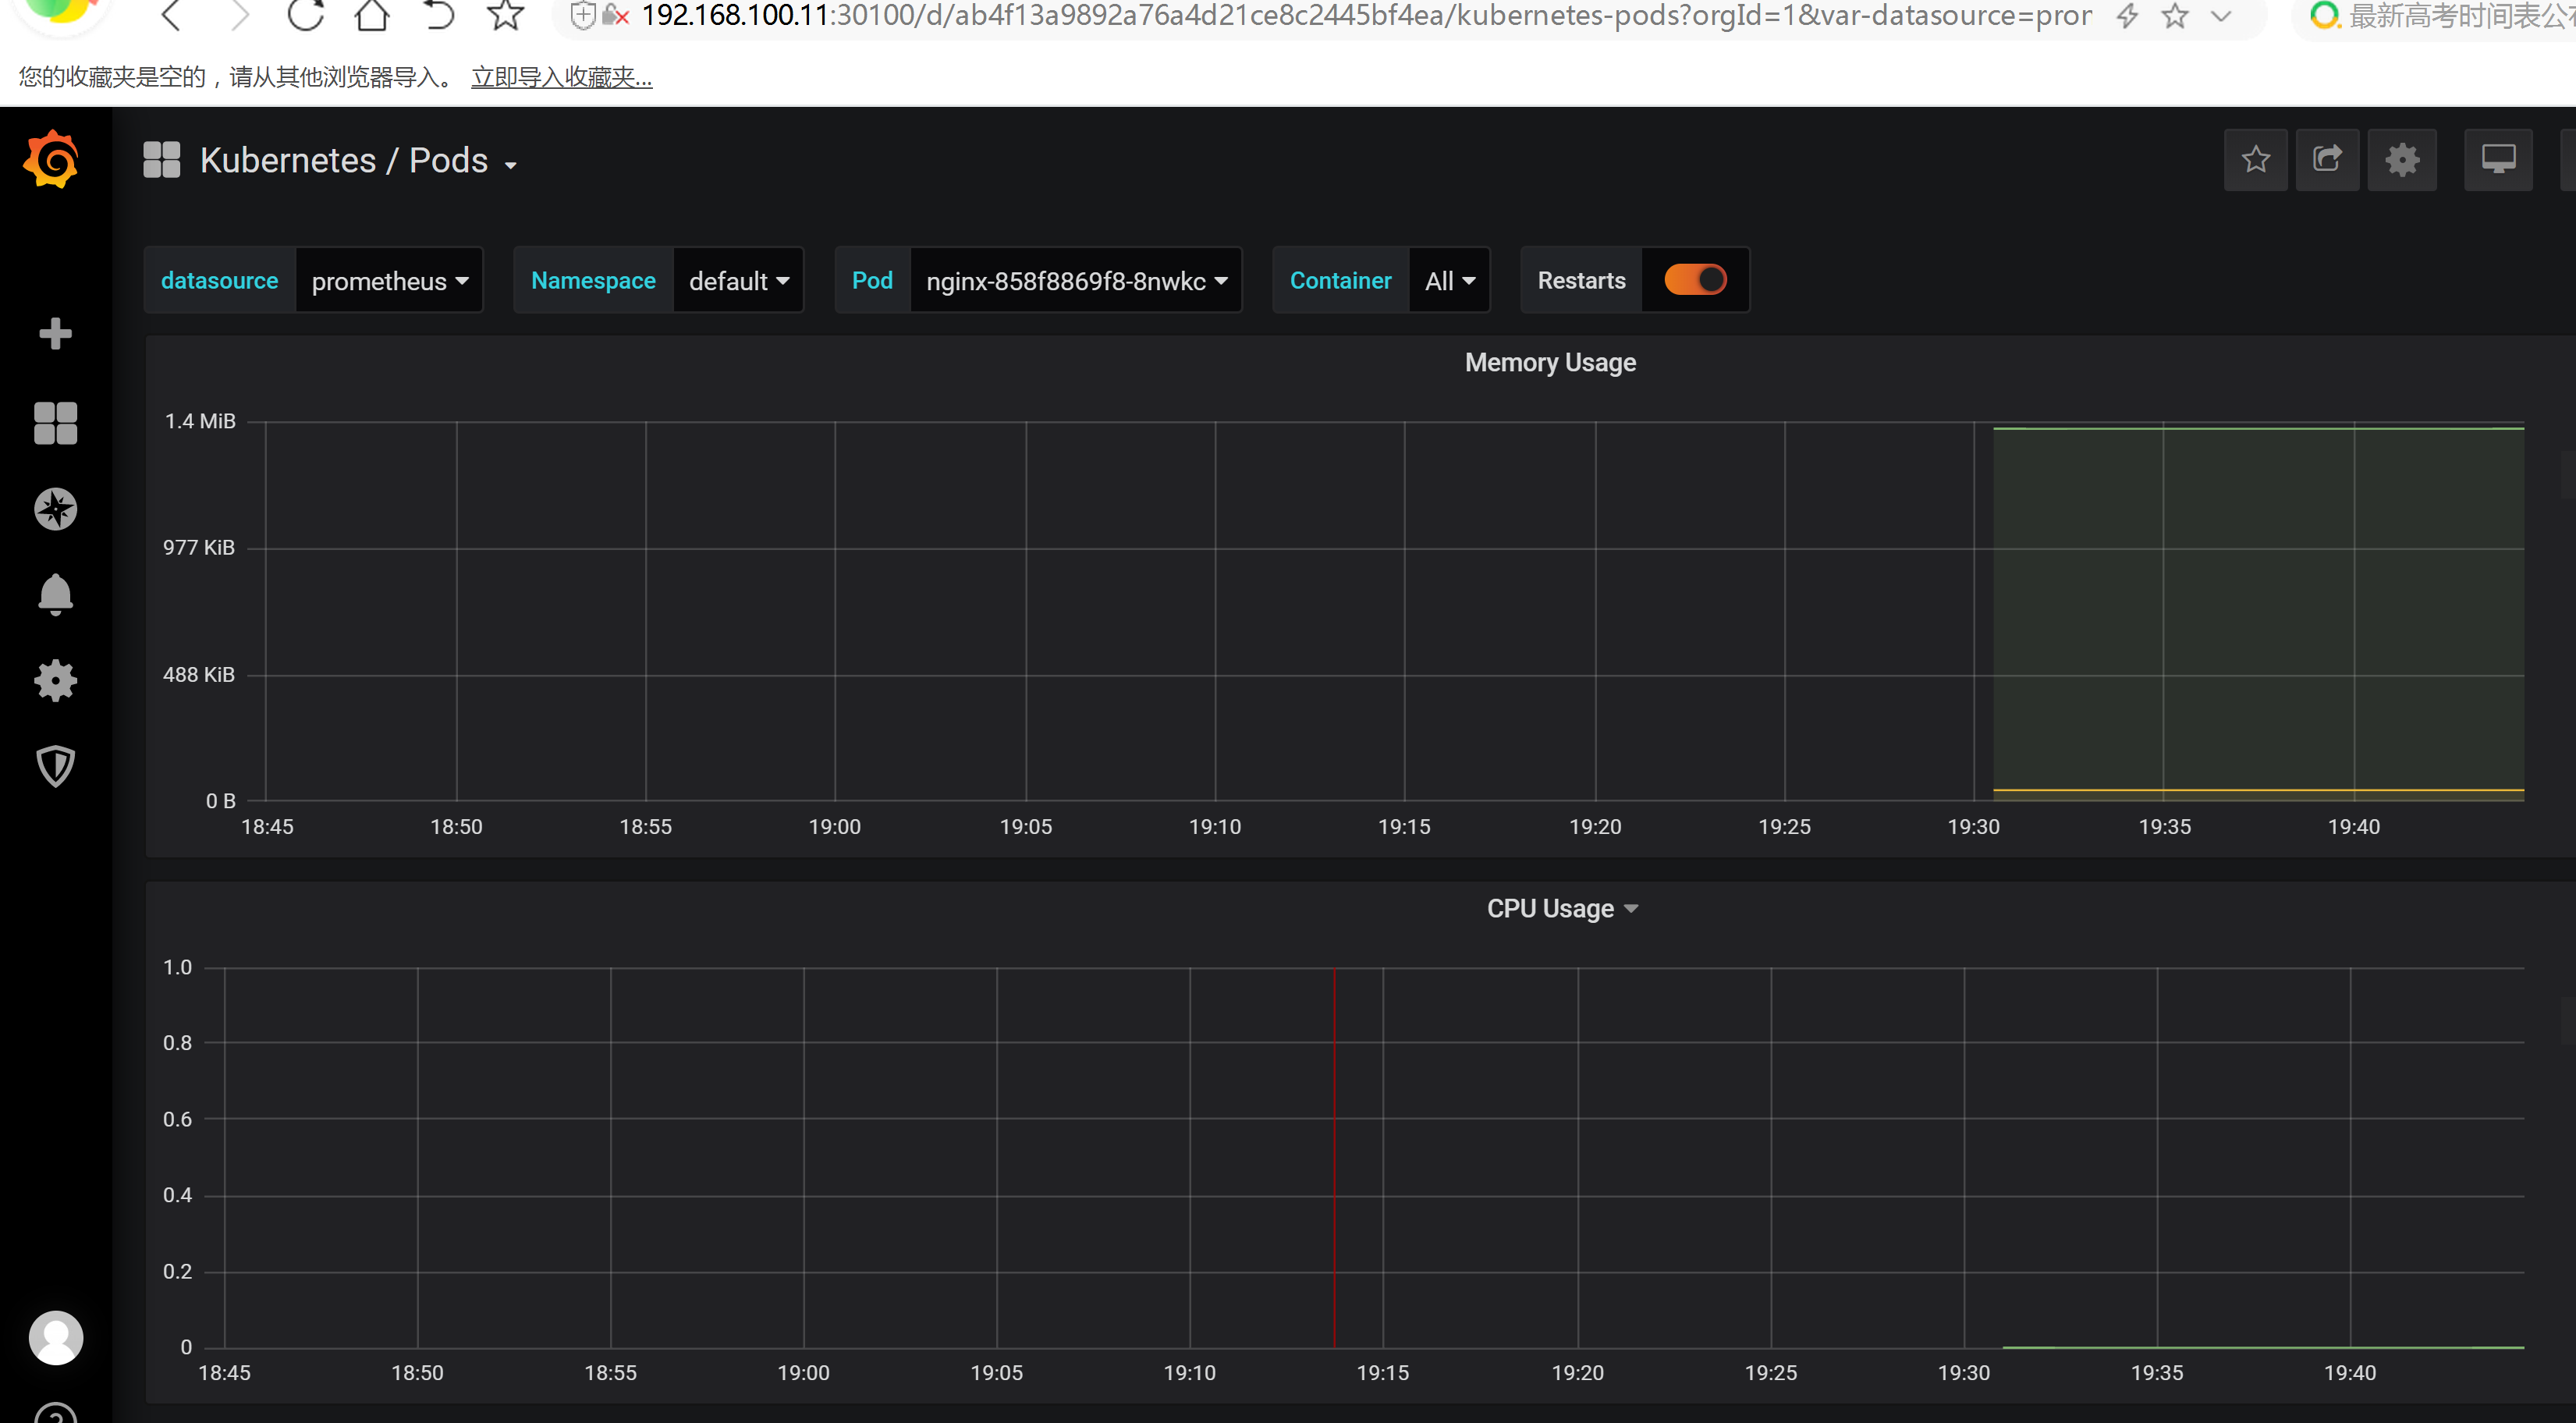
查看 grafana 服务暴露的端口号:kubectl get service -n monitoring | grep grafanagrafana NodePort 10.107.56.143 <none> 3000:30100/TCP 20h
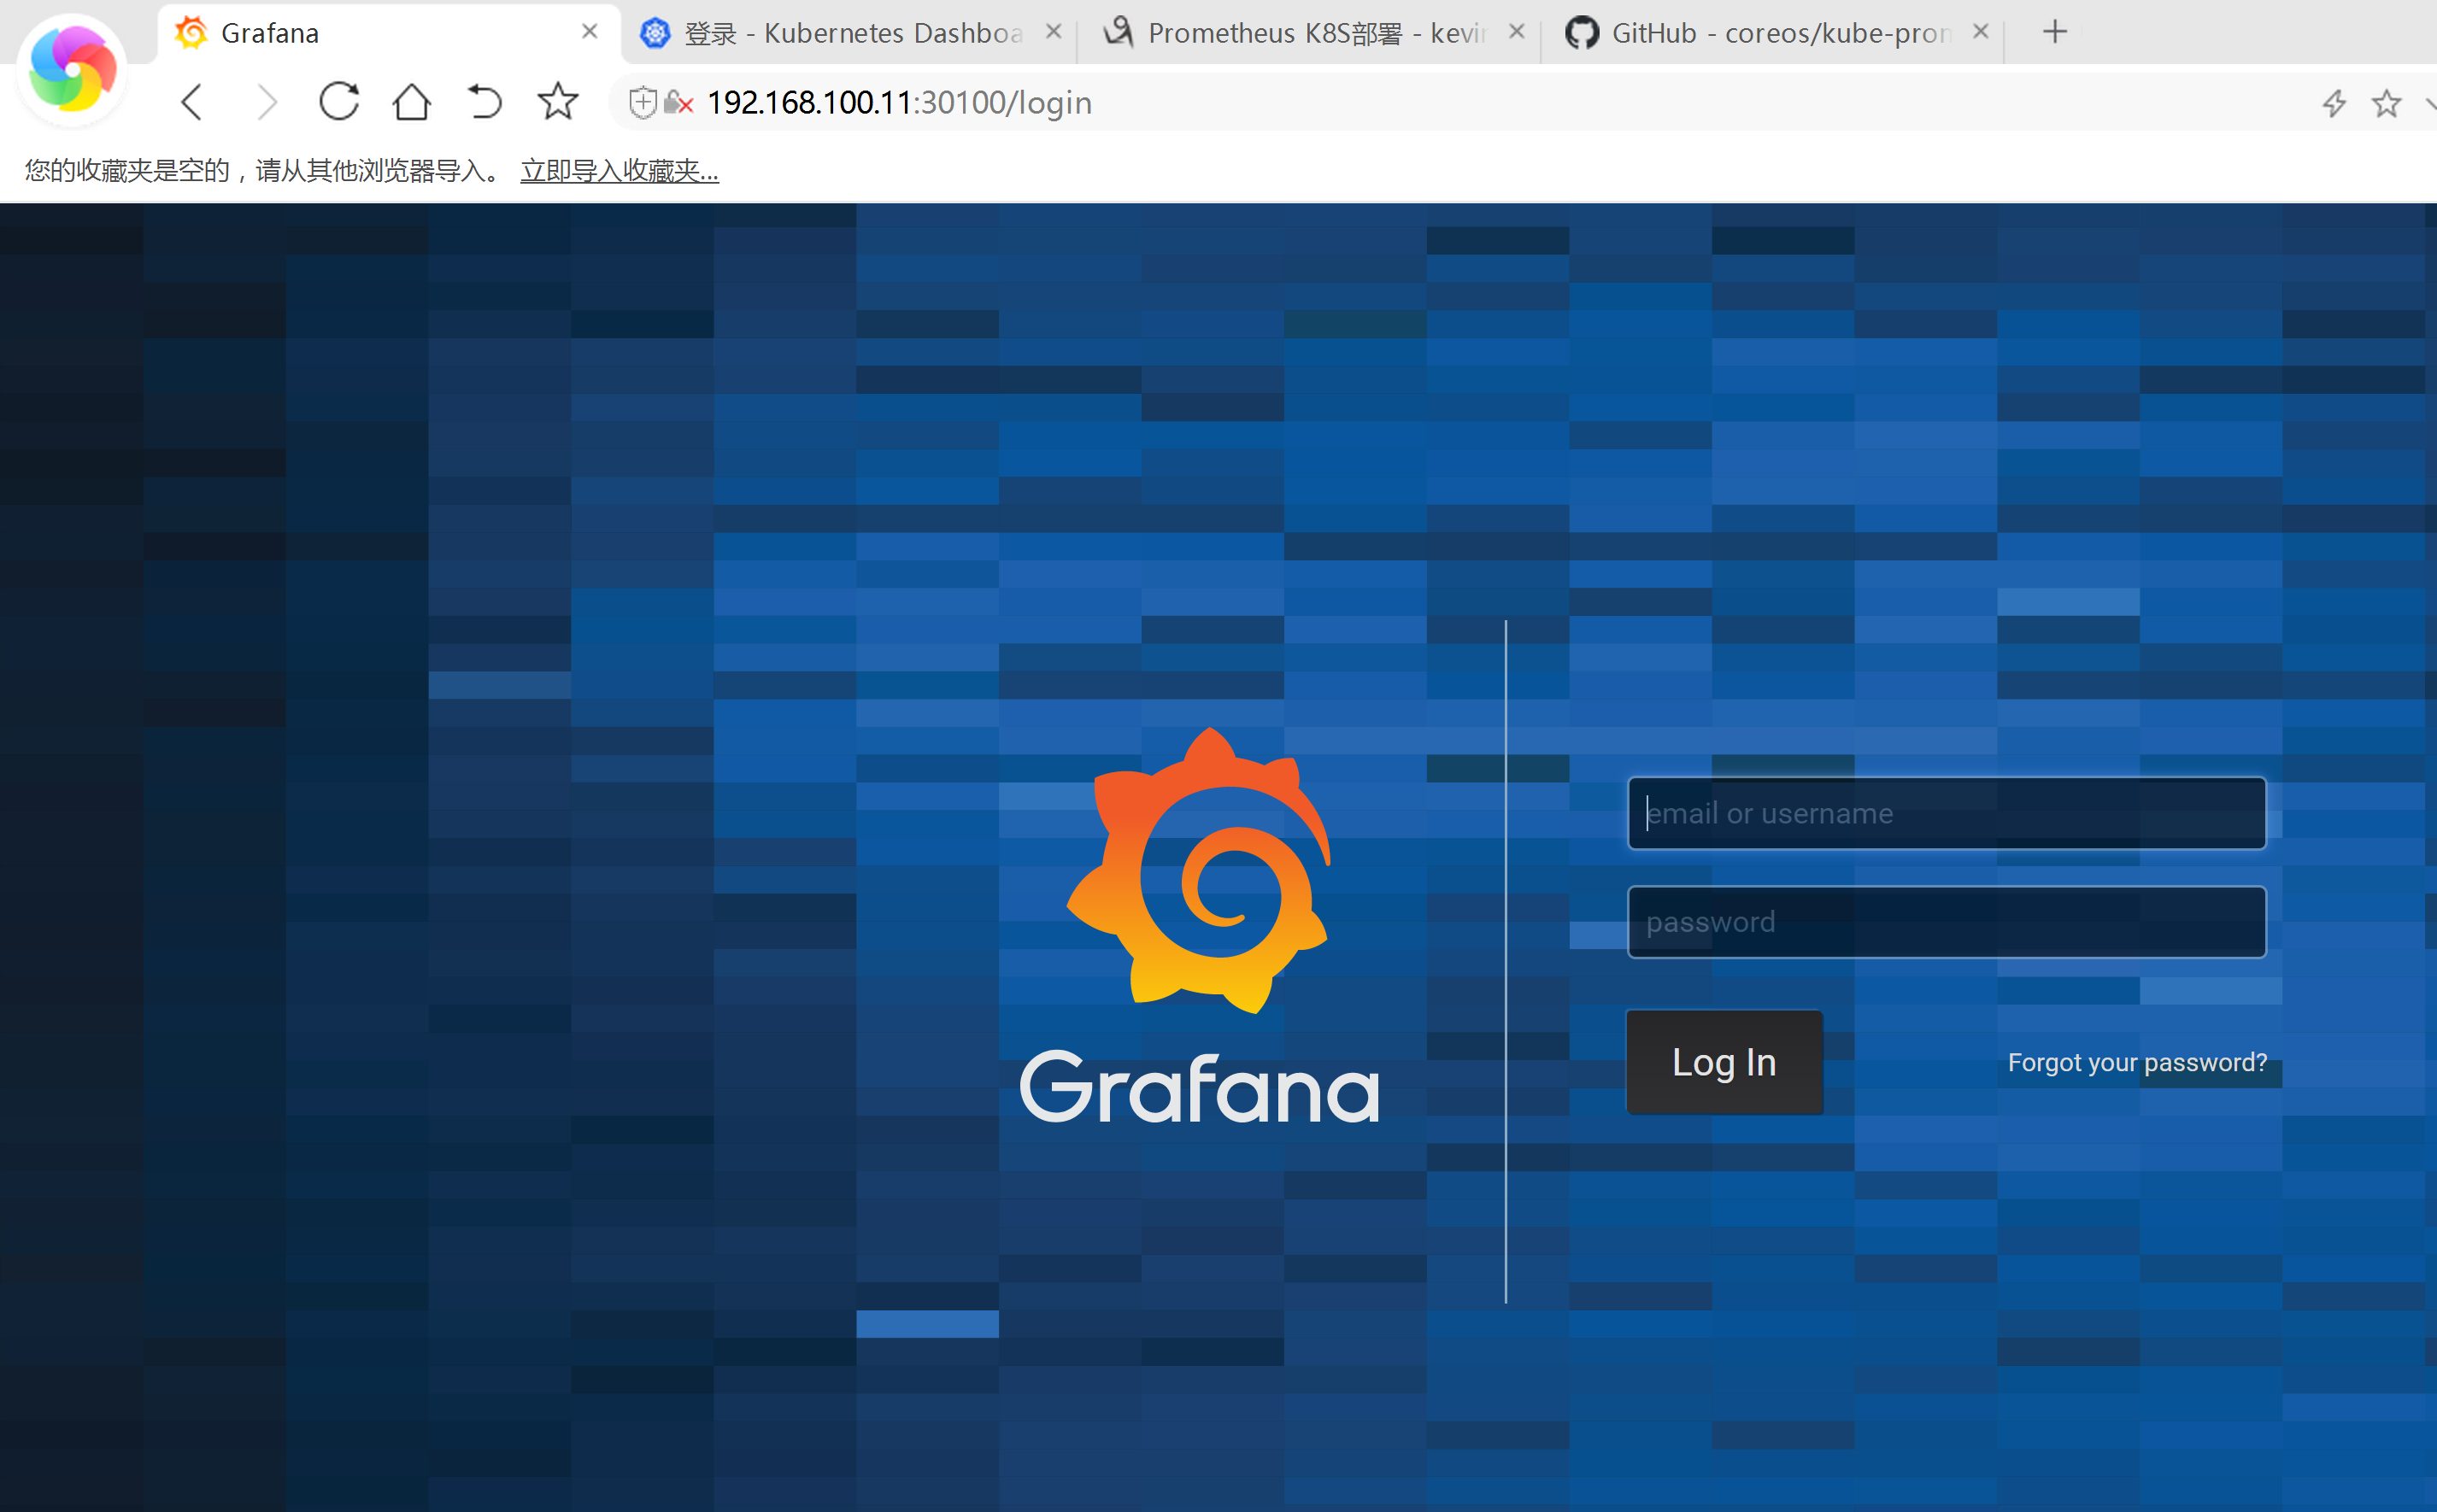
默认的用户名与 密码 都是admin然后从新修改密码即可
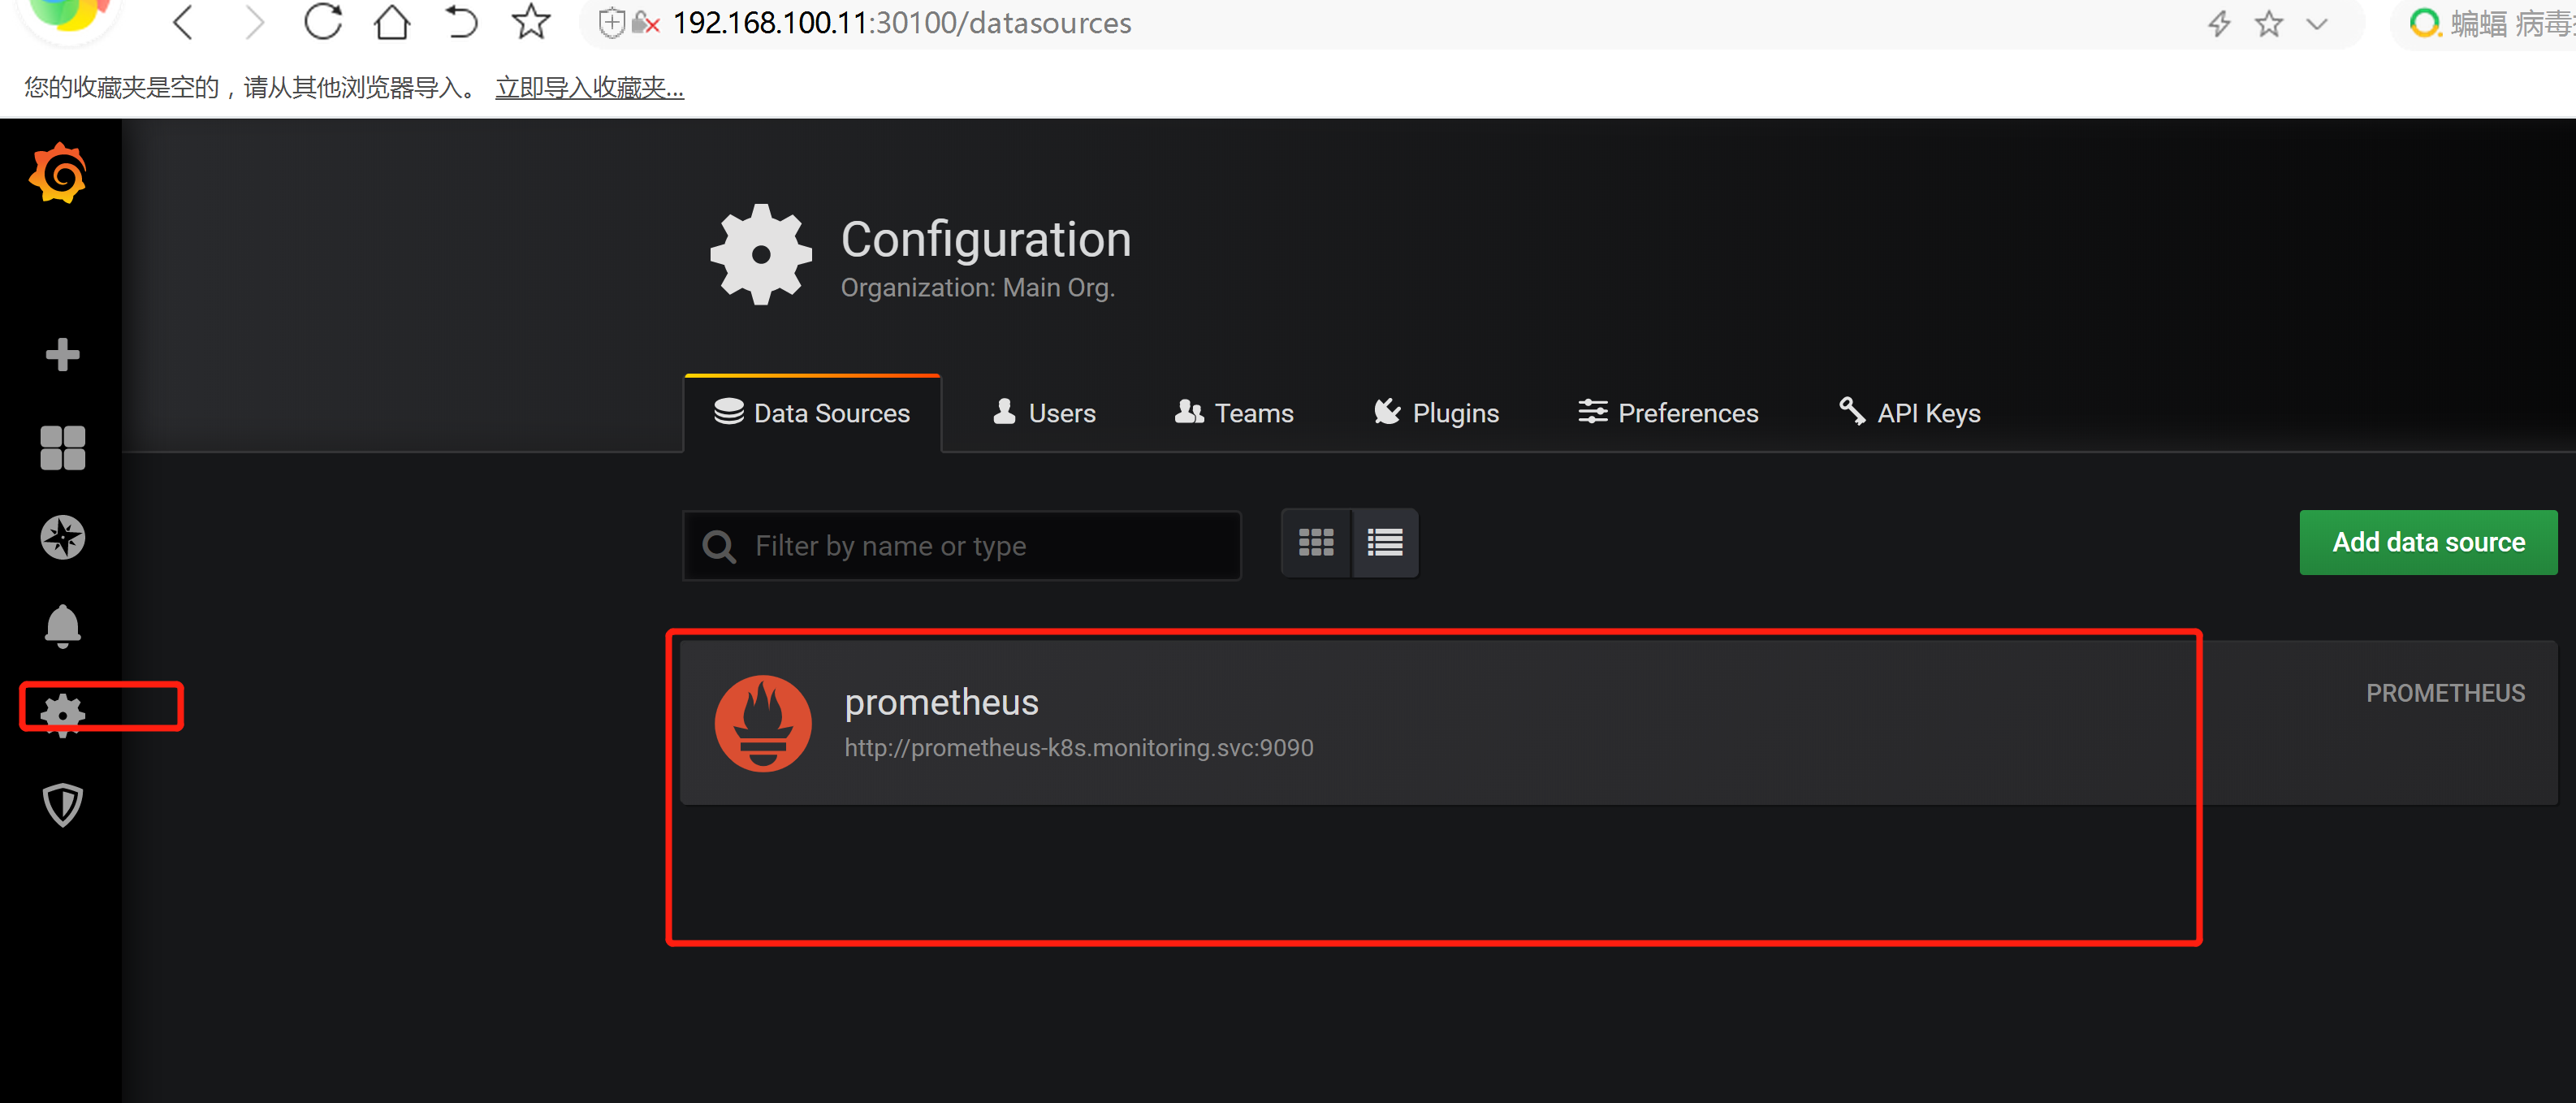
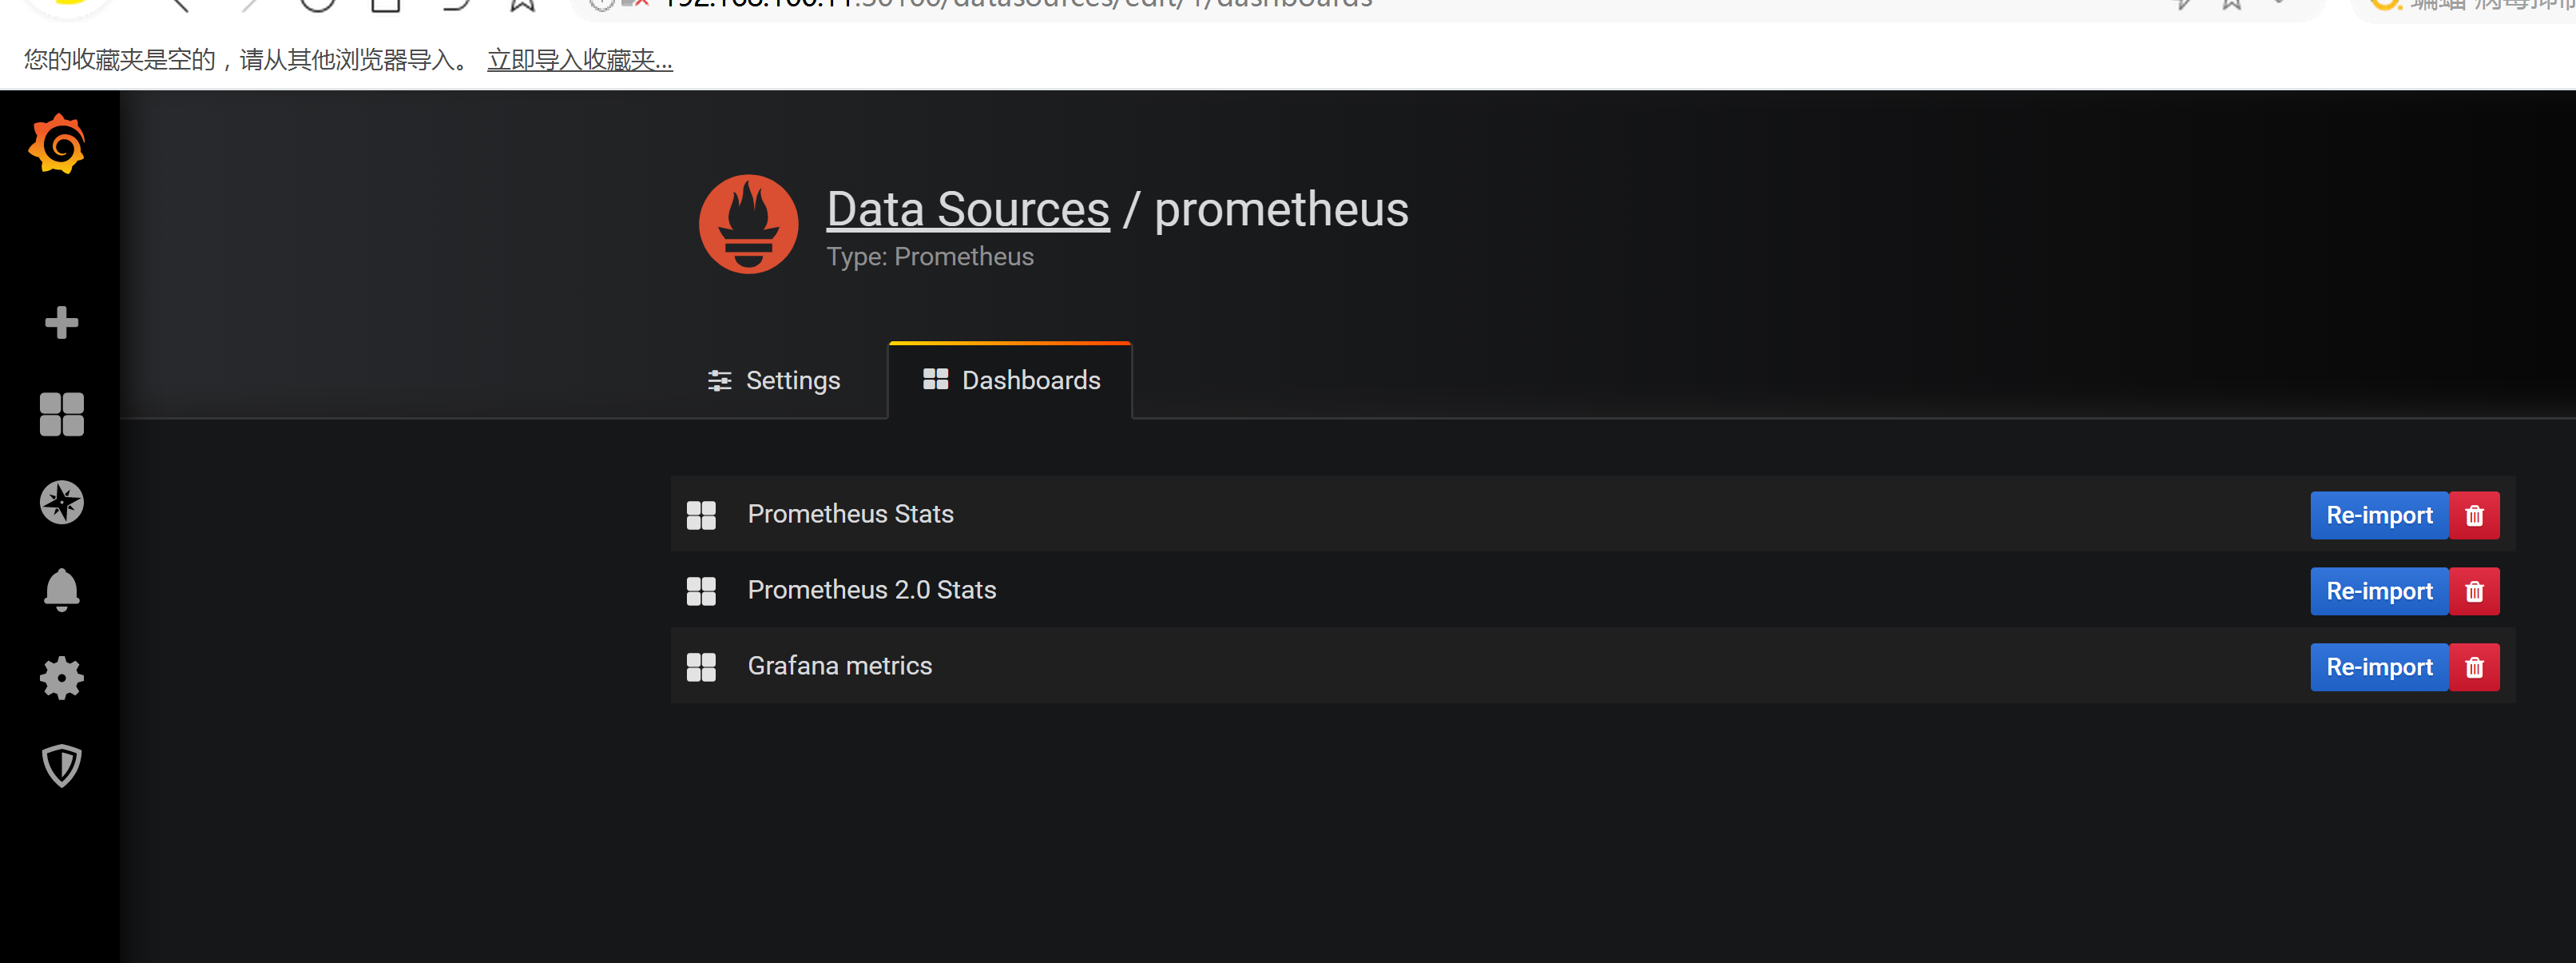
三:HPA 的资源限制
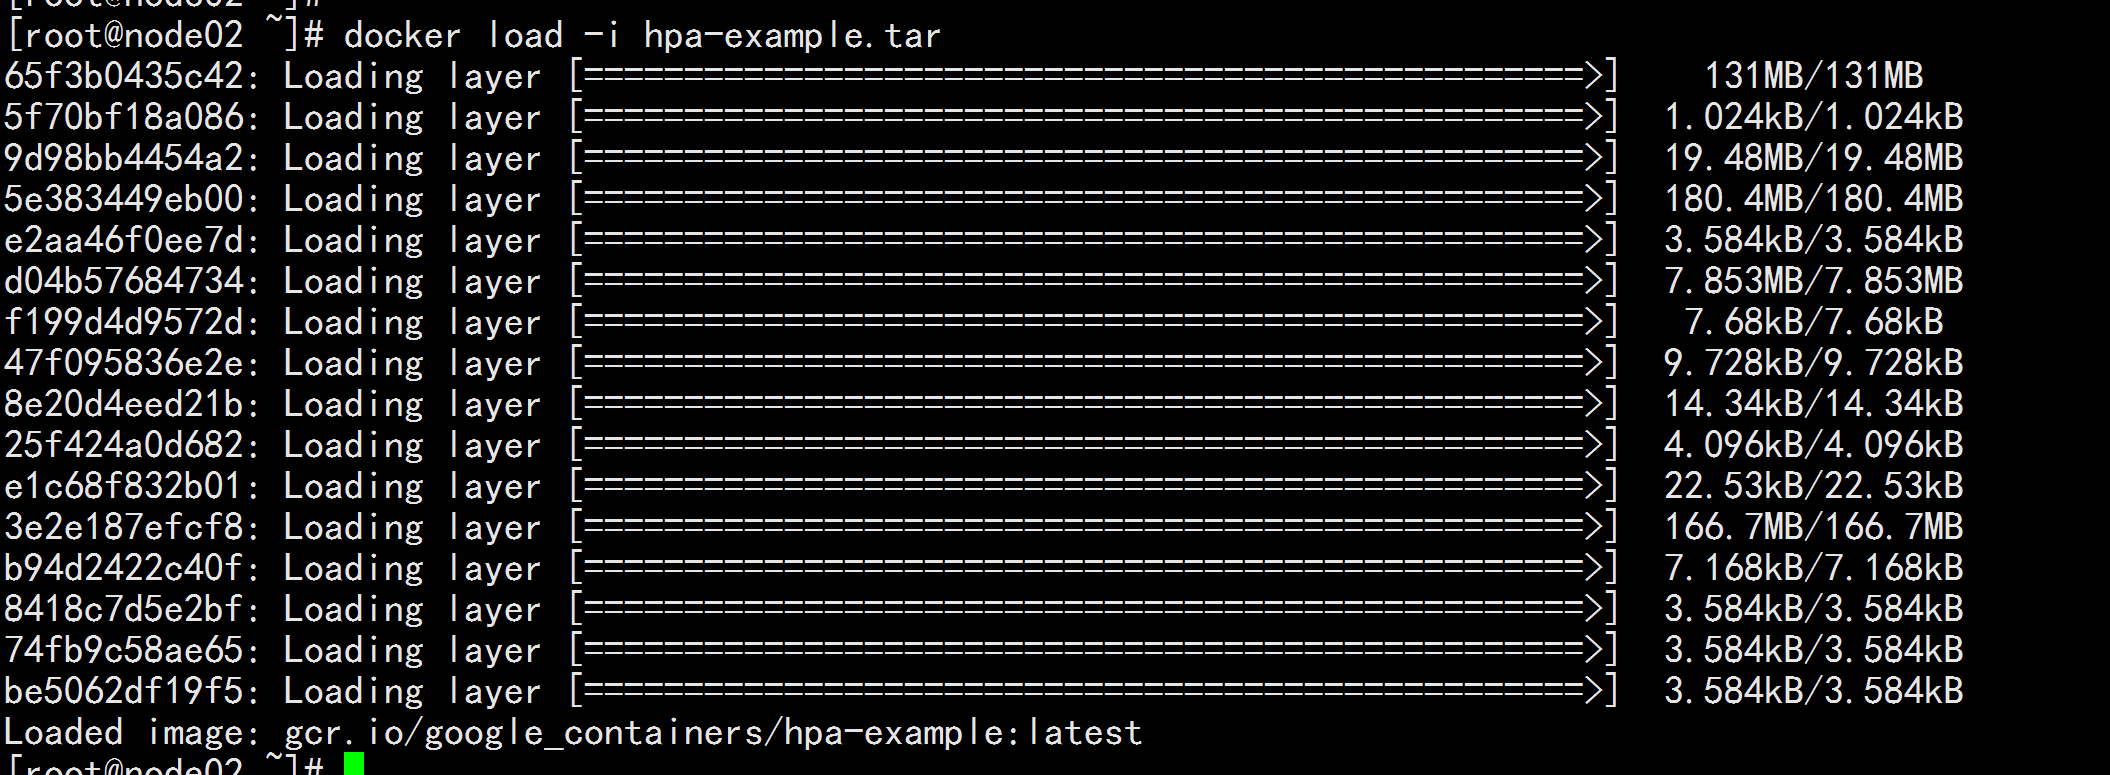
上传hpa-example.tar 然后导入 (所有节点)docker load -i hpa-example.tar
3.1 Horizontal Pod Autoscaling
Horizontal Pod Autoscaling 可以根据 CPU 利用率自动伸缩一个 Replication Controller、Deployment 或者Replica Set 中的 Pod 数量kubectl run php-apache --image=gcr.io/google_containers/hpa-example --requests=cpu=200m --expose --port=80
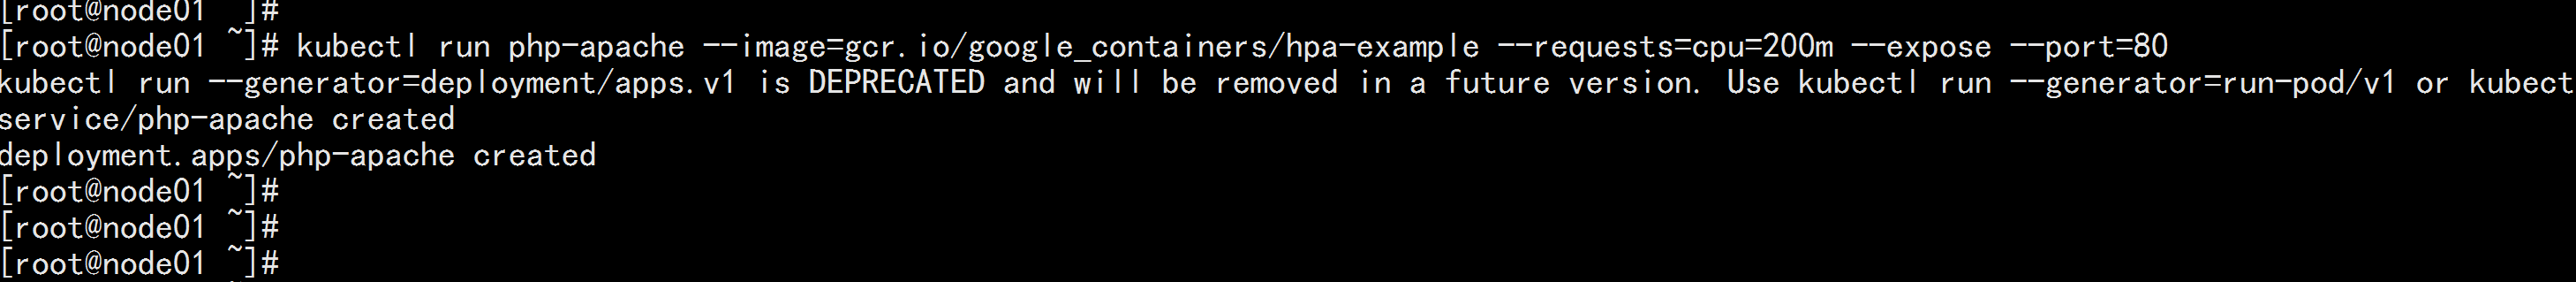
kubectl get deploykubectl edit deploy php-apache----修改:imagePullPolicy: Always 改为imagePullPolicy: IfNotPresent----kubectl get pod

创建 HPA 控制器kubectl autoscale deployment php-apache --cpu-percent=50 --min=1 --max=10kubectl top pod

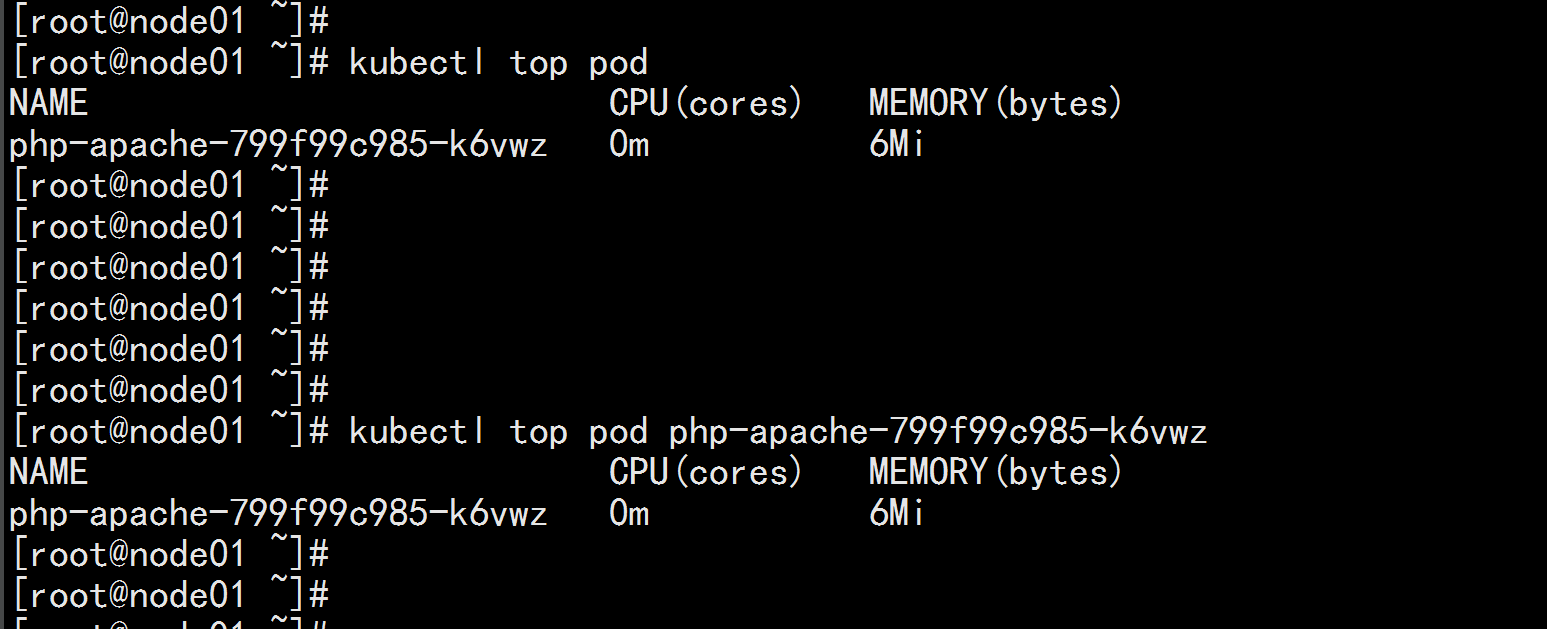
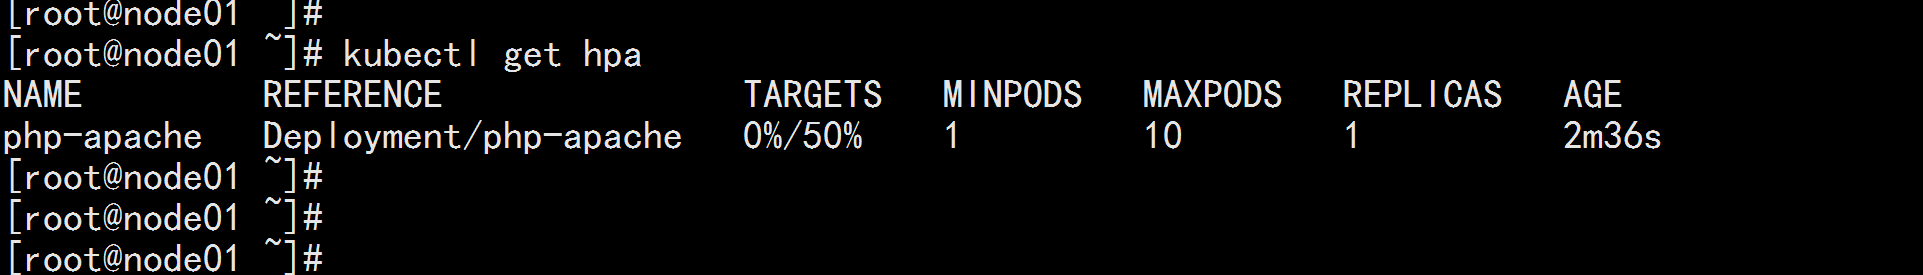
增加负载,查看负载节点数目kubectl run -i --tty load-generator --image=busybox /bin/shwhile true; do wget -q -O- http://php-apache.default.svc.cluster.local; done
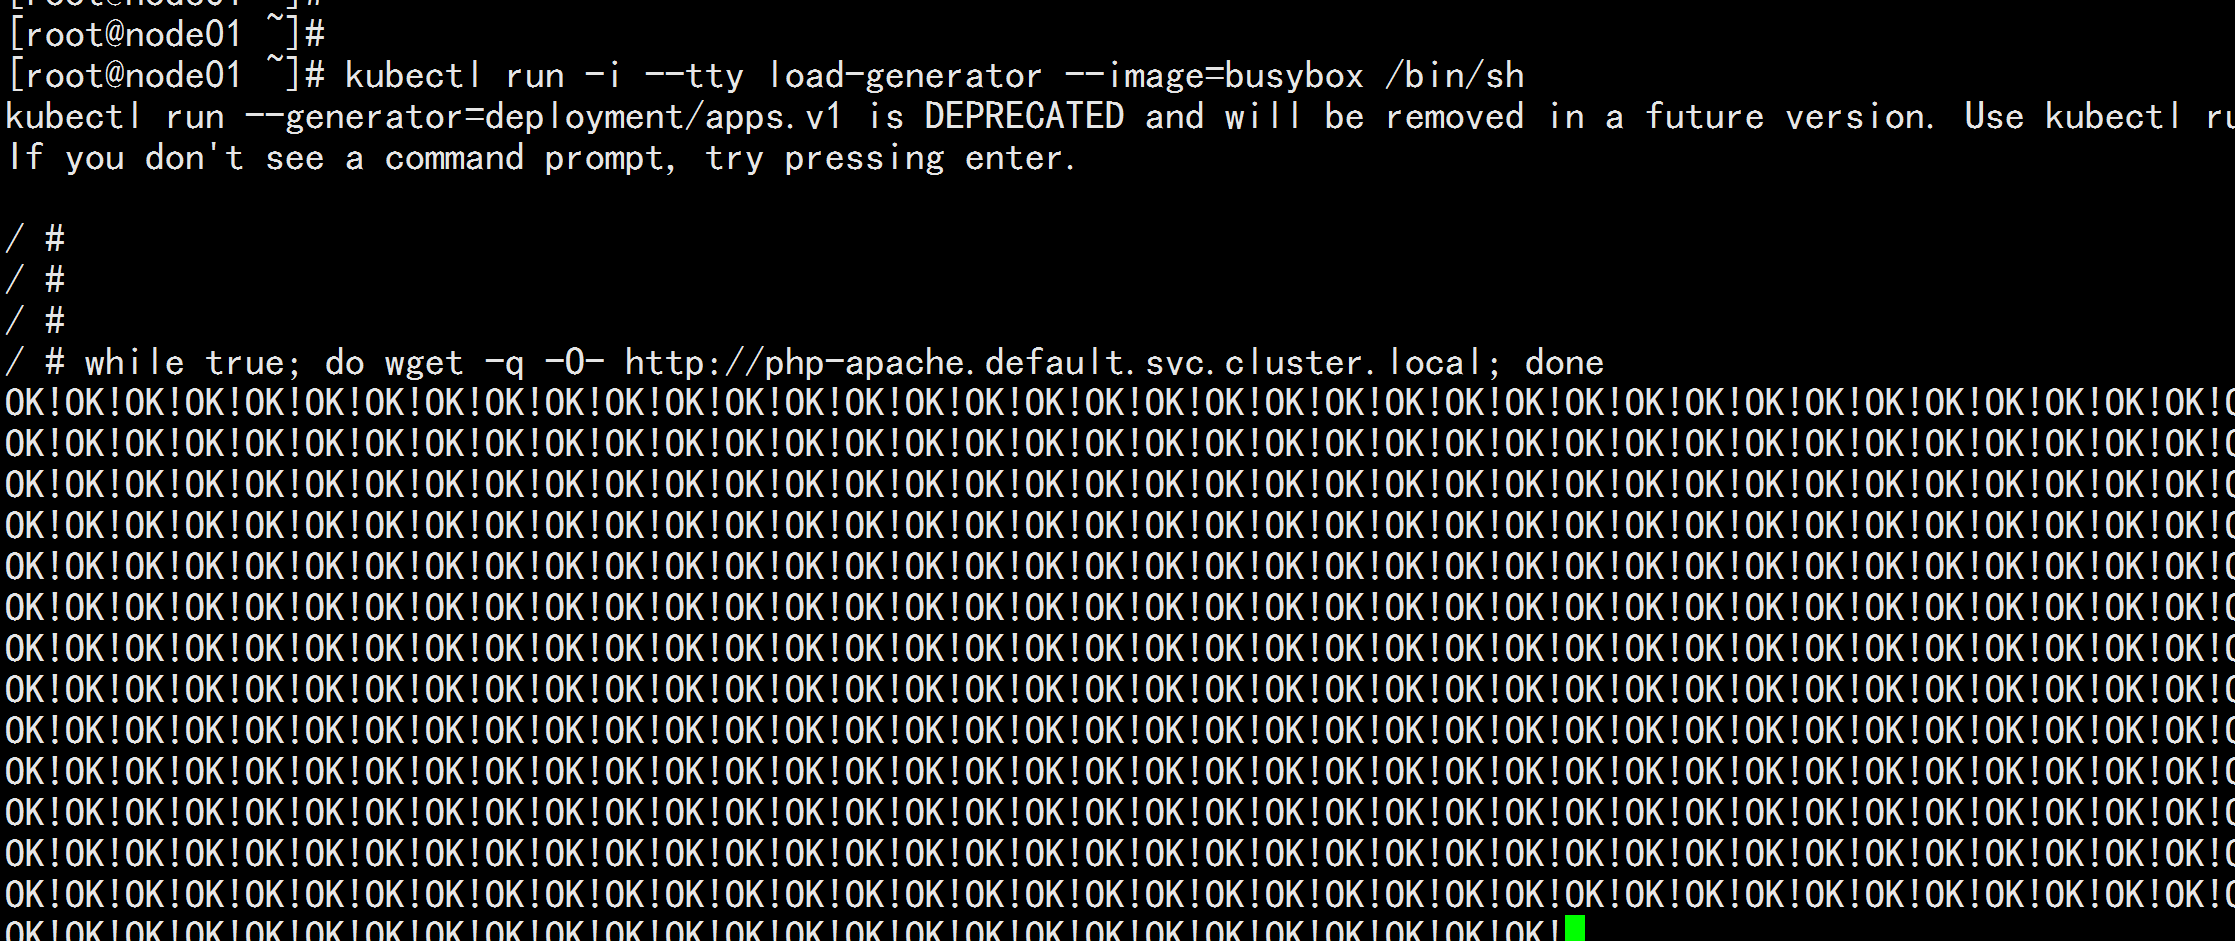
pod 开始扩展kubectl get hpakubectl get pod
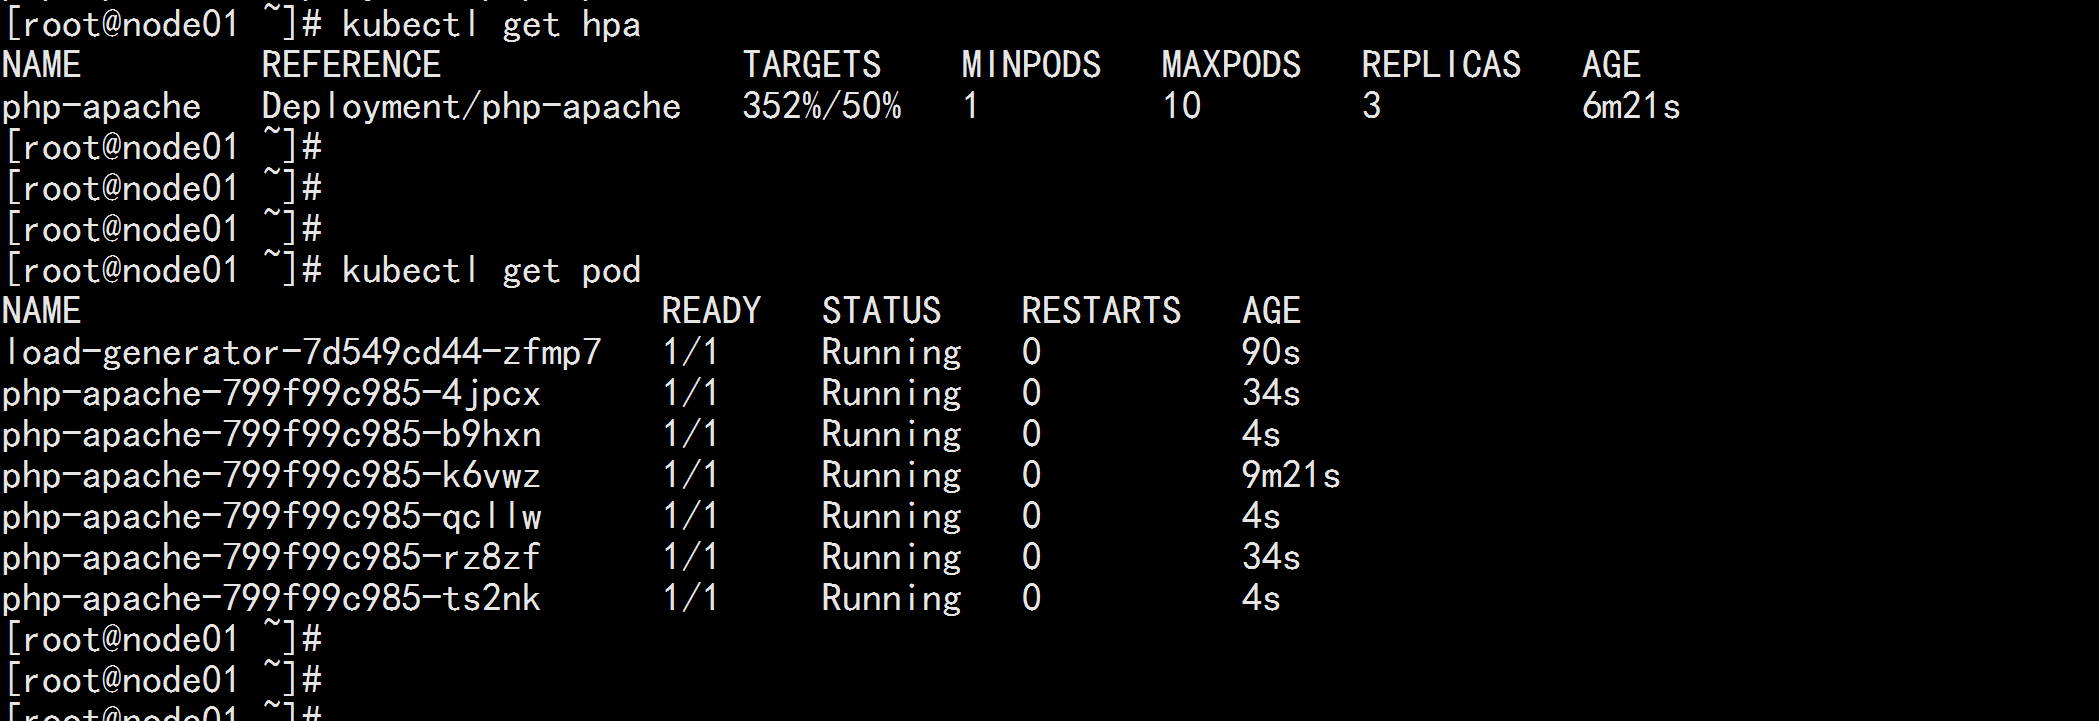
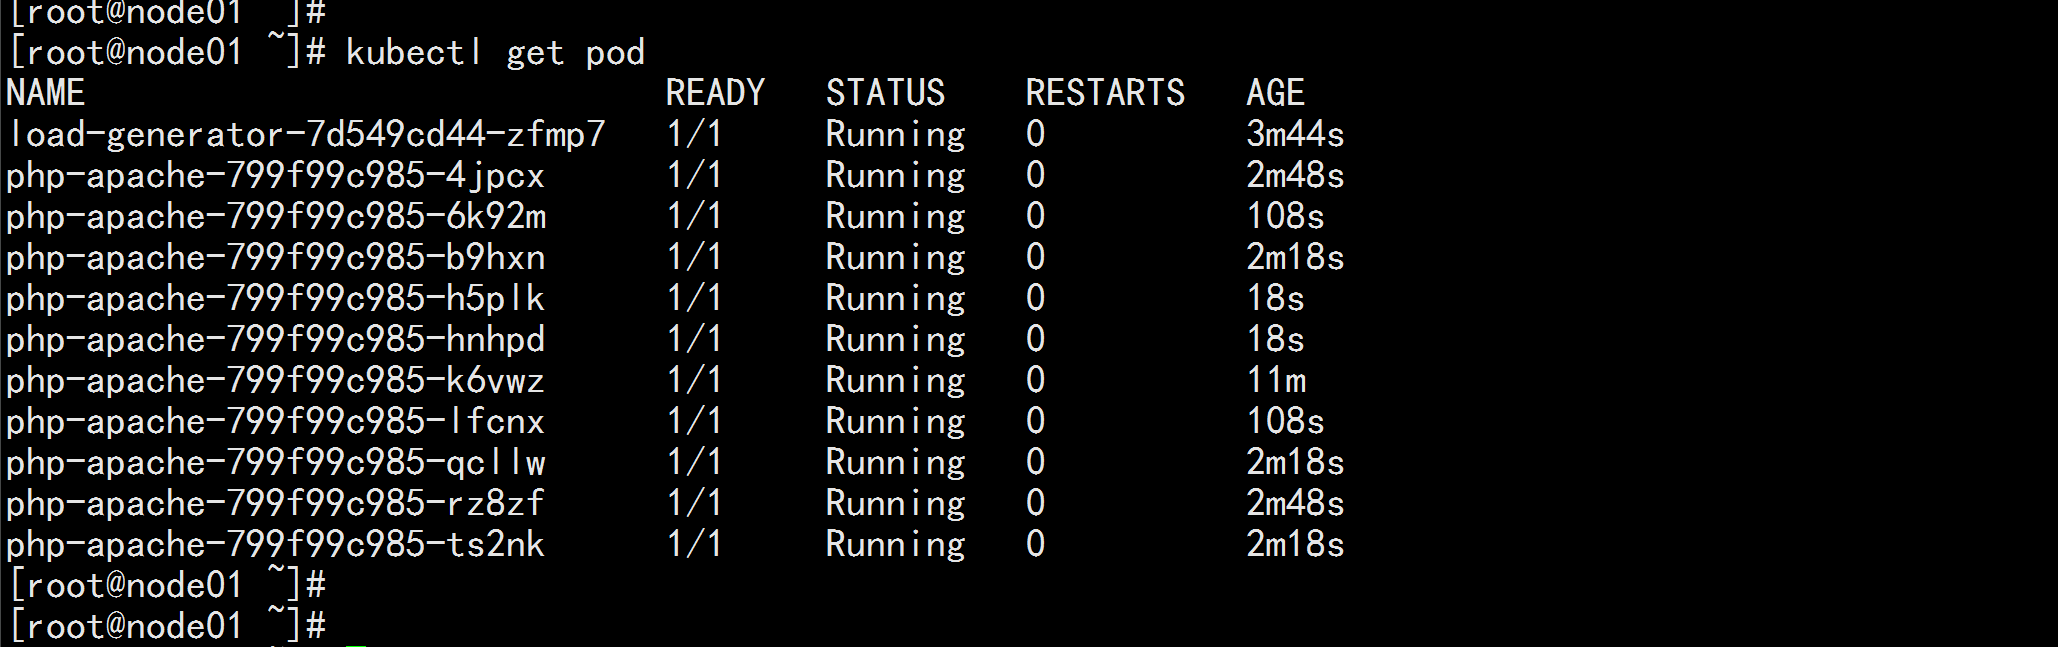

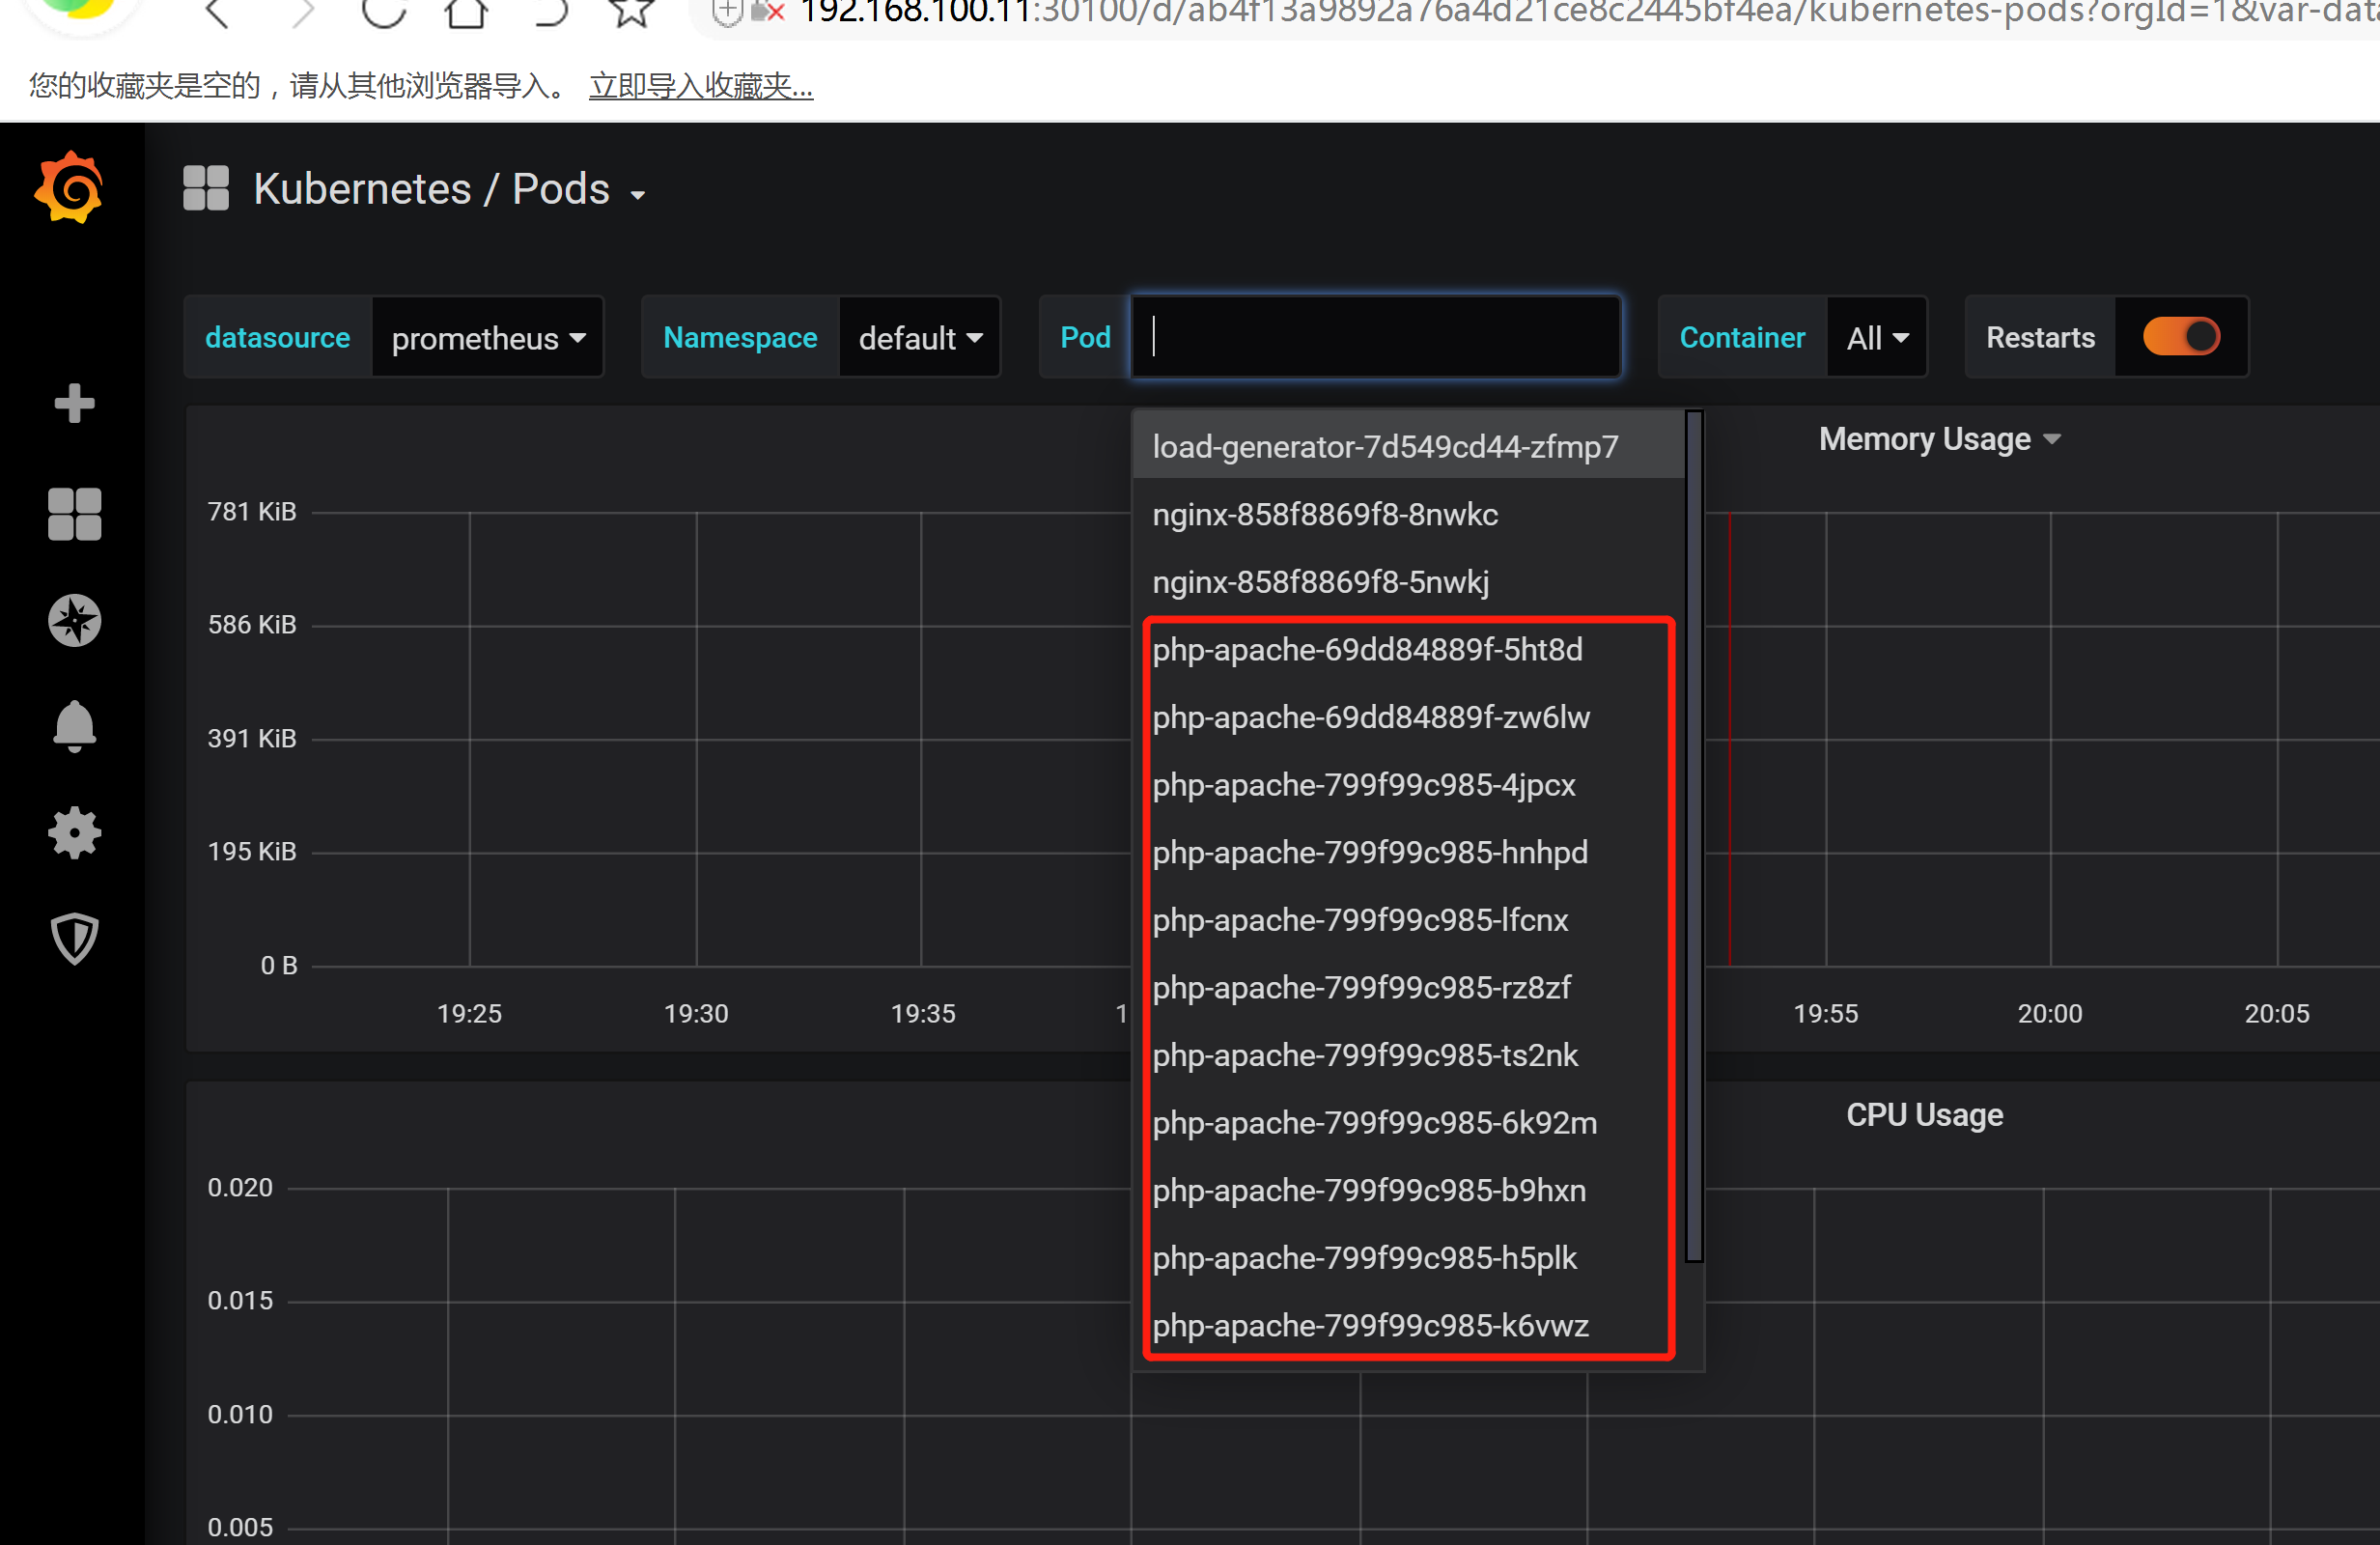
kubernetes 回收的速度比较慢(非常慢)这是因为并发的问题,一单有 大流量过来,如果回收的速度比较快,很容易将某一个pod给压死
3.2 k8s 的资源限制
资源限制 - PodKubernetes 对资源的限制实际上是通过 cgroup 来控制的,cgroup 是容器的一组用来控制内核如何运行进程的相关属性集合。针对内存、CPU 和各种设备都有对应的 cgroup默认情况下,Pod 运行没有 CPU 和内存的限额。 这意味着系统中的任何 Pod 将能够像执行该 Pod 所在的节点一样,消耗足够多的 CPU 和内存 。一般会针对某些应用的 pod 资源进行资源限制,这个资源限制是通过resources 的 requests 和 limits 来实现---spec:containers:- image: xxxximagePullPolicy: Alwaysname: authports:- containerPort: 8080protocol: TCPresources:limits:cpu: "4"memory: 2Girequests:cpu: 250mmemory: 250Mi----requests 要分分配的资源,limits 为最高请求的资源值。可以简单理解为初始值和最大值
资源限制 - 名称空间1、计算资源配额apiVersion: v1kind: ResourceQuotametadata:name: compute-resourcesnamespace: spark-clusterspec:hard:pods: "20"requests.cpu: "20"requests.memory: 100Gilimits.cpu: "40"limits.memory: 200Gi
2. 配置对象数量配额限制apiVersion: v1kind: ResourceQuotametadata:name: object-countsnamespace: spark-clusterspec:hard:configmaps: "10"persistentvolumeclaims: "4"replicationcontrollers: "20"secrets: "10"services: "10"services.loadbalancers: "2"
3. 配置 CPU 和 内存 LimitRangeapiVersion: v1kind: LimitRangemetadata:name: mem-limit-rangespec:limits:- default:memory: 50Gicpu: 5defaultRequest:memory: 1Gicpu: 1type: Container----default 即 limit 的值defaultRequest 即 request 的值
