@artman328
2022-04-14T09:16:35.000000Z
字数 69696
阅读 1802
程序员之路:关系数据库的应用(2ed)
database 数据库 程序员之路
绪论
我们生活在信息时代,一个由传统工业生产转向了基于信息和计算机的工业生产时代。电子技术、通信技术、计算机技术与网络技术的发展,使人类能够为利用信息而快速、及时、大量地收集、处理、存储和检索信息。对信息的利用,大大提高了信息时代的社会生产力和组织决策成功率。
什么是信息?直白地说,信息就是人们对事物的感知所进行的描述,这些描述可以以不同的形式进行呈现,如:文字、图像等。如果要用计算机对信息进行处理,信息在计算机中有一个具体的名称——数据(Data)。因此,计算机中的信息处理即数据处理。
这里需要注意的是,“数据”(data)不等同于“数字”(number),“数据”代表了具备多样性的信息,如:一个数字、一个电话号码、一首歌、一个日期、一张图片、一部电影等等……
在计算机中,负责组织、维护、检索信息的软件系统叫做数据库管理系统(Database Management System),数据库(Database)即存储数据的地方。
1、课程目的
掌握作为程序员所需要规划、设计和使用管理数据库的基本技能。
程序员为什么要学习数据库?
所有计算机程序都是用来处理信息数据(data)的,绝大多数程序的数据都用数据库来进行存储。不懂数据库,也就没有办法很好地开发计算机程序。可以说,数据库在信息管理类的应用程序中,是举足轻重的角色。因此可以说,很好地使用数据库来组织和管理信息,是程序员的必备技能之一。
2、课程对象
有志于软件开发或数据库管理的任何人,只要满足以下条件:
- 具备初中及以上文化程度;
- 会使用计算机
3、课程内容
为便于读者学习,本课程将内容划分为三个部分:
(1)数据库基础
了解数据库基本概念及搭建学习环境。
(2)数据库的使用
通过由简到繁的多个实际案例,达到以下目标:
- 掌握数据库相关的基本概念
- 读懂设计稿
- 掌握数据的增删改查
- 了解视图、存储过程、函数及触发器
使用数据库的过程:
(3)数据库的设计
通过由简到繁的多个实际案例,达到以下目标:
- 掌握相关的基本概念
- 根据业务需求和样例数据规划数据表
- 建库、建表、插入样例数据
根据业务需求测试处理和访问数据
规划和设计数据库过程:
如此安排三个部分的内容,是基于这样一个自然规律:当你熟悉了一种事物,你才能去创造和改进这种事物。比如,只有一个会开车的人,才会针对驾驶体验去重新设计和改进驾驶操作环境;让一个从来没有开过车的人针对驾驶体验去重新设计和改进驾驶操作环境是不可相像的。
4、学习方法
学习一项技能的根本方法是“做中学”(Learning by doing), 因此在学习过程中应做到以下几点:
- 循序渐进,在完全掌握前面内容的情况下,再进行后面的内容的学习;
- 针对各章节内容的实例,请在计算机上进行实际操作;
- 认真完成各章节布置的作业;
- 如果课程中有不明白的地方,要会主动通过网络进行检索学习。
第一部分 数据库基础
第一章 数据库的基本概念与学习环境的建立
1、数据库的基本概念
1.1 数据库(Database)
数据库的目的是存储并管理数据(data)。在数据库中,数据是以表(table)的形式存储的。与生活中见到的表格一样,数据库中的表也是由行(row)和列(column)构成的,一列表示某种信息,如“姓名”、“性别”等,而由多列构成的一行就构成了一条记录。
一个数据库里可以有多张表。
1.2 关系数据库(Relational Database)
如果数据库里的数据是以表(table)的形式存储,并且多张表和表之间可以建立相互参照(reference)的关系(relationship),这样的数据库就叫关系数据库。
1.3 关系数据库管理系统(RDBMS)
RDBMS: Relational Database Management System.
关系数据库系统是一套计算机软件,用于管理数据库。
一个关系数据库管理系统可以管理多个数据库。
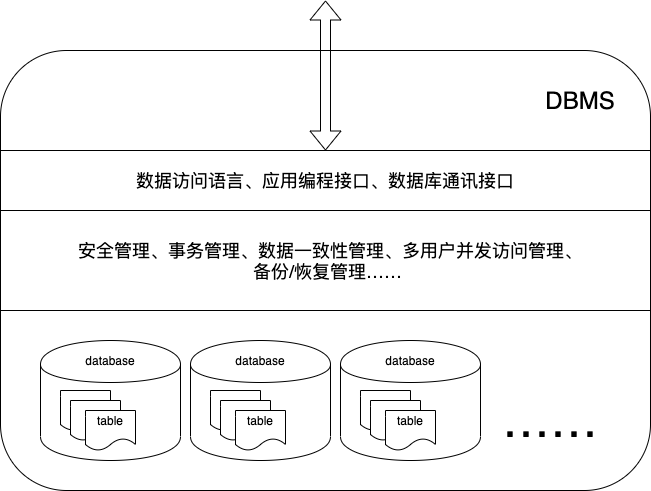
主要功能:
(1)安全管理
根据用户身份和权限限制用户对数据的访问。
(2)事务管理
一个事务(Transaction)包含对数据库的多项操作,为保证数据得到正确处理,对数据的操作都应该得到一个稳定的最终状态——要么对数据的所有更改都成功使数据到达一个新的状态,要么撤消所有更改回到之前的状态。
(3)数据一致性管理
管理对数据库中数据的约束,保证数据的变更都是有效的。比如把不同的数据类型的数据放到了某一列(把“李明”放到了“出生日期”那一列),或者参照的数据不存在(“销售明细”表里有“产品编号”一列,参照了“产品表”里的“产品编号”列,而“销售明细”的“产品编号”列里填入了“0303”,而在“产品表”里并不存在“产品编号”为“0303”的记录),这些都是数据不一致的体现,是不被允许的。
(4)多用户并发访问管理
多用户访问数据时的冲突控制,这种冲突控制叫做事务隔离,它可采取不同策略对两个事务之间的操作进行不同级别的隔离。例如当一个用户正在更改数据,更改的数据已经写入数据库,但本身的事务还没有完成,其它用户此时应该读到更改后的数据还是在这个用户的事务开始之前(更改前)的数据?
(5)备份/恢复数据
备份数据,避免数据遗失。当必要时(比如存储介质损坏、迁移系统到新服务器等)可在新系统中从备份中恢复数据。
1.4 SQL 语言
SQL 语言,即结构化查询语言,是一种接近于人类自然语言(英语)的数据库专用语言。我们用它来定义数据库的各种元素,如库、表、关系、约束、触发器、存储过程、函数等等,用于这方面的语句又称作数据定义语言 DDL。我们也用它来完成数据的操纵,如对数据进行增加、删除、修改、查询等操作,用于这方面的语句又叫数据操纵语言 DML。当然,还有一类语句是用于管理数据库权限分配的,叫数据控制语言DCL,以及管理数据库事务的事务的控制语句,叫TCL。我们不用费心记住这些,这里只是做概念性的介绍,所有这些语句我们以后都会用到。
2、学习环境的建立
本教程将采用业界最受欢迎的开源数据库管理系统 MariaDB 作为讲解对象。
2.1 MraiaDB 数据库管理系统应用架构
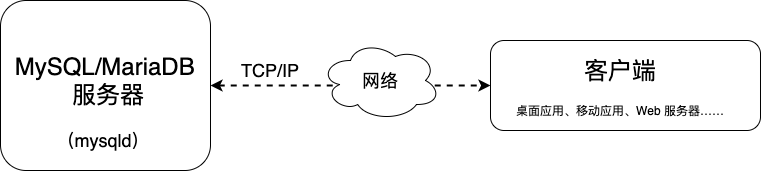
2.2 MraiaDB 数据库管理系统管理界面

2.3 在 Windows 中安装 MariaDB
(1)下载安装
(2)测试安装
如有需要,配置环境变量PATH。
第二章 管理 MySQL 数据库
1、配置文件
为服务器和客户端提供各类配置信息,以规定服务器和客户端的默认行为。
查看配置文件名及其读取顺序:
mysqladmin --help...Default options are read from the following files in the given order:C:\Windows\my.ini C:\Windows\my.cnf C:\my.ini C:\my.cnf C:\Program Files\MariaDB 10.4\my.ini C:\Program Files\MariaDB 10.4\my.cnf C:\Program Files\MariaDB 10.4\data\my.ini C:\Program Files\MariaDB 10.4\data\my.cnf...
2、管理服务
服务是一种特殊程序,它一般不提供与用户直接交互的界面,而是在后台运行,通过某种请求和响应协议来向客户端程序提供服务。
2.1 服务的启动、停止
a) 通过 services.msc 服务管理程序来完成
b) 通过命令行来完成
net start mariadbnet stop mariadb
2.2 用 mysqladmin 管理数据库系统
mysqladmin -h 服务器地址 -P 服务器端口 -u 用户名 -p 密码 管理命令
-h:忽略时使用本机地址;
-P: 忽略时使用配置文件里的端口(通常为3306);
-u: 忽略时使用当前操作系统的用户;
-p: 忽略时不使用密码,密码忽略时会提示输入。
例1:改变本机上的数据库管理系统(默认端口:3306)的 root 密码。
mysqladmin -uroot -p password
3、备份和恢复数据库
3.1 备份数据库
【命令形式】
mysqldump -u用户名 -p[密码] [选项] 数据库名1 [ 数据库名 [...]]` > 备份文件名
命令中的 > 符号叫重定向符号,表示将它之前的命令的输出结果定向到(保存到)后面文件名指定的文件。
【获取帮助】
可用命令 mysqldump --help 查看 mysqldump 的帮助文档。
【重要选项】
--databases 或 -B
后面可指定一到多个数据库名称(空格分隔),备份文件中会出现安全创建数据库的 CREATE DATABASE IF NOT EXISTS ... 语句。
--all-databases 或 -A
备份数据库管理系统中的所有数据库,相当于 --databases 选项后罗列出系统中的所有数据库。
--add-drop-database
备份中如果有创建数据库语句(用以上选项),则会在每个创建数据库语句前安全删除数据库DROP DATABASE IF EXISTS ...
--routines 或 -R
备份数据库中的存储过程和函数定义
--single-transaction
保证备份过程中的数据一致性(备份期间数据被“固化”),对备份多连接、数据变动频繁的数据库系统特别重要。只对采用了InnoDB引擎(默认引擎)的表有效。
【举例】
以下例子对数据库管理系统中的一个数据库进行备份:
mysqldump -uroot -p --databases --add-drop-database --routines --single-transaction mysite > mysite.sql
或:
mysqldump -uroot -p -B --add-drop-database --R --single-transaction mysite > mysite.sql
【练习】
1、请写出将数据库管理系统中的 mysite 和 shop 数据库同时备份出来的语句。
2、请写出将数据库管理系统中所有的数据库同时备份出来的语句。
3.2 恢复数据库
【命令形式】
mysql -u用户名 -p[密码] [选项] [数据库名] < 备份文件名
命令中的 < 符号叫做重定向符,它将后面文件名指定的内容输入到符号前的命令。
如果备份数据库时用了 --databases 选项,则命令中的 [数据库名] 不需要。
【获取帮助】
可用命令 mysql --help 查看 mysql 的帮助文档。
【重要选项】
--default-character-set=name
设定字符集为 name 表示的字符集。如果备份的数据库的字符集是 uft8mb4 , 就应该将默认字符集设定为 utf8mb4。
【举例】
1、将数据库 mysite 备份到 mysite.sql,然后再将其恢复到数据库管理系统中。
(1) 不用 --databases 选项进行备份的恢复(单个数据库可不用)
-- 备份mysqldump -uroot -p -R --single-transaction mysite > mysite.sql-- 恢复(先尝试建库,再恢复)mysql -uroot -p -e "create database mysite if not exists default charset utf8mb4"mysql -uroot -p --default-character-set=utf8mb4 mysite < mysite.sql
(2)用 --databases 或 -B 选项(备份多个数据库必需)进行备份的恢复
-- 备份mysqldump -uroot -p -B -R --single-transaction mysite > mysite.sql-- 恢复mysql -uroot -p --default-character-set=utf8mb4 < mysite.sql
【练习】
1、将所有数据库备份出来(含存储过程和函数定义),然后再将备份恢复到系统中。
第三章 操作 MariaDB 数据库系统
1、登录到数据库服务器
mysql [-h 服务器地址] [-P 服务器端口] [-u 用户名] [-p [密码]]
-h:忽略时使用本机地址;
-P: 忽略时使用配置文件里的端口(通常为3306);
-u: 忽略时使用当前操作系统的用户;
-p: 忽略时不使用密码,密码忽略时会提示输入。
例如:登录到运行于本机的数据库服务器,端口为配置文件指定的窗口,用户名为 root,需要登录时提示输入密码。
mysql -u root -p
2、列出系统中管理的数据库
MariaDB [(none)]> show databases;+--------------------+| Database |+--------------------+| information_schema || mysql || performance_schema || test |+--------------------+4 rows in set (0.001 sec)MariaDB [(none)]>
SQL语言用分号(;)表示一条语句的结束,换行并不会打断一条语句的完整性。在 MySQL/MariaDB 系统中,用 \g 来结束一条语句与分号作用一样,而用 \G 来结束一条语句,会把输出结果按竖式排列,便于显示查看过宽的输出结果。
information_schema, mysql, performance_schema 是三个数据库管理系统自用的数据库。
test 是一个用于测试的数据库,任何人都有足够权限对它操作,为安全起见,在生产环境中通常会被删除。
3、进入某个数据库
如:进入 mysql 数据库。
MariaDB [(none)]> use mysql;Database changedMariaDB [mysql]>
use: 使用
注意提示符的变化(MariaDB [(none)]>到MariaDB [mysql]>)。
4、列出数据库中的数据表
如:列出 mysql 数据库中的数据表。
MariaDB [mysql]> show tables;+---------------------------+| Tables_in_mysql |+---------------------------+| column_stats || columns_priv || db || event || func || ...... (略去一些) || transaction_registry || user |+---------------------------+31 rows in set (0.001 sec)MariaDB [mysql]>
show: 显示,展示
table: 表
5、查看数据库系统的用户
MariaDB [mysql]> select Host, User, Password from user;+-----------------+------+-------------------------------------------+| Host | User | Password |+-----------------+------+-------------------------------------------+| localhost | root | *032197AE5731D4664921A6CCAC7CFCE6A0698693 || desktop-f6ge8f3 | root | *032197AE5731D4664921A6CCAC7CFCE6A0698693 || 127.0.0.1 | root | *032197AE5731D4664921A6CCAC7CFCE6A0698693 || ::1 | root | *032197AE5731D4664921A6CCAC7CFCE6A0698693 || % | root | *032197AE5731D4664921A6CCAC7CFCE6A0698693 |+-----------------+------+-------------------------------------------+5 rows in set (0.001 sec)MariaDB [mysql]>
select : 选择
from : 从
Host(主机): 用户可登录的地点(计算机网络地址)。
User(用户): 用户名。
Passowrd(密码): 密码(已加密)。
6、查看系统中的字符集编码的排序规则
show charset;show character set;show chaset like '%utf8%';show collation;show collation like '%utf8%';
character set: 字符集(在计算机内部把文字编码成数字的方案,同一个方案编码的字符,只能用同一种方案解码)
collation: 排序规则(如汉字在字典中就有按笔划排序、按拼音排序等规则)
7、查看系统使用的字符集
MariaDB [(none)]> show variables like 'char%';+--------------------------+-----------------------------------------------+| Variable_name | Value |+--------------------------+-----------------------------------------------+| character_set_client | gbk || character_set_connection | gbk || character_set_database | utf8 || character_set_filesystem | binary || character_set_results | gbk || character_set_server | utf8 || character_set_system | utf8 || character_sets_dir | C:\Program Files\MariaDB 10.4\share\charsets\ |+--------------------------+-----------------------------------------------+8 rows in set (0.001 sec)MariaDB [(none)]>
variable : 变量
like : 像
8、断开连接
MariaDB [(none)]>exit
第二部分 数据库的使用
在这一部分,我们将读懂别人的数据库设计,了解数据库内的各种元素:表及表间关系、视图、触发器、函数、存储过程等。更重要的是,我们将利用 SQL 语言去操纵数据库里的数据,实现数据库设计需求文档中所需要实现的各种业务操作。
充分了解特定场景下别人根据需求对数据库所做出的设计,熟练地操作别人数据库里的数据,对我们将来在类似场景下根据需求自行设计数据库具有重要的启发作用。
第四章 预备知识:数据库设计文档解读
数据库设计文档用于描述数据库的设计,其中主要包含需求描述、实体及实体间关系的描述(实体关系图,Entity Relationship Diagram,ER图)、数据字典(表、视图、触发器、存储过程、函数等的定义)等。
4.1 数据库设计的相关概念
4.1.1 实体(Entity)
数据库里的每一张表都存储了描述某个事物的信息,我们把这被描述的事物叫“实体”。
4.1.2 E-R 图(Entity Relationship Diagram )
即实体关系图,用于描述各个实体之间的依赖关系的图。
4.1.3 数据字典(Data Dictionary)
用于详细数据库中的各个元素,包括对实体、触发器、视图、函数与存储过程等的详细定义。
4.1.4 表(Table)
实体的信息以表的形式进行存储,表包含行和列,某一列就是实体的某个属性(Property),某一行就是实体的某个实例(Instance)。
4.1.5 视图(view)
相当于一个查看数据的窗口,其中的列可以来自多个表。视图中的数据是只读的。视图一般用于组织来自多个表的数据的结果集供用户读取。
4.1.6 触发器(trigger)
是一段 SQL 语言程序,在表的数据变动的某个时机会被自动触发执行。常常用来保证数据的一致性。
4.1.7 存储过程(Stored Procedure)
是一段被存储(stored)起来的 SQL 语言程序,用于完成特定的数据处理任务。可在其它 SQL 语言程序中根据需要调用它。
4.1.8 函数(Function)
它也是一段 SQL 语言程序,用于完成特定的数据处理任务。与存储过程不同的是,它不能返回结果集,只能返回单一值,同时,调用方法也不同。
4.2 需求描述
需求描述主要描述的是客户对数据处理(增、删、改、查)的基本需求,它是我们测试数据库设计的标尺。
需求描述通常按照一定条理(按实体罗列或按事务处理过程罗列等),梳理出对数据的处理需求,便于阅读理解和测试。
4.3 实体关系的图示表示
业界有多种实体关系图,本教程将采用使用较为普遍的“乌鸦脚”画法。
对实体关系的解读我们将放到后续章节中每个具体实例中去理解。
第五章 案例一 单表:员工信息
数据库名称: c1_emp_db( 备份下载页面)
5.1 解读设计稿
5.1.1 需求描述
某公司需要用软件对员工(Employee)进行管理。主要需求描述如下:
1、能够列出员工所在的所有部门;
2、能够按照姓名查找员工;
3、能够查找某个年龄段的员工并按年龄进行升序、降序排序;
4、能够查找某月薪段的员工并按月薪进行升序、降序排序;
5、能够找出最近一年入职的所有员工;
6、能够按部门名称统计员工人数、月薪总额及平均月薪;
7、能够按部门统计员工的平均年龄。
5.1.1 E-R图(实体关系图)
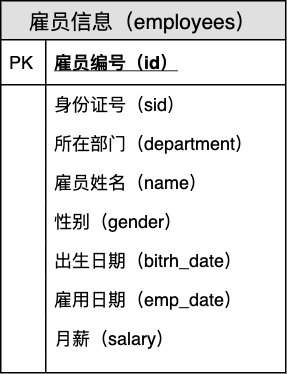
图中只有一个实体。方框的顶行是实体名称“雇员信息”和对应的表名“employees”。从第二行开始,分两列。第一列为实体属性是何种关键列的标识,第二列为实体的属性名称。
从图中可以清晰地看出,这是一个“雇员”实体,它具有“雇员编号”、“所在部门”、“雇员姓名”、“性别”、“出生日期”、“雇用日期”、“月薪”等属性,且其中的“雇员编号”具有“PK”字样的关键列标识。
PK,Primary Key,即主键。主键列是这样一列:每一行记录的这一列的值都是不同的(否则不可能作为主键列),它可以保证表中绝对不会出现完全相同(各列均完全相同)的两行记录。
主键列可以由多列组合构成,多列构成的主键列,它们的组合不可能出现重复(否则不可能组合做主键)。
5.1.2 数据字典
(1)表定义
表名:雇员信息( employees)
| 序号 | 列名 | 英文名 | 数据类型 | 不能为NULL? | 关键列 | 默认值 | 其它说明 |
|---|---|---|---|---|---|---|---|
| 1 | 雇员编号 | id | 无符号大整数 | BIGINT UNSIGNED | ✓ | 主要 | NULL | 自动增长 |
| 2 | 身份证号 | sid | 定长字符串(18)| CHAR(18) | ✓ | 唯一 | NULL | |
| 3 | 所在部门 | department | 变长字符串(50)| VARCHAR(50) | NULL | |||
| 4 | 雇员姓名 | name | 变长字符串(50)| VARCHAR(50) | ✓ | NULL | ||
| 5 | 性别 | gender | 定长字符串(1)| CHAR(1) | '男' | 取值限于「男」、「女」 | ||
| 6 | 出生日期 | birth_date | 日期 | date | NULL | |||
| 7 | 雇用日期 | emp_date | 日期 | date | NULL | |||
| 8 | 月薪 | salary | 无符号小数(8 位数字,其中两位小数)| decimal(10,2) unsigned | 0.00 |
(2)触发器
表名:雇员信息( employees)
| 序号 | 名称 | 时机 | 功能 | 其它 |
|---|---|---|---|---|
| 1 | trigger_for_ins | 插入前 | 根据身份证号取出出生日期与性别信息填入相应列, 以保证出生日期和性别与身份证上的信息一致。 |
|
| 2 | trigger_for_upd | 更新前 | 同上 |
(3)视图
(无)
(4)存储过程
(无)
(5)函数
(无)
(6)用户及权限
| 用户名 | 登录位置 | 初始密码 | 权限说明 |
|---|---|---|---|
| c1_emp_db_admin | 所有 | 000000 | 对数据库具有所有权限 |
| c1_emp_db_user | 所有 | 000000 | 对数据库表具有增、删、改、查权限 |
5.2 导入备份并进入数据库
5.2.1 导入备份数据
从随书光盘中拷贝(或从指定网址下载)c1_emp_db_with_users.zip 到硬盘,解压得到 c1_emp_db_with_users.sql 文件,以下假定文件被解压到了 D 盘根文件夹下。
打开 Windows 的命令窗口,在命令行打入以下命令并回车:
C:\Users\Administrator>mysql -uroot -p --default-character-set=utf8mb4 < d:\c1_emp_db_with_users.sqlEnter password: ******C:\Users\Administrator>
输入您的root用户的密码回车后,如果没有任何提示信息,说明导入备份数据成功!
注意:由于此备份导入了系统数据库 mysql,您原有的 root 用户的密码被设为了 000000 (六个0)!!!
5.2.2 进入数据库
您可用 c1_emp_db_admin 或者 root 用户名进入数据库。
C:\Users\Administrator> mysql -uc1_emp_db_admin -pEnter password: ******Welcome to the MariaDB monitor. Commands end with ; or \g.Your MariaDB connection id is 32Server version: 10.4.17-MariaDB mariadb.org binary distributionCopyright (c) 2000, 2018, Oracle, MariaDB Corporation Ab and others.Type 'help;' or '\h' for help. Type '\c' to clear the current input statement.MariaDB [(none)]> use c1_emp_db;Database changedMariaDB [c1_emp_db]>
看到 MariaDB [c1_emp_db]>提示符后,您就成功进行了数据库,可以边学习边做后面的练习了。
5.3 查看数据
5.3.1 查看表的信息
列出当前数据库的所有表:
MariaDB [c1_emp_db]> show tables;+-----------------------+| Tables_in_c1_emp_db |+-----------------------+| employees |+-----------------------+1 rows in set (0.000 sec)MariaDB [c1_emp_db]> show full tables; -- 可区分普通表 (BASE TABLE) 和视图 (VIEW)+-----------------------+------------+| Tables_in_c1_emp_db | Table_type |+-----------------------+------------+| employees | BASE TABLE |+-----------------------+------------+1 rows in set (0.000 sec)
查看表(比如表: employees)的结构信息:
MariaDB [c1_emp_db]> describe employees;+------------+-----------------------+------+-----+---------+----------------+| Field | Type | Null | Key | Default | Extra |+------------+-----------------------+------+-----+---------+----------------+| id | bigint(20) unsigned | NO | PRI | NULL | auto_increment || sid | char(18) | NO | UNI | NULL | || department | varchar(50) | YES | | NULL | || name | varchar(50) | NO | | NULL | || gender | char(1) | YES | | 男 | || birth_date | date | YES | | NULL | || emp_date | date | YES | | NULL | || salary | decimal(8,2) unsigned | YES | | 0.00 | |+------------+-----------------------+------+-----+---------+----------------+8 rows in set (0.005 sec)MariaDB [c1_emp_db]>
describe, 描述,在此可简写为 desc。
查看表(比如表:employees)的建立脚本:
MariaDB [c1_emp_db]> show create table `employees`\G*************************** 1. row ***************************Table: employeesCreate Table: CREATE TABLE `employees` (`id` bigint(20) unsigned NOT NULL AUTO_INCREMENT,`sid` char(18) COLLATE utf8mb4_unicode_ci NOT NULL,`department` varchar(50) COLLATE utf8mb4_unicode_ci DEFAULT NULL,`name` varchar(50) COLLATE utf8mb4_unicode_ci NOT NULL,`gender` char(1) COLLATE utf8mb4_unicode_ci DEFAULT '男',`birth_date` date DEFAULT NULL,`emp_date` date DEFAULT NULL,`salary` decimal(8,2) unsigned DEFAULT 0.00,PRIMARY KEY (`id`),UNIQUE KEY `employees_sid_unique` (`sid`),CONSTRAINT `chk_gender` CHECK (`gender` in ('男','女'))) ENGINE=InnoDB AUTO_INCREMENT=89 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_unicode_ci1 row in set (0.000 sec)MariaDB [c1_emp_db]>
5.3.2 查看所有数据
语法:
select 逗号分隔的列名列表 from 表名;
其中,“逗号分隔的列名列表”可以是全部列也可以是部分列,全部列也可用 * 号代替。
如果 SQL 语句过长,可在必要时回车换行,控制台会另起一行,并出现 -> 提示符,您可继续输出余下的语句内容并多次换行,只有按下 ;(英文分号) 并回车后,语句才会被执行。
MariaDB [c1_emp_db]> select `id`,`sid`,`name`,`gender`,`birth_date`,`emp_date`,`salary`-> from `employees`;
| id | sid | name | gender | birth_date | emp_date | salary |
|---|---|---|---|---|---|---|
| 1 | 150823198909029321 | 吕玉珍 | 女 | 1989-09-02 | 2017-12-24 | 7998.00 |
| 2 | 140622199005045316 | 郜欣 | 男 | 1990-05-04 | 2019-06-27 | 2888.00 |
| 3 | 360401199112026944 | 葛丽 | 女 | 1991-12-02 | 2018-10-16 | 8267.00 |
| 4 | 210811198404141562 | 成丽 | 女 | 1984-04-14 | 2012-12-06 | 4838.00 |
| .. | ...... | ... | ... | ... | ... | ... |
| 87 | 810000196904140531 | 项健 | 男 | 1969-04-14 | 1996-05-06 | 6164.00 |
| 88 | 500232197502127979 | 蔺志文 | 男 | 1975-02-12 | 2015-11-26 | 9273.00 |
88 rows in set (0.001 sec)
select:选择,from: 从
或:
MariaDB [c1_emp_db]> select * from `employees`;
| id | sid | name | gender | birth_date | emp_date | salary |
|---|---|---|---|---|---|---|
| 1 | 150823198909029321 | 吕玉珍 | 女 | 1989-09-02 | 2017-12-24 | 7998.00 |
| 2 | 140622199005045316 | 郜欣 | 男 | 1990-05-04 | 2019-06-27 | 2888.00 |
| 3 | 360401199112026944 | 葛丽 | 女 | 1991-12-02 | 2018-10-16 | 8267.00 |
| 4 | 210811198404141562 | 成丽 | 女 | 1984-04-14 | 2012-12-06 | 4838.00 |
| .. | ...... | ... | ... | ... | ... | ... |
| 87 | 810000196904140531 | 项健 | 男 | 1969-04-14 | 1996-05-06 | 6164.00 |
| 88 | 500232197502127979 | 蔺志文 | 男 | 1975-02-12 | 2015-11-26 | 9273.00 |
88 rows in set (0.001 sec)
5.3.3 记录排序
1、查看所有记录并按月薪从高到低排序
MariaDB [c1_emp_db]> select * from `employees` order by `salary` desc;
| id | sid | department | name | gender | birth_date | emp_date | salary |
|---|---|---|---|---|---|---|---|
| 79 | 530121196304243780 | 营销部 | 包琳 | 女 | 1963-04-24 | 2002-10-13 | 9976.00 |
| 61 | 140601198903101846 | 市场部 | 畅瑜 | 女 | 1989-03-10 | 2014-09-26 | 9906.00 |
| 81 | 340222198204055630 | 公关部 | 谌正豪 | 男 | 1982-04-05 | 2008-05-06 | 9896.00 |
| 7 | 341522199602170935 | 财务部 | 姜钟 | 男 | 1996-02-17 | 2019-08-31 | 9805.00 |
| 49 | 310115198607170313 | 公关部 | 李瑞 | 男 | 1986-07-17 | 2018-03-09 | 9760.00 |
| .. | ...... | ... | ... | ... | ... | ... | ... |
| 5 | 420303196702223622 | 财务部 | 孙文 | 女 | 1967-02-22 | 2000-04-19 | 2604.00 |
| 25 | 211403197706118012 | 公关部 | 汪子安 | 男 | 1977-06-11 | 2008-11-07 | 2558.00 |
88 rows in set (0.001 sec)
order: 排序
by: 依据
desc: descend 下降
2、查看所有记录并按月薪从低到高排序
MariaDB [c1_emp_db]> select * from `employees` order by `salary` asc;
| id | sid | department | name | gender | birth_date | emp_date | salary |
|---|---|---|---|---|---|---|---|
| 25 | 211403197706118012 | 公关部 | 汪子安 | 男 | 1977-06-11 | 2008-11-07 | 2558.00 |
| 5 | 420303196702223622 | 财务部 | 孙文 | 女 | 1967-02-22 | 2000-04-19 | 2604.00 |
| 65 | 310115198011071277 | 人力资源部 | 叶涛 | 男 | 1980-11-07 | 2017-09-07 | 2746.00 |
| 84 | 430802199601117050 | 财务部 | 童哲 | 男 | 1996-01-11 | 2019-07-10 | 2871.00 |
| 2 | 140622199005045316 | 市场部 | 郜欣 | 男 | 1990-05-04 | 2019-06-27 | 2888.00 |
| ... | ... | ... | ... | ... | ... | ... | ... |
| 61 | 140601198903101846 | 市场部 | 畅瑜 | 女 | 1989-03-10 | 2014-09-26 | 9906.00 |
| 79 | 530121196304243780 | 营销部 | 包琳 | 女 | 1963-04-24 | 2002-10-13 | 9976.00 |
88 rows in set (0.001 sec)
asc: ascend, 上升。默认,可省略
3、查看所有记录并按姓名拼音升序(a~z)排序。
MariaDB [c1_emp_db]> select *from `employees`order by convert(`name` using gbk);
| id | sid | department | name | gender | birth_date | emp_date | salary |
|---|---|---|---|---|---|---|---|
| 21 | 330683199403206443 | 研发部 | 安秀梅 | 女 | 1994-03-20 | 2020-01-14 | 5216.00 |
| 8 | 652201196504217113 | 人力资源部 | 安正平 | 男 | 1965-04-21 | 2001-05-03 | 8571.00 |
| 79 | 530121196304243780 | 营销部 | 包琳 | 女 | 1963-04-24 | 2002-10-13 | 9976.00 |
| 47 | 450701199202246412 | 研发部 | 边子安 | 男 | 1992-02-24 | 2017-08-26 | 8611.00 |
| 69 | 420525196009185030 | 财务部 | 卜岩 | 男 | 1960-09-18 | 2015-02-20 | 5736.00 |
| ... | ... | ... | ... | ... | ... | ... | ... |
| 42 | 130401197310014432 | 公关部 | 仲智勇 | 男 | 1973-10-01 | 2011-07-10 | 8375.00 |
| 52 | 220200197706054080 | 财务部 | 朱晨 | 女 | 1977-06-05 | 2018-02-10 | 6220.00 |
88 rows in set (0.001 sec)
convert: 转换
using: 使用
gbk: 汉字内码扩展规范名称
5.3.4 修改返回的列名
以下例子分别将原字段名改成对应的中文含义。
MariaDB [c1_emp_db]> select `id` as `编号`, `name` as `姓名`, `department` as `部门`, `salary` as `月薪`-> from `employees`;
| 编号 | 姓名 | 部门 | 月薪 |
|---|---|---|---|
| 1 | 吕玉珍 | 营销部 | 7998.00 |
| 2 | 郜欣 | 市场部 | 2888.00 |
| 3 | 葛丽 | 营销部 | 8267.00 |
| 4 | 成丽 | 财务部 | 4838.00 |
| 5 | 孙文 | 财务部 | 2604.00 |
| ... | ... | ... | ... |
| 87 | 项健 | 营销部 | 6164.00 |
| 88 | 蔺志文 | 人力资源部 | 9273.00 |
88 rows in set (0.000 sec)
5.3.5 限定返回的记录数
以下例子限定返回的记录数为10条。
MariaDB [c1_emp_db]> select * from `employees` limit 10;
| id | sid | department | name | gender | birth_date | emp_date | salary |
|---|---|---|---|---|---|---|---|
| 1 | 150823198909029321 | 营销部 | 吕玉珍 | 女 | 1989-09-02 | 2017-12-24 | 7998.00 |
| 2 | 140622199005045316 | 市场部 | 郜欣 | 男 | 1990-05-04 | 2019-06-27 | 2888.00 |
| 3 | 360401199112026944 | 营销部 | 葛丽 | 女 | 1991-12-02 | 2018-10-16 | 8267.00 |
| 4 | 210811198404141562 | 财务部 | 成丽 | 女 | 1984-04-14 | 2012-12-06 | 4838.00 |
| 5 | 420303196702223622 | 财务部 | 孙文 | 女 | 1967-02-22 | 2000-04-19 | 2604.00 |
| 6 | 542621199008267467 | 人力资源部 | 詹淑华 | 女 | 1990-08-26 | 2016-09-21 | 9284.00 |
| 7 | 341522199602170935 | 财务部 | 姜钟 | 男 | 1996-02-17 | 2019-08-31 | 9805.00 |
| 8 | 652201196504217113 | 人力资源部 | 安正平 | 男 | 1965-04-21 | 2001-05-03 | 8571.00 |
| 9 | 430901197012101659 | 研发部 | 项博涛 | 男 | 1970-12-10 | 2001-08-21 | 3933.00 |
| 10 | 460201196204156761 | 营销部 | 冉秀梅 | 女 | 1962-04-15 | 2009-08-14 | 5830.00 |
10 rows in set (0.000 sec)
limit: 限定,极限
5.3.6 指定跨过的记录数
以下例子将跨过30条记录后获取10条记录。
MariaDB [c1_emp_db]> select * from `employees` limit 30, 10;
| id | sid | department | name | gender | birth_date | emp_date | salary |
|---|---|---|---|---|---|---|---|
| 31 | 520381198301036123 | 市场部 | 房敏 | 女 | 1983-01-03 | 2009-08-14 | 7332.00 |
| 32 | 62290119690504333X | 营销部 | 钱峰 | 男 | 1969-05-04 | 2009-09-25 | 8149.00 |
| 33 | 340803196606252850 | 人力资源部 | 娄志勇 | 男 | 1966-06-25 | 2017-01-25 | 3226.00 |
| 34 | 340301197409035165 | 营销部 | 董娜 | 女 | 1974-09-03 | 2015-09-19 | 9608.00 |
| 35 | 460101197806262931 | 公关部 | 卫正诚 | 男 | 1978-06-26 | 2003-06-01 | 8967.00 |
| 36 | 542429197505158350 | 人力资源部 | 沙建国 | 男 | 1975-05-15 | 2010-07-12 | 9495.00 |
| 37 | 360203198810295524 | 营销部 | 滕丹 | 女 | 1988-10-29 | 2018-10-01 | 4597.00 |
| 38 | 421221196708042265 | 市场部 | 翟文 | 女 | 1967-08-04 | 2003-01-10 | 6171.00 |
| 39 | 522726198910203731 | 营销部 | 蔺志文 | 男 | 1989-10-20 | 2019-08-17 | 9456.00 |
| 40 | 41110219710830336X | 财务部 | 姜梅 | 女 | 1971-08-30 | 2009-11-18 | 6860.00 |
10 rows in set (0.000 sec)
或:
MariaDB [c1_emp_db]> select * from `employees` limit 10 offset 30;
| id | sid | department | name | gender | birth_date | emp_date | salary |
|---|---|---|---|---|---|---|---|
| 31 | 520381198301036123 | 市场部 | 房敏 | 女 | 1983-01-03 | 2009-08-14 | 7332.00 |
| 32 | 62290119690504333X | 营销部 | 钱峰 | 男 | 1969-05-04 | 2009-09-25 | 8149.00 |
| 33 | 340803196606252850 | 人力资源部 | 娄志勇 | 男 | 1966-06-25 | 2017-01-25 | 3226.00 |
| 34 | 340301197409035165 | 营销部 | 董娜 | 女 | 1974-09-03 | 2015-09-19 | 9608.00 |
| 35 | 460101197806262931 | 公关部 | 卫正诚 | 男 | 1978-06-26 | 2003-06-01 | 8967.00 |
| 36 | 542429197505158350 | 人力资源部 | 沙建国 | 男 | 1975-05-15 | 2010-07-12 | 9495.00 |
| 37 | 360203198810295524 | 营销部 | 滕丹 | 女 | 1988-10-29 | 2018-10-01 | 4597.00 |
| 38 | 421221196708042265 | 市场部 | 翟文 | 女 | 1967-08-04 | 2003-01-10 | 6171.00 |
| 39 | 522726198910203731 | 营销部 | 蔺志文 | 男 | 1989-10-20 | 2019-08-17 | 9456.00 |
| 40 | 41110219710830336X | 财务部 | 姜梅 | 女 | 1971-08-30 | 2009-11-18 | 6860.00 |
10 rows in set (0.000 sec)
offset: 偏移量
5.3.7返回不重复的数据
查看表中的所有部门(不重复):
MariaDB [c1_emp_db]> select distinct `department` from `employees`;
| department |
|---|
| 营销部 |
| 市场部 |
| 财务部 |
| 人力资源部 |
| 研发部 |
| 公关部 |
6 rows in set (0.001 sec)
distinct: 截然不同的
如果 distinct 后面跟着多个列,则返回多个不重复的组合值。
5.3.8 筛选符合条件的记录
条件是由逻辑运算“串”起来的比较表达式构成的。
比较表达式:两个量之间的比较运算(运算:>, <, =, ...)。
如:月薪大于等于3000(salary>=3000),年龄介于30到50岁之间(age between 30 and 50)等。
逻辑表达式:两个比较表达式之间的关系运算(运算:AND, OR,NOT)。
如:
月薪大于等于3000 并且 年龄介于30到50岁之间(salary>=3000 AND age between 30 and 50);
AND: 与,并且。运算规则:两者都满足结果才能满足。
月薪大于等于3000 或者 年龄介于30到50岁之间(salary>=3000 OR age between 30 and 50);
OR: 或者。运算规则:只要一个满足结果就能满足。
月薪不大于3000 或者 年龄在30到50岁之外(salary<=3000 OR age not between 30 and 50);
请参阅:附录二:“MySQL/MariaDB 比较运算与逻辑运算”
1、找出姓名包含“玉”字的员工。
一个 % 号代表零到任意多个字符组合,'%玉%' 表示 “玉” 可以出现在姓名中的任意位置。
MariaDB [c1_emp_db]> select * from `employees` where `name` like '%玉%';
| id | sid | department | name | gender | birth_date | emp_date | salary |
|---|---|---|---|---|---|---|---|
| 1 | 150823198909029321 | 营销部 | 吕玉珍 | 女 | 1989-09-02 | 2017-12-24 | 7998.00 |
| 56 | 710000198704188325 | 市场部 | 蔡玉珍 | 女 | 1987-04-18 | 2019-09-19 | 9642.00 |
| 74 | 532822199007202982 | 研发部 | 岳玉 | 女 | 1990-07-20 | 2014-03-19 | 5635.00 |
3 rows in set (0.000 sec)
2、找出姓名开始于“李”的员工
一个 % 号代表零到任意多个字符组合,'李%' 表示 “李” 必须出现在姓名的开头位置。
MariaDB [c1_emp_db]> select * from `employees` where `name` like '李%';
| id | sid | department | name | gender | birth_date | emp_date | salary |
|---|---|---|---|---|---|---|---|
| 49 | 310115198607170313 | 公关部 | 李瑞 | 男 | 1986-07-17 | 2018-03-09 | 9760.00 |
1 row in set (0.000 sec)
3、找出姓名结尾是“明”的员工
一个 % 号代表零到任意多个字符组合,'%明' 表示 “明” 必须出现在姓名的最后位置。
MariaDB [c1_emp_db]> select * from `employees` where `name` like '%明';
| id | sid | department | name | gender | birth_date | emp_date | salary |
|---|---|---|---|---|---|---|---|
| 16 | 350900198105302677 | 研发部 | 晋明 | 男 | 1981-05-30 | 2016-05-31 | 4845.00 |
1 row in set (0.000 sec)
4、选出月薪不低于 3000 且不高于 5000 的雇员并按月薪降序排序。
MariaDB [c1_emp_db]> select * from `employees`where `salary`>=3000 and `salary`<=5000order by `salary` desc;-- 或者MariaDB [c1_emp_db]> select * from `employees`where `salary` between 3000 and 5000order by `salary` desc;
| id | sid | department | name | gender | birth_date | emp_date | salary |
|---|---|---|---|---|---|---|---|
| 16 | 350900198105302677 | 研发部 | 晋明 | 男 | 1981-05-30 | 2016-05-31 | 4845.00 |
| 4 | 210811198404141562 | 财务部 | 成丽 | 女 | 1984-04-14 | 2012-12-06 | 4838.00 |
| 15 | 360202196811067544 | 研发部 | 吉洁 | 女 | 1968-11-06 | 2016-10-07 | 4630.00 |
| 33 | 340803196606252850 | 人力资源部 | 娄志勇 | 男 | 1966-06-25 | 2017-01-25 | 3226.00 |
| 54 | 500243196107204457 | 公关部 | 伍宁 | 男 | 1961-07-20 | 2005-08-26 | 3197.00 |
| ... | ... | ... | ... | ... | ... | ... | ... |
| 59 | 340203196112181877 | 人力资源部 | 全辉 | 男 | 1961-12-18 | 2002-06-04 | 3177.00 |
| 68 | 421222198209160545 | 营销部 | 丛莹 | 女 | 1982-09-16 | 2019-10-05 | 3127.00 |
15 rows in set (0.000 sec)
where: 哪里;在那里(在表那里)
5、选出月薪不低于 3000 的男性雇员。
MariaDB [c1_emp_db]> select * from `employees`where `salary`>=3000 and `gender`='男';
| id | sid | department | name | gender | birth_date | emp_date | salary |
|---|---|---|---|---|---|---|---|
| 7 | 341522199602170935 | 财务部 | 姜钟 | 男 | 1996-02-17 | 2019-08-31 | 9805.00 |
| 8 | 652201196504217113 | 人力资源部 | 安正平 | 男 | 1965-04-21 | 2001-05-03 | 8571.00 |
| 9 | 430901197012101659 | 研发部 | 项博涛 | 男 | 1970-12-10 | 2001-08-21 | 3933.00 |
| 12 | 442000198409245311 | 营销部 | 江鑫 | 男 | 1984-09-24 | 2019-08-18 | 5759.00 |
| 13 | 210781197101054655 | 市场部 | 梅欣 | 男 | 1971-01-05 | 2005-04-18 | 6428.00 |
| ... | ... | ... | ... | ... | ... | ... | ... |
| 87 | 810000196904140531 | 营销部 | 项健 | 男 | 1969-04-14 | 1996-05-06 | 6164.00 |
| 88 | 500232197502127979 | 人力资源部 | 蔺志文 | 男 | 1975-02-12 | 2015-11-26 | 9273.00 |
45 rows in set (0.001 sec)
5.4 统计与计算数据
5.4.1 统计
(1)统计雇员总数
count(*) 中的 * 代表所有列的组合。
MariaDB [c1_emp_db]> select count(*) from `employees`;+----------+| count(*) |+----------+| 88 |+----------+1 row in set (0.000 sec)
count:计数
(2)统计月薪总额
MariaDB [c1_emp_db]> select sum(`salary`) from `employees`;+---------------+| sum(`salary`) |+---------------+| 577822.00 |+---------------+1 row in set (0.000 sec)
sum:总计,总和
(3)计算月薪平均值
MariaDB [c1_emp_db]> select avg(`salary`) from `employees`;+---------------+| avg(`salary`) |+---------------+| 6566.159091 |+---------------+1 row in set (0.000 sec)
avg: average, 平均值
同时统计以上三项数据并重新命名
MariaDB [c1_emp_db]> select count(*) as `雇员数`, sum(`salary`) as `月薪总额`, avg(`salary`) as `平均月薪`-> from `employees`;
| 雇员数 | 月薪总额 | 平均月薪 |
|---|---|---|
| 88 | 577822.00 | 6566.159091 |
1 row in set (0.000 sec)
(4)按部门分组统计
MariaDB [c1_emp_db]> select department as 部门, count(*) as 雇员数, sum(salary) as 月薪总额, avg(salary) as 平均月薪-> from employees group by department;
| 部门 | 雇员数 | 月薪总额 | 平均月薪 |
|---|---|---|---|
| 人力资源部 | 12 | 82733.00 | 6894.416667 |
| 公关部 | 15 | 101839.00 | 6789.266667 |
| 市场部 | 14 | 93156.00 | 6654.000000 |
| 研发部 | 13 | 81609.00 | 6277.615385 |
| 营销部 | 20 | 132053.00 | 6602.650000 |
| 财务部 | 14 | 86432.00 | 6173.714286 |
6 rows in set (0.001 sec)
group: 小组;分组。
group by: 依据 ... 分组。
5.4.2 计算
(1)在查询输出中显示员工的年龄
注意,以下例子输出的年龄与当前日期有关,您的输出结果有可能不同。
MariaDB [c1_emp_db]> select id,name,department,birth_date,TIMESTAMPDIFF(YEAR, birth_date, CURDATE()) as age-> from employees;
| id | name | department | birth_date | age |
|---|---|---|---|---|
| 1 | 吕玉珍 | 营销部 | 1989-09-02 | 31 |
| 2 | 郜欣 | 市场部 | 1990-05-04 | 30 |
| 3 | 葛丽 | 营销部 | 1991-12-02 | 29 |
| 4 | 成丽 | 财务部 | 1984-04-14 | 36 |
| 5 | 孙文 | 财务部 | 1967-02-22 | 54 |
| 85 | 伍强 | 营销部 | 1994-05-20 | 26 |
| .. | ... | ... | ... | ... |
| 87 | 项健 | 营销部 | 1969-04-14 | 51 |
| 88 | 蔺志文 | 人力资源部 | 1975-02-12 | 46 |
88 rows in set (0.001 sec)
当前日期:CURDATE(),current cate(当前日期)的单词组合。
其中,TIMESTAMPDIFF()为计算两个日期之间的距离函数。
用法:TIMESTAMPDIFF(时间单位, 日期时间 1, 日期时间 2)
TIMESTAMPDIFF, timestamp difference (时间戳差异)的单词组合。
时间单位:FRAC_SECOND(毫秒),SECOND(秒),MINUTE(分),HOUR(小时) ,DAY(天),WEEK(周),MONTH(月),QUARTER(季度), YEAR()。
(2)查找某年龄段的员工并按年龄进行降序排序
查找年龄介于 30 到 40 岁之间的员工并按年龄进行降序排序
MariaDB [c1_emp_db]> select id,name,department,birth_date,TIMESTAMPDIFF(YEAR, birth_date, CURDATE()) as age-> from employees-> where TIMESTAMPDIFF(YEAR, birth_date, CURDATE()) between 30 and 40-> order by age desc;
| id | name | department | birth_date | age |
|---|---|---|---|---|
| 65 | 叶涛 | 人力资源部 | 1980-11-07 | 40 |
| 55 | 袁彬 | 财务部 | 1980-08-17 | 40 |
| 16 | 晋明 | 研发部 | 1981-05-30 | 39 |
| 31 | 房敏 | 市场部 | 1983-01-03 | 38 |
| 81 | 谌正豪 | 公关部 | 1982-04-05 | 38 |
| 68 | 丛莹 | 营销部 | 1982-09-16 | 38 |
| 51 | 段晧 | 人力资源部 | 1983-04-24 | 37 |
| 12 | 江鑫 | 营销部 | 1984-09-24 | 36 |
| 4 | 成丽 | 财务部 | 1984-04-14 | 36 |
| 70 | 都军 | 营销部 | 1984-07-27 | 36 |
| ... | ... | ... | ... | ... |
| 78 | 闵璐 | 营销部 | 1990-06-11 | 30 |
| 45 | 康晶 | 市场部 | 1991-01-01 | 30 |
27 rows in set (0.001 sec)
注意: where 子句中不能用列的别名(如:age)。
(3)找出最近一年入职的员工
注意:输出结果与当前日期有关,您的输出结果可能不同。
MariaDB [c1_emp_db]> select curdate();+------------+| curdate() |+------------+| 2020-03-18 |+------------+1 row in set (0.000 sec)MariaDB [c1_emp_db]> select * from employees where emp_date>=date_sub(curdate(),interval 1 year);
| id | sid | department | name | gender | birth_date | emp_date | salary |
|---|---|---|---|---|---|---|---|
| 2 | 140622199005045316 | 市场部 | 郜欣 | 男 | 1990-05-04 | 2019-06-27 | 2888.00 |
| 7 | 341522199602170935 | 财务部 | 姜钟 | 男 | 1996-02-17 | 2019-08-31 | 9805.00 |
| 12 | 442000198409245311 | 营销部 | 江鑫 | 男 | 1984-09-24 | 2019-08-18 | 5759.00 |
| 21 | 330683199403206443 | 研发部 | 安秀梅 | 女 | 1994-03-20 | 2020-01-14 | 5216.00 |
| 23 | 131028199608311956 | 人力资源部 | 佟辉 | 男 | 1996-08-31 | 2020-03-03 | 9445.00 |
| 26 | 341621199608142766 | 公关部 | 饶凤英 | 女 | 1996-08-14 | 2020-03-03 | 9228.00 |
| 39 | 522726198910203731 | 营销部 | 蔺志文 | 男 | 1989-10-20 | 2019-08-17 | 9456.00 |
| 56 | 710000198704188325 | 市场部 | 蔡玉珍 | 女 | 1987-04-18 | 2019-09-19 | 9642.00 |
| 58 | 500103199507033076 | 财务部 | 沿智渊 | 男 | 1995-07-03 | 2019-04-16 | 6769.00 |
| 62 | 21030219891218803X | 市场部 | 郝嘉俊 | 男 | 1989-12-18 | 2019-12-12 | 6394.00 |
| 68 | 421222198209160545 | 营销部 | 丛莹 | 女 | 1982-09-16 | 2019-10-05 | 3127.00 |
| 72 | 13042319960626768X | 财务部 | 彭莹 | 女 | 1996-06-26 | 2020-03-03 | 5639.00 |
| 73 | 35072219650304312X | 公关部 | 沿芳 | 女 | 1965-03-04 | 2020-01-08 | 4568.00 |
| 84 | 430802199601117050 | 财务部 | 童哲 | 男 | 1996-01-11 | 2019-07-10 | 2871.00 |
14 rows in set (0.000 sec)
日期减法运算:
date_sub(日期时间,interval 数量 单位)
参见日期减法运算说明
(4)统计员工平均年龄
注意:平均年龄与当前日期有关,你的结果可能不同。
MariaDB [c1_emp_db]> select avg(timestampdiff(YEAR,birth_date,now())) as avg_age from employees;+---------+| avg_age |+---------+| 41.1591 |+---------+1 row in set (0.000 sec)
5.5 增、删、改数据
5.5.1 增加记录
语法:
insert into 表名 [(列名 1,列名 2,...)] values (值 1,值 2,...)[,(值 1,值 2,...), ...];
- 表名后的列名可全部省略,省略时相当于按列自然顺序全部罗列出来了;
- 表名后的列名不用和表中列的自然顺序一致,也不需要全部罗列出来(那些不能为 NULL 的且默认值为 NULL 的列必须要列出来);
- 自动增长的列不需要列出来,当然也可列出来并指定具体值(但值重复会出错),也可指定空值(NULL),这样它会自己填入增长的数值;
- 表名后的列名的顺序必须和 values 后的值的顺序一致,并且一一对应。
插入时可根据需要只罗列出部分列,同时满足以下条件的必须罗列出来:
- 不可为空(NULL)
- 且默认值是 NULL
- 且不是自动增长的列
以下例子向雇员表中插入两条记录。注意:“id(员工编号)”、“birth_date(出生日期)” 和 “gender(性别)” 并没有提供。
MariaDB [c1_emp_db]> insert into-> `employees`(`sid`,`name`,`department`,`emp_date`,`salary`)-> values-> ('530103198803221221','李倩倩','研发部','2020-02-08',3500),-> ('530101199511232312','赵全','研发部','2020-02-08',3000);Query OK, 2 rows affected (0.007 sec)Records: 2 Duplicates: 0 Warnings: 0
Query OK : 查询(语句执行)成功;
2 rows affected (0.007 sec) : 2 行(记录)受到影响(耗时 0.007秒)
Recordes: 记录数;
Duplicates: 重复的记录数;
Warnings: 警告数。
下面来确认一下:
MariaDB [c1_emp_db]> select * from employees order by id desc limit 2;+----+--------------------+------------+--------+--------+------------+------------+---------+| id | sid | department | name | gender | birth_date | emp_date | salary |+----+--------------------+------------+--------+--------+------------+------------+---------+| 90 | 530101199511232312 | 研发部 | 赵全 | 男 | 1995-11-23 | 2020-02-08 | 3000.00 || 89 | 530103198803221221 | 研发部 | 李倩倩 | 女 | 1988-03-22 | 2020-02-08 | 3500.00 |+----+--------------------+------------+--------+--------+------------+------------+---------+2 rows in set (0.000 sec)
发现数据库中的性别和出生日期被正确填入了!
这是触发器的作用(触发器根据身份证号码计算出生日和性别后,一并填入数据表)。
初识触发器:触发器是一段 SQL 程序,它会被设定在某种情况下自动执行,如插入记录前、插入记录后、更新记录前、更新记录后、删除记录前、删除记录后等,用于在这些时间点做一些特定的工作来保证数据的完整性、联动性等。
查看触发器:
-- 列出数据库中的所有触发器MariaDB [c1_emp_db]> show triggers \G*************************** 1. row ***************************Trigger: trigger_for_ins -- 触发器名: trigger_for_insEvent: INSERT -- 事件:插入Table: employees -- 表:employeesStatement: BEGIN -- 语句:开始SET NEW.birth_date = CONCAT(SUBSTRING(NEW.sid,7,4),'-',SUBSTRING(NEW.sid,11,2),'-',SUBSTRING(NEW.sid,13,2));IF CAST(SUBSTRING(NEW.sid,17,1) AS INT) % 2 = 0 THENSET NEW.gender = '女';ELSESET NEW.gender = '男';END IF;END -- 语句:结束Timing: BEFORE -- 执行时机:之前Created: 2021-03-18 14:27:20.90sql_mode: ONLY_FULL_GROUP_BY,STRICT_TRANS_TABLES,NO_ZERO_IN_DATE,NO_ZERO_DATE,ERROR_FOR_DIVISION_BY_ZERO,NO_AUTO_CREATE_USER,NO_ENGINE_SUBSTITUTIONDefiner: root@localhostcharacter_set_client: utf8mb4collation_connection: utf8mb4_unicode_ciDatabase Collation: utf8mb4_general_ci*************************** 2. row ***************************Trigger: trigger_for_updEvent: UPDATETable: employeesStatement: BEGINSET NEW.birth_date = CONCAT(SUBSTRING(NEW.sid,7,4),'-',SUBSTRING(NEW.sid,11,2),'-',SUBSTRING(NEW.sid,13,2));IF CAST(SUBSTRING(NEW.sid,17,1) AS INT) % 2 = 0 THENSET NEW.gender = '女';ELSESET NEW.gender = '男';END IF;ENDTiming: BEFORECreated: 2021-03-18 14:27:20.92sql_mode: ONLY_FULL_GROUP_BY,STRICT_TRANS_TABLES,NO_ZERO_IN_DATE,NO_ZERO_DATE,ERROR_FOR_DIVISION_BY_ZERO,NO_AUTO_CREATE_USER,NO_ENGINE_SUBSTITUTIONDefiner: root@localhostcharacter_set_client: utf8mb4collation_connection: utf8mb4_unicode_ciDatabase Collation: utf8mb4_general_ci2 rows in set (0.004 sec)-- 查看某个触发器的详细 SQL 定义-- show create trigger 触发器名\GMariaDB [c1_emp_db]> show create trigger trigger_for_ins\G...(略去一些内容)CREATE DEFINER=`root`@`localhost` TRIGGER trigger_for_ins -- 创建触发器 trigger_for_insBEFORE INSERT -- 在插入前(被触发执行)ON `employees` -- 针对表 employeesFOR EACH ROW -- 针对表的每一行BEGIN -- 开始-- 设置新插入记录的 birth_date 为:新插入记录身份证号的第7位开始后的4位(年)- 新插入记录身份证号的第11位开始后的2位(月)-新插入记录身份证号的第13位开始后的2位(日),如:"1987-12-20".SET NEW.birth_date=CONCAT(SUBSTRING(NEW.sid,7,4),'-',SUBSTRING(NEW.sid,11,2),'-',SUBSTRING(NEW.sid,13,2));-- 开始判断:如果新插入记录身份证号的第17位开始后的1位是偶数:IF CAST(SUBSTRING(NEW.sid,17,1) AS INT) % 2 = 0 THEN-- 设置新插入记录的 gender 为 '女'SET NEW.gender = '女';-- 否则ELSE-- 设置新插入记录的 gender 为 '男'SET NEW.gender = '男';END IF; -- 判断结束END -- 结束...
concat(字符串1, 字符串2, ...) 函数:将逗号分隔的字符串串接起来,构成更长的字符串。如:concat('I ','am ','so ','happy','!') 将构成新的长字符串:'I am so happy!'。
sunstring(字符串, 起始位置, 字符个数) 函数,从字符串中取子串,第一个参数是字符串,第二个参数是起始位置(从1开始),第三个参数是要几个字符,省略则取到末尾。如:substring('I am so happy!', 3, 2) 会取得 'am', substring('I am so happy!', 3) 会取得 'am so happy!'
cast(值 as 类型) 函数,将其中的值转换成其它数据类型,如:cast('123' as integer), 会把字符串 '123' 变成整数数值的 123。
% 运算符,取余数。如 81%2 得到 1,8%3 得到 2。
5.5.2 修改记录
语法:
UPDATE 表名 SET 列名1=值1, 列名2=值2, ... where 条件;
以下例子将编号为 18 的员工信息进行了更改。
MariaDB [c1_emp_db]> select * from employees where id=18;+----+--------------------+------------+------+--------+------------+------------+---------+| id | sid | department | name | gender | birth_date | emp_date | salary |+----+--------------------+------------+------+--------+------------+------------+---------+| 18 | 522702196607274182 | 研发部 | 车文 | 女 | 1966-07-27 | 1998-03-27 | 9094.00 |+----+--------------------+------------+------+--------+------------+------------+---------+1 row in set (0.000 sec)MariaDB [c1_emp_db]> update employees set name='车小文', gender='男' where id=18;Query OK, 1 row affected (0.007 sec)Rows matched: 1 Changed: 1 Warnings: 0MariaDB [c1_emp_db]> select * from employees where id=18; 18;+----+--------------------+------------+--------+--------+------------+------------+---------+| id | sid | department | name | gender | birth_date | emp_date | salary |+----+--------------------+------------+--------+--------+------------+------------+---------+| 18 | 522702196607274182 | 研发部 | 车小文 | 女 | 1966-07-27 | 1998-03-27 | 9094.00 |+----+--------------------+------------+--------+--------+------------+------------+---------+1 row in set (0.000 sec)
update: 更新
Rows matched: 1 Changed: 1 Warnings: 0
匹配的行数:1 已被更改的记录数:1 警告
问题:性别更改为什么不成功?
5.5.3 删除记录
语法:
DELETE FROM 表名 WHERE 条件;
(1)按条件删除记录
以下例子删除身份证号为 “522702196607274182” 的员工
MariaDB [c1_emp_db]> delete from employees where sid='522702196607274182';Query OK, 1 row affected (0.004 sec)MariaDB [c1_emp_db]>
(2)删除全部记录
没有确认机会,慎重!慎重!!慎重!!!
MariaDB [c1_emp_db]> delete from employees;Query OK, 89 rows affected (0.007 sec)MariaDB [c1_emp_db]>
delete: 删除
5.6 验证需求描述中需要实现的功能
5.6.1 能够列出员工所在的所有部门;
select distinct `department` from `employees`;
5.6.2 能够按照姓名查找员工;
select * from employees where name='伍宁';select * from `employees` where `name` like '%娜%';
5.6.3 能够查找某个年龄段的员工并按年龄进行升序、降序排序;
5.6.4 能够查找某月薪段的员工并按月薪进行升序、降序排序;
5.6.5 能够找出最近一年入职的所有员工;
5.6.6 能够按部门名称统计员工人数、月薪总额及平均月薪;
5.6.7 能够按部门统计员工的平均年龄。
第六章 案例二 一对多关系:部门与员工管理
数据库: c2_dept_db (备份下载)
6.1 基础知识:表的连接查询
如何解读 E-R图中的连接。
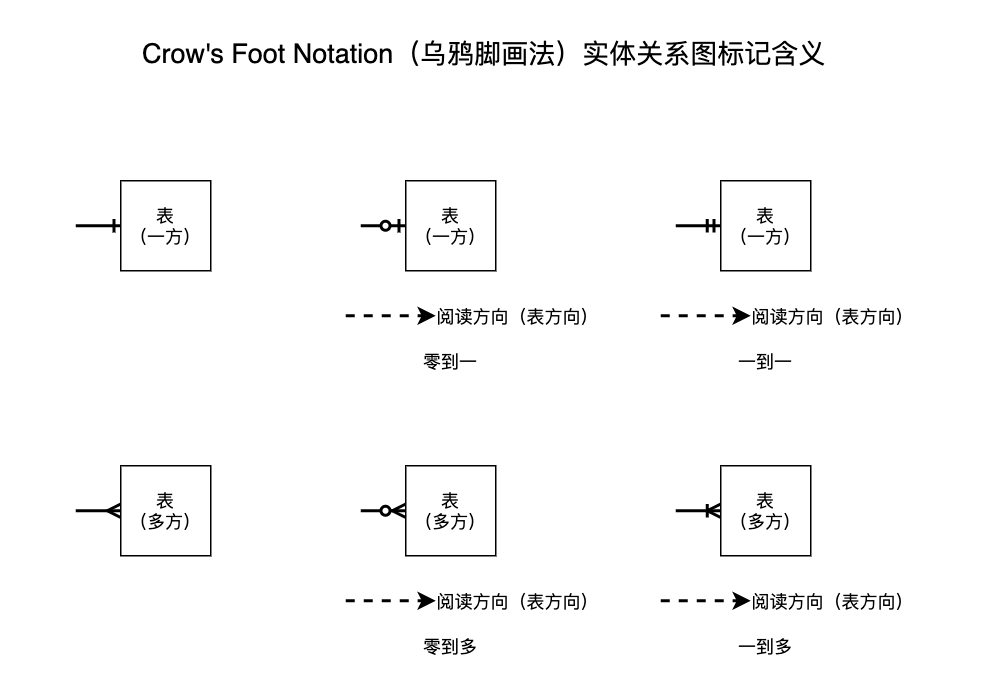
涉及数据库: misc (请用 root 登录使用)
use misc;
城市列表:
MariaDB [misc]> select * from cities;+----+--------+| id | name |+----+--------+| 1 | 昆明 || 2 | 上海 || 3 | 北京 |+----+--------+3 rows in set (0.000 sec)MariaDB [misc]>
与会者列表:
MariaDB [misc]> select * from attendees;+----+-----------+--------------+| id | name | from_city_id |+----+-----------+--------------+| 1 | 李强 | 1 || 2 | 周小妮 | 1 || 3 | 吴汉明 | 2 || 4 | 郑治国 | NULL |+----+-----------+--------------+4 rows in set (0.000 sec)MariaDB [misc]>
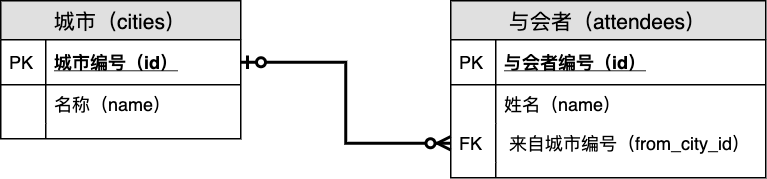
与会者的 from_city_id 填的是某个城市的编号(id)。
所以,与会者表参照了城市表。
从数据可以看出,一名与会者可对应一个城市(来自一个城市),而一个城市可有多名与会者。城市与与会者二者是一对多的关系。同时我们也看到,有的与会者尚不知来自何处,有的城市根本没有与会者。
一名与会者可有零到一个城市与之对应,而一个城市可有零到多个与会者。我们把城市和与会者的关系叫做:一对多的关系。
现在有四种方法把两个表连接起来显示信息。
注意,以下将用到 left join(左连接) 和 right join(右连接) 来连接两张表。
对应左右连接,谁是左边的表或右边的表?
谁是左边或右边的表?
出现在查询语句中的 from 后第一张表就是左表,后一张表就是右表(因为语句是从左向右写的!!!)。
因此,如果在 from 后把表的位置变动一下,结果就不一样了。
(1)显示所有城市及与会者
注意: 只有昆明、上海有与会者,北京没有。
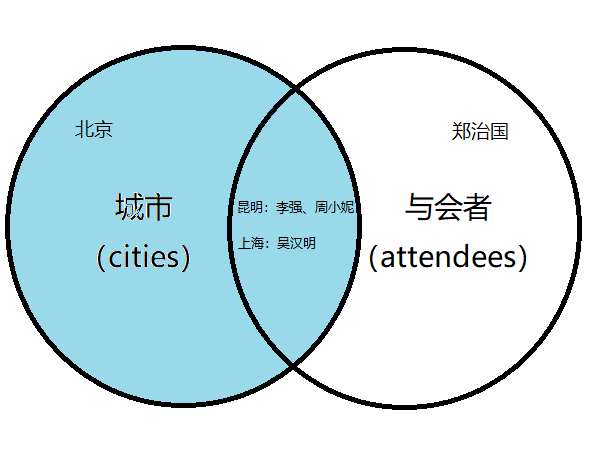
MariaDB [misc]> select cities.*, attendees.*-> from cities left join attendees-> on cities.id=attendees.from_city_id;+----+--------+------+-----------+--------------+| id | name | id | name | from_city_id |+----+--------+------+-----------+--------------+| 1 | 昆明 | 1 | 李强 | 1 || 1 | 昆明 | 2 | 周小妮 | 1 || 2 | 上海 | 3 | 吴汉明 | 2 || 3 | 北京 | NULL | NULL | NULL |+----+--------+------+-----------+--------------+4 rows in set (0.000 sec)MariaDB [misc]>
from 后有两张表,
citiesleft joinattendees。left join,左边连接,意思是列出所有左边的表(cities)的记录,和对应右边的表(attendees)的记录,没有对应的就填空值(NULL)。
注意结果:
1、城市全部罗列出来了,尽管有的城市(北京)尚没有与会者;
2、与会者并没有全部罗列出来,因为有的与会者尚不知来自何方(郑治国)。
(2)显示城市及所有与会者
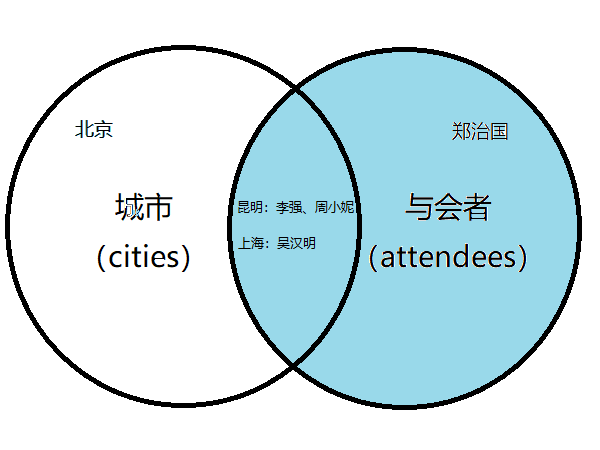
注意: 与会者“郑治国”尚不知来自哪个城市。
以下查询使用了表的别名简化输入。
MariaDB [misc]> select c.*, a.*-> from cities c right join attendees a-> on c.id=a.from_city_id;+------+--------+----+-----------+--------------+| id | name | id | name | from_city_id |+------+--------+----+-----------+--------------+| 1 | 昆明 | 1 | 李强 | 1 || 1 | 昆明 | 2 | 周小妮 | 1 || 2 | 上海 | 3 | 吴汉明 | 2 || NULL | NULL | 4 | 郑治国 | NULL |+------+--------+----+-----------+--------------+4 rows in set (0.000 sec)MariaDB [misc]>
from 后有两张表,cities rigth join attendees。rigth join,右边连接,意思是列出所有右边的表(cities)的记录,和对应左边的表(attendees)的记录,没有对应的就填空值(NULL)。
注意结果:
1、与会者全部罗列出来了,尽管有的与会者(郑治国)尚不知来自何处;
2、城市并没有全部罗列出来,因为有的城市尚没有与会者(北京)。
(3)只显示来自已知城市的与会者

MariaDB [misc]> select c.*, a.*-> from cities c inner join attendees a-> on c.id=a.from_city_id;+----+--------+----+-----------+--------------+| id | name | id | name | from_city_id |+----+--------+----+-----------+--------------+| 1 | 昆明 | 1 | 李强 | 1 || 1 | 昆明 | 2 | 周小妮 | 1 || 2 | 上海 | 3 | 吴汉明 | 2 |+----+--------+----+-----------+--------------+3 rows in set (0.000 sec)MariaDB [misc]>
from 后有两张表,cities inner join attendees。inner join, 内部连接,意思是列出左右边能够连接起来的记录。
注意结果:
1、未知来自何处的与会者(郑治国 )没有被列出来;
2、没有与会者的城市(北京)没有被列出来。
(4)全部城市和与会者都需要显示
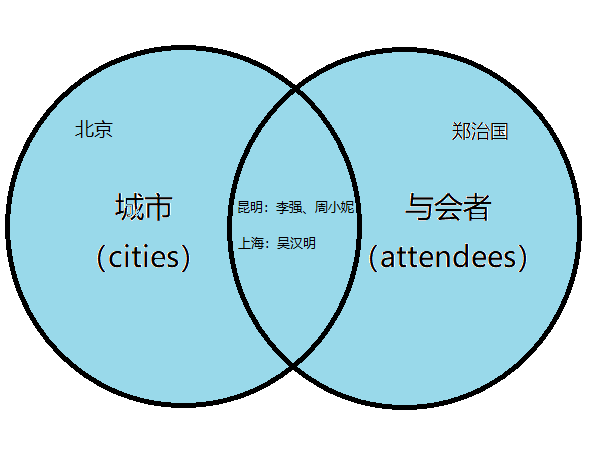
MariaDB [misc]> select c.*,a.*->from cities c left join attendees a on c.id=a.from_city_id->union->select c.*,a.*->from cities c right join attendees a on c.id=a.from_city_id;+------+--------+------+-----------+--------------+| id | name | id | name | from_city_id |+------+--------+------+-----------+--------------+| 1 | 昆明 | 1 | 李强 | 1 || 1 | 昆明 | 2 | 周小妮 | 1 || 2 | 上海 | 3 | 吴汉明 | 2 || 3 | 北京 | NULL | NULL | NULL || NULL | NULL | 4 | 郑治国 | NULL |+------+--------+------+-----------+--------------+5 rows in set (0.001 sec)
6.2 解读设计稿
6.2.1 E-R 图
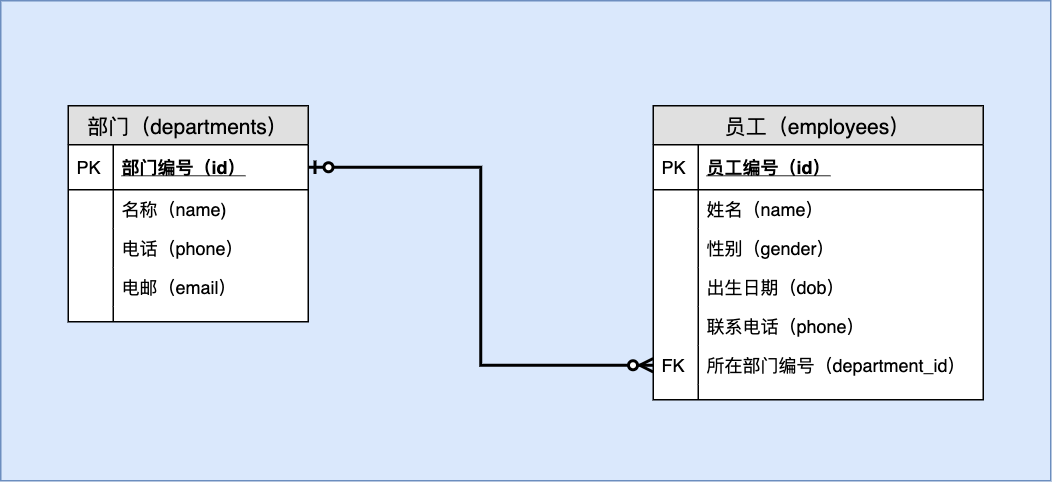
6.2.2 数据字典
(1)表定义
表名:部门( departments)
| 序号 | 列名 | 英文名 | 数据类型 | 必填? | 关键列 | 默认值 | 其它说明 |
|---|---|---|---|---|---|---|---|
| 1 | 部门编号 | id | BIGINT UNSIGNED | ✓ | PK | NULL | AUTO_INCREMENT |
| 2 | 名称 | name | VARCHAR(50) | ✓ | UNI | NULL | |
| 3 | 电话 | phone | VARCHAR(50) | ✓ | NULL | ||
| 4 | 电邮 | VARCHAR(100) | NULL |
表名:员工(employees)
| 序号 | 列名 | 英文名 | 数据类型 | 必填? | 关键列 | 默认值 | 其它说明 |
|---|---|---|---|---|---|---|---|
| 1 | 员工编号 | id | BIGINT UNSIGNED | ✓ | PK | NULL | AUTO_INCREMENT |
| 2 | 姓名 | name | VARCHAR(50) | ✓ | NULL | ||
| 3 | 性别 | gender | CHAR(1) | ✓ | NULL | 限于“男”和“女” | |
| 4 | 出生日期 | birth_date | DATE | NULL | |||
| 5 | 联系电话 | phone | VARCHAR(50) | ✓ | NULL | ||
| 6 | 部门编号 | department_id | BIGINT UNSIGNED | FK | NULL | 参照 departments.id 主表更新时:级联 主表删除时:设置空值 |
(2)触发器
表名:
| 序号 | 名称 | 时机 | 功能 | 其它 |
|---|---|---|---|---|
(3)视图
视图名称:
| 序号 | 列名 | 英文名 | 来自 | 其它说明 |
|---|---|---|---|---|
(4)存储过程与函数
| 序号 | 名称 | 功能 | 输入 | 返回值 | 其它 |
|---|---|---|---|---|---|
(5)用户及权限
| 用户名 | 登录位置 | 初始密码 | 权限说明 |
|---|---|---|---|
| c2_dept_db_admin | 所有 | 000000 | 对数据库具有所有权限 |
| c2_dept_db_user | 所有 | 000000 | 对数据库表具有增、删、改、查权限 |
6.2.3 从需求文档整理的数据查询需求
- 能够按以下指定条件查询筛选记录;
- 列出所有部门及其员工,全部部门都要列出
- 列出所有员工及其所在部门,全部员工都要列出
- 列出所有部门的所有员工,忽略无员工部门及无部门员工
- 合并列出所有部门和所有员工,包括无员工部门及无部门员工
- 列出没尚不属于任何部门的员工
- 列出尚无员工的部门
- 找出“公关部”的所有年龄在 25 到 35 岁的员工,结果中显示年龄并按年龄升序排序
- 列出员工人数在 3 人以上的部门及其员工
- 能够按以下指定条件统计信息
- 按性别分组统计员工人数
- 按出生年月分组统计员工人数
- 按部门统计员工人数(需要显示部门名称)
6.3 数据查询、统计与维护
6.3.1 查询
(1)列出所有部门及其员工,全部部门都要列出
全部部门都要列出,如果部门在 from 子句中位于左边,则是左连接:
select d.*, e.*from departments d left join employees eon d.id=e.department_id;
如果部门在 from 子句中位于右边,则是右连接:
select d.*, e.*from employees e right join departments don d.id=e.department_id;
- 能够按以下指定条件查询筛选记录;
- 列出所有部门及其员工,全部部门都要列出
- 列出所有员工及其所在部门,全部员工都要列出
- 列出所有部门的所有员工,忽略无员工部门及无部门员工
- 合并列出所有部门和所有员工,包括无员工部门及无部门员工
- 列出没尚不属于任何部门的员工
- 列出尚无员工的部门
- 找出“公关部”的所有年龄在 25 到 35 岁的员工,结果中显示年龄并按年龄升序排序
- 列出员工人数在 3 人以上的部门及其员工
- 能够按以下指定条件统计信息
- 按性别分组统计员工人数
- 按出生年月分组统计员工人数
- 按部门统计员工人数(需要显示部门名称)
(2)列出所有员工及其所在部门,全部员工都要列出
全部员工都要列出,如果员工在 from 子句中位于左边,则是左连接:
select d.*, e.*from employees e left join departments don d.id=e.department_id;
如果员工在 from 子句中位于右边,则是右连接:
select d.*, e.*from departments d right join employees eon d.id=e.department_id;
- 能够按以下指定条件查询筛选记录;
- 列出所有部门及其员工,全部部门都要列出
- 列出所有员工及其所在部门,全部员工都要列出
- 列出所有部门的所有员工,忽略无员工部门及无部门员工
- 合并列出所有部门和所有员工,包括无员工部门及无部门员工
- 列出没尚不属于任何部门的员工
- 列出尚无员工的部门
- 找出“公关部”的所有年龄在 25 到 35 岁的员工,结果中显示年龄并按年龄升序排序
- 列出员工人数在 3 人以上的部门及其员工
- 能够按以下指定条件统计信息
- 按性别分组统计员工人数
- 按出生年月分组统计员工人数
- 按部门统计员工人数(需要显示部门名称)
(3)列出所有部门的所有员工,忽略无员工部门及无部门员工
因为只列出有员工的部门和有部门的员工,采用内连接,表的出现顺序无关。
select d.*, e.*from departments d inner join employees eon d.id=e.department_id;
- 能够按以下指定条件查询筛选记录;
- 列出所有部门及其员工,全部部门都要列出
- 列出所有员工及其所在部门,全部员工都要列出
- 列出所有部门的所有员工,忽略无员工部门及无部门员工
- 合并列出所有部门和所有员工,包括无员工部门及无部门员工
- 列出没尚不属于任何部门的员工
- 列出尚无员工的部门
- 找出“公关部”的所有年龄在 25 到 35 岁的员工,结果中显示年龄并按年龄升序排序
- 列出员工人数在 3 人以上的部门及其员工
- 能够按以下指定条件统计信息
- 按性别分组统计员工人数
- 按出生年月分组统计员工人数
- 按部门统计员工人数(需要显示部门名称)
(4)合并列出所有部门和所有员工,包括无员工部门及无部门员工
合并列出,双方内容都需要完全列出,要用完整外连接。在有的数据库系统里,有完整外连接的语句,如:
select d.*, e.*from departments d full outer join employees eon d.id=e.department_id;
在 MariaDB/MySQL 中我们可以用以下语句来实现:
select d.*, e.*from departments d left join employees eon d.id=e.department_idunionselect d.*, e.*from departments d right join employees eon d.id=e.department_id;
- 能够按以下指定条件查询筛选记录;
- 列出所有部门及其员工,全部部门都要列出
- 列出所有员工及其所在部门,全部员工都要列出
- 列出所有部门的所有员工,忽略无员工部门及无部门员工
- 合并列出所有部门和所有员工,包括无员工部门及无部门员工
- 列出没尚不属于任何部门的员工
- 列出尚无员工的部门
- 找出“公关部”的所有年龄在 25 到 35 岁的员工,结果中显示年龄并按年龄升序排序
- 列出员工人数在 3 人以上的部门及其员工
- 能够按以下指定条件统计信息
- 按性别分组统计员工人数
- 按出生年月分组统计员工人数
- 按部门统计员工人数(需要显示部门名称)
(5)列出没尚不属于任何部门的员工
select * from employees where department_id is null;
- 能够按以下指定条件查询筛选记录;
- 列出所有部门及其员工,全部部门都要列出
- 列出所有员工及其所在部门,全部员工都要列出
- 列出所有部门的所有员工,忽略无员工部门及无部门员工
- 合并列出所有部门和所有员工,包括无员工部门及无部门员工
- 列出没尚不属于任何部门的员工
- 列出尚无员工的部门
- 找出“公关部”的所有年龄在 25 到 35 岁的员工,结果中显示年龄并按年龄升序排序
- 列出员工人数在 3 人以上的部门及其员工
- 能够按以下指定条件统计信息
- 按性别分组统计员工人数
- 按出生年月分组统计员工人数
- 按部门统计员工人数(需要显示部门名称)
(6)列出尚无员工的部门
select * from departmentswhere (select count(*) from employees where department_id=departments.id)=0;
- 能够按以下指定条件查询筛选记录;
- 列出所有部门及其员工,全部部门都要列出
- 列出所有员工及其所在部门,全部员工都要列出
- 列出所有部门的所有员工,忽略无员工部门及无部门员工
- 合并列出所有部门和所有员工,包括无员工部门及无部门员工
- 列出没尚不属于任何部门的员工
- 列出尚无员工的部门
- 找出“公关部”的所有年龄在 25 到 35 岁的员工,结果中显示年龄并按年龄升序排序
- 列出员工人数在 3 人以上的部门及其员工
- 能够按以下指定条件统计信息
- 按性别分组统计员工人数
- 按出生年月分组统计员工人数
- 按部门统计员工人数(需要显示部门名称)
(7)找出“公关部”的所有年龄在 25 到 35 岁的员工,结果中显示年龄并按年龄升序排序
因为查询涉及两张表的内容,查询中需要将两张表连接得到一个结果集,再从结果集中筛选记录。两步是并到同一语句中的。
select e.id, e.name, e.birth_date,timestampdiff(YEAR, e.birth_date, curdate()) as age, d.namefrom departments d inner join employees eon e.department_id=d.id -- 到此为止为连接两表得到一个结果集where d.name='公关部' and -- 过滤结果集timestampdiff(YEAR, e.birth_date, curdate()) between 25 and 35order by age asc -- 排序;
- 能够按以下指定条件查询筛选记录;
- 列出所有部门及其员工,全部部门都要列出
- 列出所有员工及其所在部门,全部员工都要列出
- 列出所有部门的所有员工,忽略无员工部门及无部门员工
- 合并列出所有部门和所有员工,包括无员工部门及无部门员工
- 列出没尚不属于任何部门的员工
- 列出尚无员工的部门
- 找出“公关部”的所有年龄在 25 到 35 岁的员工,结果中显示年龄并按年龄升序排序
- 列出员工人数在 3 人以上的部门及其员工
- 能够按以下指定条件统计信息
- 按性别分组统计员工人数
- 按出生年月分组统计员工人数
- 按部门统计员工人数(需要显示部门名称)
(8)列出员工人数在 3 人以上的部门及其员工
因为查询涉及两张表的内容,查询方法同上。
select e.*, d.namefrom departments d inner join employees eon e.department_id=d.id -- 到此为止为连接两表得到一个结果集where (select count(*) from employees e1 where e1.department_id=d.id) > 3;
- 能够按以下指定条件查询筛选记录;
- 列出所有部门及其员工,全部部门都要列出
- 列出所有员工及其所在部门,全部员工都要列出
- 列出所有部门的所有员工,忽略无员工部门及无部门员工
- 合并列出所有部门和所有员工,包括无员工部门及无部门员工
- 列出没尚不属于任何部门的员工
- 列出尚无员工的部门
- 找出“公关部”的所有年龄在 25 到 35 岁的员工,结果中显示年龄并按年龄升序排序
- 列出员工人数在 3 人以上的部门及其员工
- 能够按以下指定条件统计信息
- 按性别分组统计员工人数
- 按出生年月分组统计员工人数
- 按部门统计员工人数(需要显示部门名称)
6.3.2 统计
(1)按性别分组统计员工人数
select gender, count(*)from employeesgroup by gender;
- 能够按以下指定条件查询筛选记录;
- 列出所有部门及其员工,全部部门都要列出
- 列出所有员工及其所在部门,全部员工都要列出
- 列出所有部门的所有员工,忽略无员工部门及无部门员工
- 合并列出所有部门和所有员工,包括无员工部门及无部门员工
- 列出没尚不属于任何部门的员工
- 列出尚无员工的部门
- 找出“公关部”的所有年龄在 25 到 35 岁的员工,结果中显示年龄并按年龄升序排序
- 列出员工人数在 3 人以上的部门及其员工
- 能够按以下指定条件统计信息
- 按性别分组统计员工人数
- 按出生年月分组统计员工人数
- 按部门统计员工人数(需要显示部门名称)
(2)按出生年月分组统计员工人数
select concat(year(birth_date),'-',month(birth_date)) as 出生年月, count(*) as 人数from employeesgroup by 出生年月;
- 能够按以下指定条件查询筛选记录;
- 列出所有部门及其员工,全部部门都要列出
- 列出所有员工及其所在部门,全部员工都要列出
- 列出所有部门的所有员工,忽略无员工部门及无部门员工
- 合并列出所有部门和所有员工,包括无员工部门及无部门员工
- 列出没尚不属于任何部门的员工
- 列出尚无员工的部门
- 找出“公关部”的所有年龄在 25 到 35 岁的员工,结果中显示年龄并按年龄升序排序
- 列出员工人数在 3 人以上的部门及其员工
- 能够按以下指定条件统计信息
- 按性别分组统计员工人数
- 按出生年月分组统计员工人数
- 按部门统计员工人数(需要显示部门名称)
(3) 按部门统计员工人数(需要显示部门名称)
因为统计涉及两张表的内容,需要将两张表连接得到一个结果集,再从结果集中进行统计。两步是并到同一语句中的。
select d.name, count(*)from departments d left join employees eon e.department_id=d.id -- 连接两表得到一个结果集group by d.id -- 分组统计;
- 能够按以下指定条件查询筛选记录;
- 列出所有部门及其员工,全部部门都要列出
- 列出所有员工及其所在部门,全部员工都要列出
- 列出所有部门的所有员工,忽略无员工部门及无部门员工
- 合并列出所有部门和所有员工,包括无员工部门及无部门员工
- 列出没尚不属于任何部门的员工
- 列出尚无员工的部门
- 找出“公关部”的所有年龄在 25 到 35 岁的员工,结果中显示年龄并按年龄升序排序
- 列出员工人数在 3 人以上的部门及其员工
- 能够按以下指定条件统计信息
- 按性别分组统计员工人数
- 按出生年月分组统计员工人数
- 按部门统计员工人数(需要显示部门名称)
6.3.3 数据维护
添加一名员工到“市场部”。
insert into employees(name,gender,birth_date,phone,department_id)values ('王小小','女','1998-12-20','13087676754',(select id from department where name='市场部'));
练习:
(1)列出员工人数在 5 人以下的部门。
(2)更新一条部门的 id 号,观察所属员工的部门 id 是否一起发生了变化。
(3)用一条语句新增两个部门,"信息技术部"和"采购部"。
(4)各添加一名员工到“信息技术部”和“采购部”。
(5)把第 10 号员工的姓名改成'顾晓',出生年月改成'1988-10-10'。
第七章 案例三 一对多关系特例:一对一 会员管理
数据库: c3_member_db (备份下载)
一对一关系是一对多关系的一个特例,它是通过限定外键为唯一值来达到的。一对一关系的两个实体通常用于描述同一事物的不同侧面,便于分离业务关注点及针对用户分配不同的处理和访问权限。
7.1 解读设计稿
7.1.1 E-R 图
连接示意图
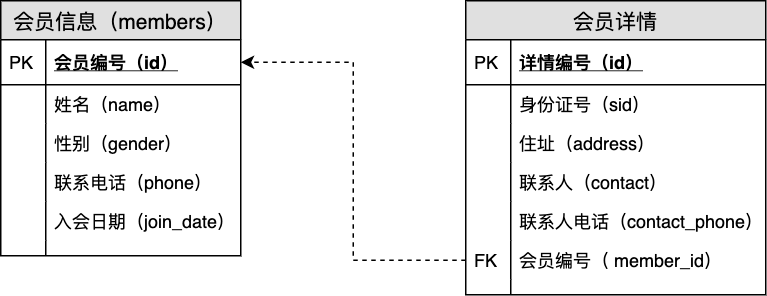
标准 E-R 图
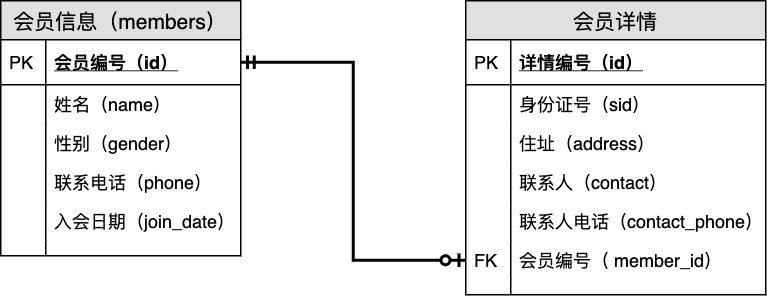
7.1.2 数据字典
(1)表定义
表名:会员信息( members)
| 序号 | 列名 | 英文名 | 数据类型 | 必填? | 关键列 | 默认值 | 其它说明 |
|---|---|---|---|---|---|---|---|
| 1 | 会员编号 | id | BIGINT UNSIGNED | ✓ | PK | NULL | AUTO_INCREMENT |
| 2 | 姓名 | name | VARCHAR(50) | ✓ | IDX | NULL | |
| 3 | 性别 | gender | CHAR(1) | ✓ | '女' | 限于“男”、“女” | |
| 4 | 联系电话 | phone | VARCHAR(50) | ✓ | |||
| 5 | 入会日期 | join_date | DATE | ✓ |
表名:会员详情( member_details)
| 序号 | 列名 | 英文名 | 数据类型 | 必填? | 关键列 | 默认值 | 其它说明 |
|---|---|---|---|---|---|---|---|
| 1 | 详情编号 | id | BIGINT UNSIGNED | ✓ | PK | NULL | AUTO_INCREMENT |
| 2 | 身份证号 | sid | CHAR(18) | ✓ | NULL | ||
| 3 | 住址 | address | VARCHAR(100) | NULL | |||
| 4 | 联系人 | contact | VARCHAR(50) | NULL | |||
| 5 | 联系人电话 | contact_phone | VARCHAR(50) | NULL | |||
| 6 | 会员编号 | member_id | BIGINT UNSIGNED | ✓ | FK UNI |
NULL | 参照 members.id 主表更新时:级联 主表删除时:级联 |
(2)触发器
表名:雇员信息(member_details)
| 序号 | 名称 | 时机 | 功能 | 其它 |
|---|---|---|---|---|
| 1 | ins_upd_gender | 插入后 | 根据身份证号取出性别信息填入members 表的相应列 | |
| 2 | upd_upd_gender | 更新后 | 根据身份证号取出性别信息填入members 表的相应列 |
(3)视图
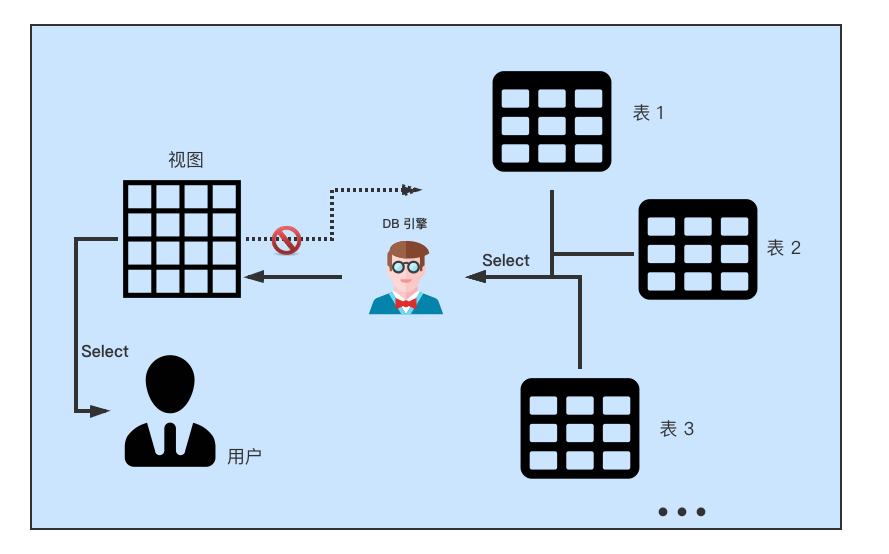
视图名称:member_infos
| 序号 | 列名 | 英文名 | 来自 | 其它说明 |
|---|---|---|---|---|
| 1 | 会员编号 | id | 表:members | |
| 2 | 身份证号 | sid | 表:member_details | |
| 2 | 姓名 | name | 表:member | |
| 3 | 性别 | gender | 表:members | |
| 4 | 年龄 | age | 函数:get_member_age | 根据 member_deatils.sid 计算 |
| 5 | 住址 | adderss | 表:member_details | |
| 6 | 电话 | phone | 表:members | |
| 7 | 入会日期 | join_date | 表:members | |
| 8 | 联系人 | contact | 表:member_details | |
| 9 | 联系人电话 | contact_phone | 表:member_details |
(4)存储过程与函数
| 序号 | 名称 | 功能 | 输入 | 返回值 | 其它 |
|---|---|---|---|---|---|
| 1 | get_member_age | 获取会员年龄 | 身份证号:CHAR(18) | 年龄:TINYINT UNDSIGNED | 函数 |
(5)用户及权限
| 用户名 | 登录位置 | 初始密码 | 权限说明 |
|---|---|---|---|
| c3_member_db_admin | 所有 | 000000 | 对数据库具有所有权限 |
| c3_member_db_user | 所有 | 000000 | 对数据库表具有增、删、改、查权限 |
7.1.3 整理的数据查询需求
- 能够按以下指定条件查询筛选记录;
- 根据性别列出所有会员,并列出其详情
- 按姓名查找会员,并列出其详情
- 查找某年龄段的会员(含详情)并按年龄进行升序、降序排序
- 找出入会一年以上的会员(含详情)
- 找出尚没有“会员详情”的会员
- 能够按以下指定条件统计信息
- 按性别分组统计会员人数
- 按年龄(10+,20+,30+,40+ ...)分组统计会员人数
- 按入会年份统计会员人数
7.2 查询记录
7.2.1 根据性别列出所有会员,并列出其详情
select m.*, d.*from members m left join member_details don m.id=d.member_idwhere m.gender='男';
- 能够按以下指定条件查询筛选记录;
- 根据性别列出所有会员,并列出其详情
- 按姓名查找会员,并列出其详情
- 查找某年龄段的会员(含详情)并按年龄进行升序、降序排序
- 找出入会一年以上的会员(含详情)
- 找出尚没有“会员详情”的会员
- 能够按以下指定条件统计信息
- 按性别分组统计会员人数
- 按年龄(10+,20+,30+,40+ ...)分组统计会员人数
- 按入会年份统计会员人数
7.2.2 按姓名查找会员,并列出其详情
select m.*, d.*from members m left join member_details don m.id=d.member_idwhere m.name like '%志%';
- 能够按以下指定条件查询筛选记录;
- 根据性别列出所有会员,并列出其详情
- 按姓名查找会员,并列出其详情
- 查找某年龄段的会员(含详情)并按年龄进行升序、降序排序
- 找出入会一年以上的会员(含详情)
- 找出尚没有“会员详情”的会员
- 能够按以下指定条件统计信息
- 按性别分组统计会员人数
- 按年龄(10+,20+,30+,40+ ...)分组统计会员人数
- 按入会年份统计会员人数
7.2.3 查找某年龄段的会员(含详情)并按年龄进行升序、降序排序
查找 30到 40 岁之间的会员并按年龄升序排序。
使用函数 get_member_age()
select m.*, d.*, get_member_age(d.sid) as agefrom members m left join member_details don m.id=d.member_idwhere get_member_age(d.sid) between 30 and 40;
使用视图 member_infos
select * from member_infos where age between 30 and 40;
- 能够按以下指定条件查询筛选记录;
- 根据性别列出所有会员,并列出其详情
- 按姓名查找会员,并列出其详情
- 查找某年龄段的会员(含详情)并按年龄进行升序、降序排序
- 找出入会一年以上的会员(含详情)
- 找出尚没有“会员详情”的会员
- 能够按以下指定条件统计信息
- 按性别分组统计会员人数
- 按年龄(10+,20+,30+,40+ ...)分组统计会员人数
- 按入会年份统计会员人数
7.2.4 找出入会一年以上的会员(含详情)
利用视力 member_infos
select * from member_infoswhere join_date < date_sub(now(), interval 1 year);
- 能够按以下指定条件查询筛选记录;
- 根据性别列出所有会员,并列出其详情
- 按姓名查找会员,并列出其详情
- 查找某年龄段的会员(含详情)并按年龄进行升序、降序排序
- 找出入会一年以上的会员(含详情)
- 找出尚没有“会员详情”的会员
- 能够按以下指定条件统计信息
- 按性别分组统计会员人数
- 按年龄段(10+,20+,30+,40+ ...)分组统计会员人数
- 按入会年份统计会员人数
7.2.5 找出尚没有“会员详情”的会员
子查询
出现在查询语句里作为查询语句的一部分的一条完整的查询语句。
select * from memberswhere (select count(*) from member_details where member_id=members.id)=0;
- 能够按以下指定条件查询筛选记录;
- 根据性别列出所有会员,并列出其详情
- 按姓名查找会员,并列出其详情
- 查找某年龄段的会员(含详情)并按年龄进行升序、降序排序
- 找出入会一年以上的会员(含详情)
- 找出尚没有“会员详情”的会员
- 能够按以下指定条件统计信息
- 按性别分组统计会员人数
- 按年龄段(10+,20+,30+,40+ ...)分组统计会员人数
- 按入会年份统计会员人数
练习
1、找出入会一个月内的会员(含详情)
2、找出年龄在 30 岁以上的女性会员(含详情)
7.3 统计与计算
7.3.1 按性别分组统计会员人数
select gender, count(*) from membersgroup by gender;
- 能够按以下指定条件查询筛选记录;
- 根据性别列出所有会员,并列出其详情
- 按姓名查找会员,并列出其详情
- 查找某年龄段的会员(含详情)并按年龄进行升序、降序排序
- 找出入会一年以上的会员(含详情)
- 找出尚没有“会员详情”的会员
- 能够按以下指定条件统计信息
- 按性别分组统计会员人数
- 按年龄(10+,20+,30+,40+ ...)分组统计会员人数
- 按入会年份统计会员人数
7.3.2 按年龄段(10+,20+,30+,40+ ...)分组统计会员人数
利用视图 member_infos:
select floor(age/10)*10 as age_range, count(*) from member_infosgroup by age_range;
- 能够按以下指定条件查询筛选记录;
- 根据性别列出所有会员,并列出其详情
- 按姓名查找会员,并列出其详情
- 查找某年龄段的会员(含详情)并按年龄进行升序、降序排序
- 找出入会一年以上的会员(含详情)
- 找出尚没有“会员详情”的会员
- 能够按以下指定条件统计信息
- 按性别分组统计会员人数
- 按年龄(10+,20+,30+,40+ ...)分组统计会员人数
- 按入会年份统计会员人数
7.3.3 按入会年份统计会员人数
select year(join_date) as year, count(*)from membersgroup by year;
- 能够按以下指定条件查询筛选记录;
- 根据性别列出所有会员,并列出其详情
- 按姓名查找会员,并列出其详情
- 查找某年龄段的会员(含详情)并按年龄进行升序、降序排序
- 找出入会一年以上的会员(含详情)
- 找出尚没有“会员详情”的会员
- 能够按以下指定条件统计信息
- 按性别分组统计会员人数
- 按年龄(10+,20+,30+,40+ ...)分组统计会员人数
- 按入会年份统计会员人数
练习
1、列出所有会员编号、身份证号、姓名、性别、年龄(用函数及相关表、用视图各实现一次)。
7.4 增、改、删
7.4.1 增加:确认一对一关系
给已经有会员详情的会员记录再添加一条会员详情。
MariaDB [db_2_2]> select * from member_details where member_id=10\G*************************** 1. row ***************************id: 7sid: 44132319940218504Xaddress: 贵阳秀英区contact: 何辉contact_phone: 13165155723member_id: 101 row in set (0.000 sec)MariaDB [db_2_2]> insert into member_details(sid,address,member_id)-> values('520101198012212451','昆明五华区',10);ERROR 1062 (23000): Duplicate entry '10' for key 'member_details_member_id_unique'MariaDB [db_2_2]>
ERROR: 错误
Duplicate entry: 重复的条目
unique: 独一的,唯一的
7.4.2 增加:确认增加一条会员详情给一位不存在的会员失败
MariaDB [db_2_2]> insert into member_details(sid,address,member_id)-> values('520101198012212451','昆明五华区',1000);ERROR 1452 (23000): Cannot add or update a child row: a foreign key constraint fails (`db_2_2`.`member_details`, CONSTRAINT `member_details_member_id_foreign` FOREIGN KEY (`member_id`) REFERENCES `members` (`id`) ON DELETE CASCADE ON UPDATE CASCADE)MariaDB [db_2_2]>
7.4.3 修改身份证号:确认更新时触发器产生了作用
select * from members m inner join member_details don m.id = d.member_id;
选其中一条记录进行修改。
update member_details set sid='(身份证号)' where id=编号;
7.4.4 删除会员信息:确认会员详情会被级联删除
select * from members m inner join member_details don m.id = d.member_id;
选其中一条记录进行删除。
delete from members where id=编号;
练习
1、自行增加一条会员记录,并为其添加对应的详情记录。
2、修改一条会员基本信息记录的 ID 号,观察其详情记录的外键变化。
第八章 案例四 一对多自关联:行政区划管理
数据库: c4_division_db 数据库备份
8.1 解读设计稿
8.1.1 E-R 图
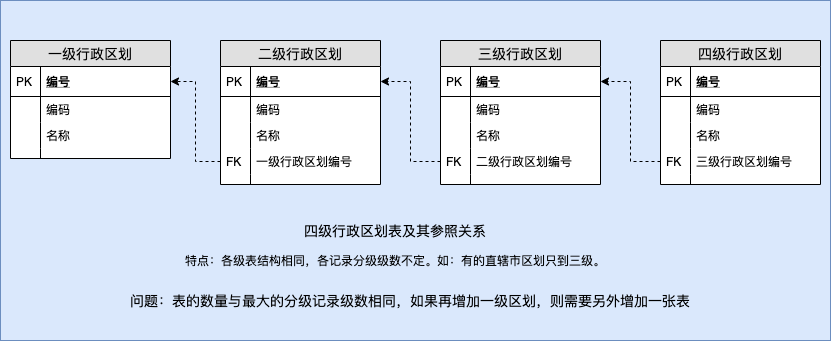
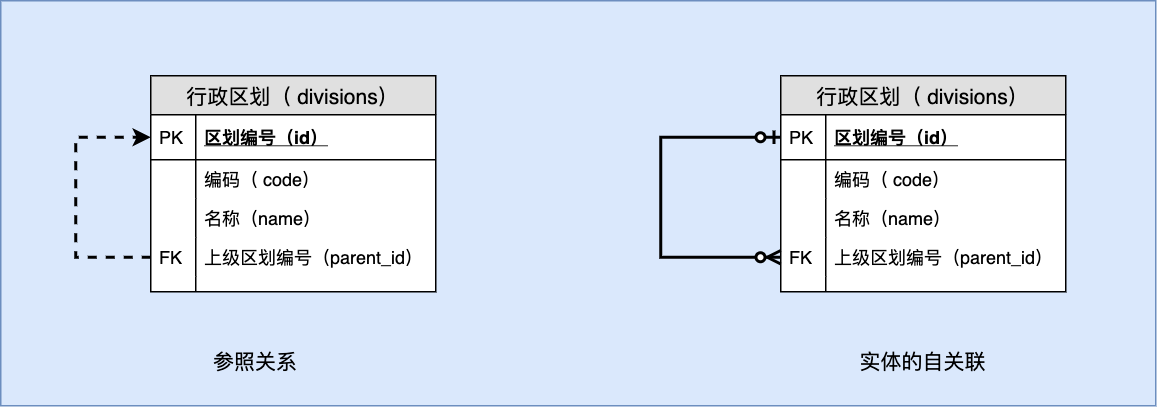
8.1.2 数据字典
(1)表定义
表名:区划行政( divisions)
| 序号 | 列名 | 英文名 | 数据类型 | 必填? | 关键列 | 默认值 | 其它说明 |
|---|---|---|---|---|---|---|---|
| 1 | 区划编号 | id | BIGINT UNSIGNED | ✓ | PK | NULL | AUTO_INCREMENT |
| 3 | 编码 | code | CHAR(12) | ✓ | NULL | ||
| 2 | 名称 | name | VARCHAR(100) | ✓ | NULL | ||
| 4 | 上级区划编号 | parent_id | BIGINT UNSIGNED | NULL |
(2)触发器
表名:区划行政( divisions)
| 序号 | 名称 | 时机 | 功能 | 其它 |
|---|---|---|---|---|
(3)视图
视图名称:
| 序号 | 列名 | 英文名 | 来自 | 其它说明 |
|---|---|---|---|---|
(4)存储过程与函数
| 序号 | 名称 | 功能 | 输入 | 返回值 | 其它 |
|---|---|---|---|---|---|
| 1 | get_addr_by_id | 获取地名级联名称 | 区划 ID | VARCHAR(200), 级联名称,如: 云南省>昆明市>盘龙区 |
函数 |
| 2 | get_addr_by_name | 获取一组地名级联名称 | 区划关键字 | 结果集:一组地名级联名称 | 过程 |
(5)用户及权限
| 用户名 | 登录位置 | 初始密码 | 权限说明 |
|---|---|---|---|
| c4_division_db_admin | 所有 | 000000 | 对数据库具有所有权限 |
| c4_division_db_user | 所有 | 000000 | 对数据库表具有增、删、改、查权限 |
8.1.3 从需求文档整理的数据查询需求
能够按以下指定条件查询筛选记录;
- 获取所有顶级行政区划
- 获取所有最末节行政区划
- 根据区划 ID 获取完整的地名级联名称
- 根据区划关键字获取所有相关的地名级联名称
能够按以下指定条件统计信息
- 统计共有几个顶级行政
- 统计共有几个末级行政区划
8.2 数据查询、统计与维护
8.2.1 数据查询
(1)获取所有顶级行政区划
select * from divisions where parent_id is null;
- 能够按以下指定条件查询筛选记录;
- 获取所有顶级行政区划
- 获取所有最末节行政区划
- 根据区划 ID 获取完整的地名级联名称
- 根据区划关键字获取所有相关的地名级联名称
- 能够按以下指定条件统计信息
- 统计共有几个顶级行政
- 统计共有几个末级行政区划
(2)获取所有最末节行政区划
select * from divisions d1where (select count(*) from divisions d2 where d2.parent_id=d1.id)=0;
- 能够按以下指定条件查询筛选记录;
- 获取所有顶级行政区划
- 获取所有最末节行政区划
- 根据区划 ID 获取完整的地名级联名称
- 根据区划关键字获取所有相关的地名级联名称
- 能够按以下指定条件统计信息
- 统计共有几个顶级行政
- 统计共有几个末级行政区划
(3)根据分类 ID 获取完整的地名级联名称
使用函数:get_addr_by_id()
MariaDB [db_2_4]> select get_addr_by_id(30001);+-----------------------------------------+| get_addr_by_id(30001) |+-----------------------------------------+| 广东省>韶关市>曲江区>乌石镇 |+-----------------------------------------+1 row in set (0.000 sec)MariaDB [db_2_4]>
- 能够按以下指定条件查询筛选记录;
- 获取所有顶级行政区划
- 获取所有最末节行政区划
- 根据区划 ID 获取完整的地名级联名称
- 根据区划关键字获取所有相关的地名级联名称
- 能够按以下指定条件统计信息
- 统计共有几个顶级行政
- 统计共有几个末级行政区划
(4)根据类别关键字获取所有相关的地名级联名称
使用存储过程:get_addr_by_name()
MariaDB [db_2_4]> call get_addr_by_name('盘龙');+-------+-----------------------------------------------------------------+| id | address |+-------+-----------------------------------------------------------------+| 42509 | 河南省>驻马店市>确山县>盘龙街道办事处 || 42509 | 湖北省>武汉市>黄陂区>盘龙城经济开发区 || 42509 | 四川省>广元市>利州区>盘龙镇 || 42509 | 四川省>南充市>南部县>盘龙镇 || 42509 | 云南省>昆明市>盘龙区 || 42509 | 云南省>昆明市>盘龙区>盘龙区阿子营街道办事处 || 42509 | 云南省>昆明市>盘龙区>盘龙区滇源街道办事处 || 42509 | 云南省>文山壮族苗族自治州>砚山县>盘龙彝族乡 || 42509 | 重庆市>荣昌区>盘龙镇 || 42509 | 重庆市>云阳县>盘龙街道办事处 |+-------+-----------------------------------------------------------------+10 rows in set (0.011 sec)Query OK, 47 rows affected (0.011 sec)MariaDB [db_2_4]>
- 能够按以下指定条件查询筛选记录;
- 获取所有顶级行政区划
- 获取所有最末节行政区划
- 根据区划 ID 获取完整的地名级联名称
- 根据区划关键字获取所有相关的地名级联名称
- 能够按以下指定条件统计信息
- 统计共有几个顶级行政
- 统计共有几个末级行政区划
8.2.2 统计
(1)统计共有几个顶级行政
select count(*) from divisions where parent_id is null;
- 能够按以下指定条件查询筛选记录;
- 获取所有顶级行政区划
- 获取所有最末节行政区划
- 根据区划 ID 获取完整的地名级联名称
- 根据区划关键字获取所有相关的地名级联名称
- 能够按以下指定条件统计信息
- 统计共有几个顶级行政
- 统计共有几个末级行政区划
(2)统计共有几个末级行政区划
select count(*) from divisions d1where (select count(*) from divisions d2 where d2.parent_id=d1.id)=0;
- 能够按以下指定条件查询筛选记录;
- 获取所有顶级行政区划
- 获取所有最末节行政区划
- 根据区划 ID 获取完整的地名级联名称
- 根据区划关键字获取所有相关的地名级联名称
- 能够按以下指定条件统计信息
- 统计共有几个顶级行政
- 统计共有几个末级行政区划
第九章 案例五 多对多关系:通讯录管理
数据库: c5_contact_db 下载数据库备份
9.1 解读设计稿
9.1.1 E-R 图
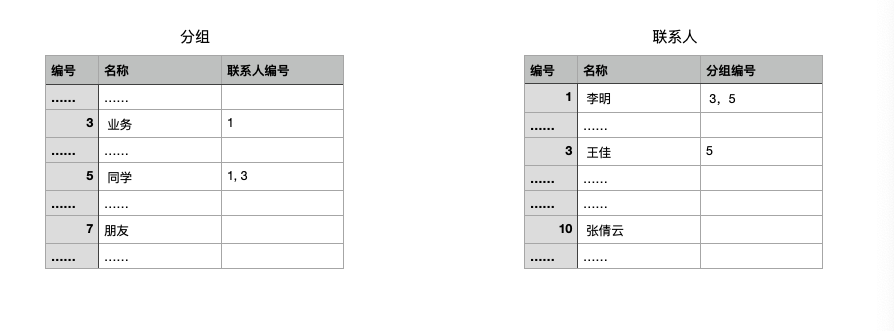
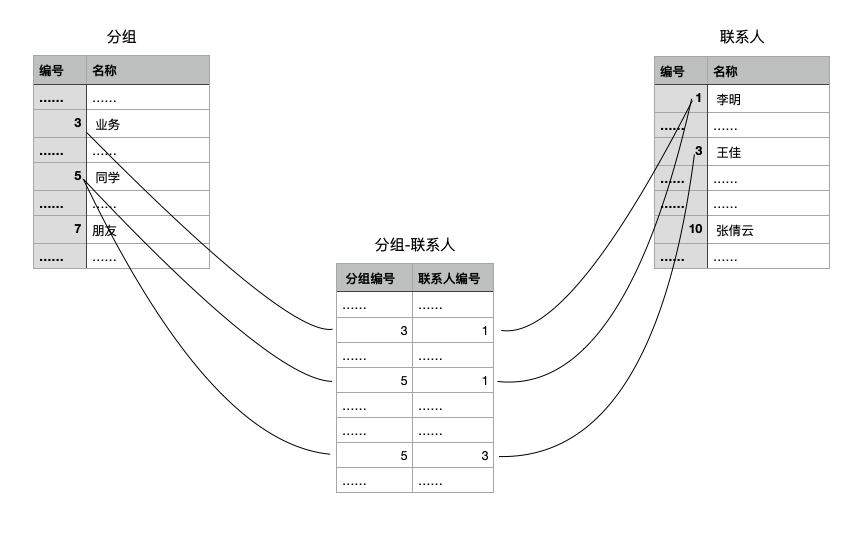
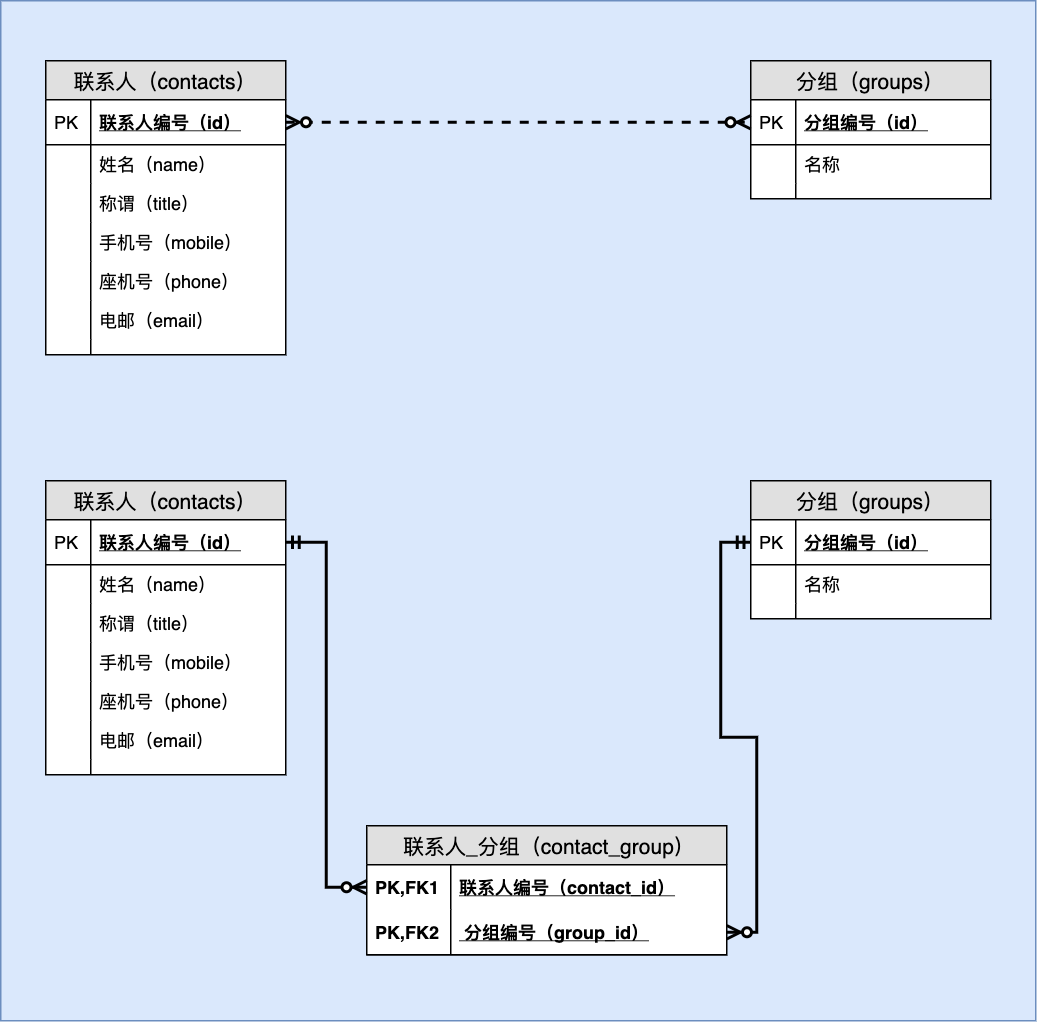
9.1.2 数据字典
(1)表定义
表名:联系人(contacts)
| 序号 | 列名 | 英文名 | 数据类型 | 必填? | 关键列 | 默认值 | 其它说明 |
|---|---|---|---|---|---|---|---|
| 1 | 联系人编号 | id | BIGINT UNSIGNED | ✓ | PK | NULL | AUTO_INCREMENT |
| 2 | 姓名 | name | VARCHAR(50) | ✓ | UNI | NULL | |
| 3 | 称谓 | title | VARCHAR(50) | NULL | |||
| 4 | 手机 | mobile | VARCHAR(50) | ✓ | NULL | ||
| 5 | 座机 | phone | VARCHAR(50) | NULL | |||
| 6 | 电邮 | VARCHAR(100) | NULL |
表名:分组(groups)
| 序号 | 列名 | 英文名 | 数据类型 | 必填? | 关键列 | 默认值 | 其它说明 |
|---|---|---|---|---|---|---|---|
| 1 | 分组编号 | id | BIGINT UNSIGNED | ✓ | PK | NULL | AUTO_INCREMENT |
| 2 | 名称 | name | VARCHAR(50) | ✓ | UNI | NULL |
表名:联系人-分组(contact_group)
| 序号 | 列名 | 英文名 | 数据类型 | 必填? | 关键列 | 默认值 | 其它说明 |
|---|---|---|---|---|---|---|---|
| 1 | 分组编号 | group_id | BIGINT UNSIGNED | ✓ | PK,FK | NULL | 参照groups.id 更新:级联 删除:级联 |
| 2 | 联系人编号 | contact_id | BIGINT UNSIGNED | ✓ | PK,FK | NULL | 参照contacts.id 更新:级联 删除:级联 |
(2)触发器
表名:
| 序号 | 名称 | 时机 | 功能 | 其它 |
|---|---|---|---|---|
(3)视图
视图名称:
| 序号 | 列名 | 英文名 | 来自 | 其它说明 |
|---|---|---|---|---|
(4)存储过程与函数
| 序号 | 名称 | 功能 | 输入 | 返回值 | 其它 |
|---|---|---|---|---|---|
(5)用户及权限
| 用户名 | 登录位置 | 初始密码 | 权限说明 |
|---|---|---|---|
| c5_contact_db_admin | 所有 | 000000 | 对数据库具有所有权限 |
| c5_contact_db_user | 所有 | 000000 | 对数据库表具有增、删、改、查权限 |
9.1.3 从需求文档整理的数据查询需求
能够按以下指定条件查询筛选记录;
- 列出某个分组的所有联系人
- 列出某个联系人所在的分组
- 按“联系人编号、姓名、手机号、所在分组”列出所有联系人(一列显示多个分组,逗号分隔)
- 列出尚不属于任何分组的联系人
- 列出尚无联系人的分组
- 能够按以下指定条件统计信息
- 按分组统计联系人人数
- 列出每个联系人的分组数
9.2 数据查询
9.2.1 列出某个分组的所有联系人
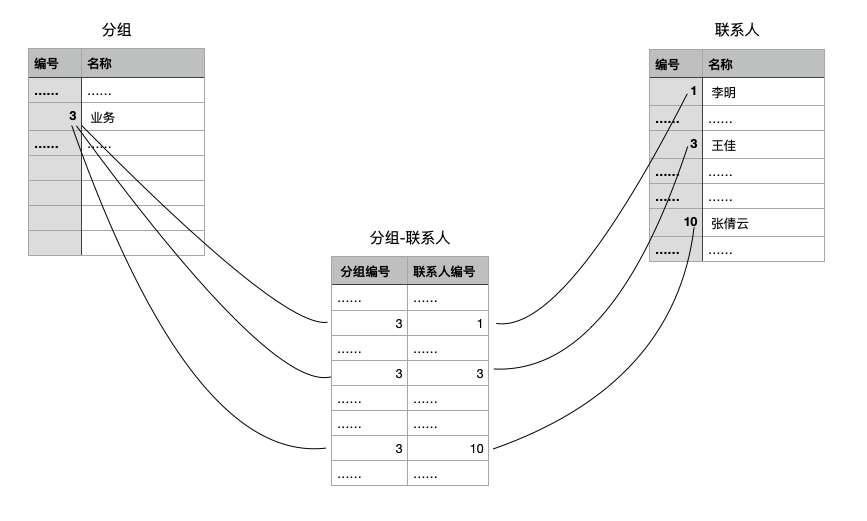
select g.name,c.name,c.mobile,c.emailfrom contacts c inner join contact_group cgon c.id=cg.contact_idinner join groups gon cg.group_id=g.idwhere g.name='业务';
简洁写法:
select g.name,c.name,c.mobile,c.emailfrom contacts c, contact_group cg, groups gwherec.id=cg.contact_id andcg.group_id=g.id andg.name='业务';
- 能够按以下指定条件查询筛选记录;
- 列出某个分组的所有联系人
- 列出某个联系人所在的分组
- 按“联系人编号、姓名、手机号、所在分组”列出所有联系人(一列显示多个分组,逗号分隔)
- 列出尚不属于任何分组的联系人
- 列出尚无联系人的分组
- 能够按以下指定条件统计信息
- 按分组统计联系人人数
- 列出每个联系人的分组数
9.2.2 列出某个联系人所在的分组
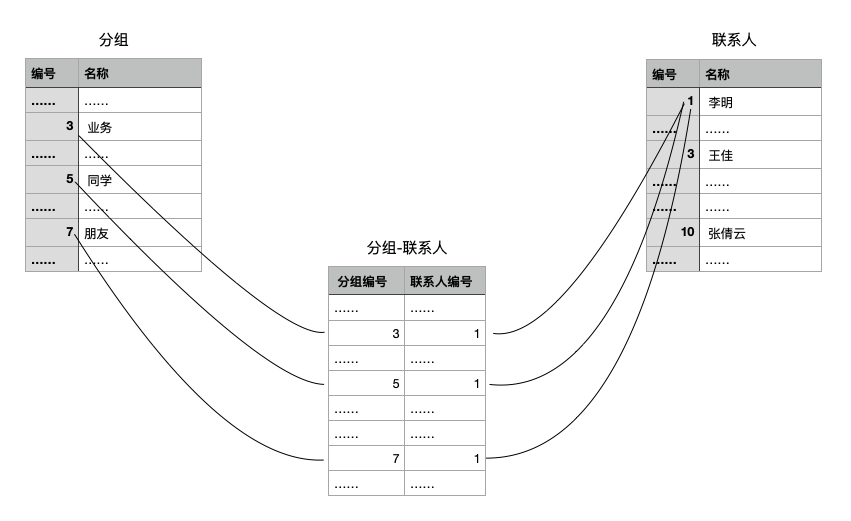
select g.name,c.name,c.mobile,c.emailfrom groups g inner join contact_group cgon g.id=cg.group_idinner join contacts con cg.contact_id=c.idwhere c.name='李明';
简洁写法:
select g.name,c.name,c.mobile,c.emailfrom groups g, contact_group cg, contacts cwhereg.id=cg.group_id andcg.contact_id=c.id andc.name='李明';
- 能够按以下指定条件查询筛选记录;
- 列出某个分组的所有联系人
- 列出某个联系人所在的分组
- 按“联系人编号、姓名、手机号、所在分组”列出所有联系人(一列显示多个分组,逗号分隔)
- 列出尚不属于任何分组的联系人
- 列出尚无联系人的分组
- 能够按以下指定条件统计信息
- 按分组统计联系人人数
- 列出每个联系人的分组数
9.2.3 按“联系人编号、姓名、手机号、所在分组”列出所有联系人
select c.id,c.name,c.mobile,(select group_concat(distinct g.name separator ', ') from groups g, contact_group cg where g.id=cg.group_id and cg.contact_id=c.id) as groupsfrom contacts c;
- 能够按以下指定条件查询筛选记录;
- 列出某个分组的所有联系人
- 列出某个联系人所在的分组
- 按“联系人编号、姓名、手机号、所在分组”列出所有联系人(一列显示多个分组,逗号分隔)
- 列出尚不属于任何分组的联系人
- 列出尚无联系人的分组
- 能够按以下指定条件统计信息
- 按分组统计联系人人数
- 列出每个联系人的分组数
9.2.4 列出尚不属于任何分组的联系人
select c.id, c.name, c.mobilefrom contacts cwhere(select count(*) from contact_group cg where cg.contact_id=c.id)=0;
- 能够按以下指定条件查询筛选记录;
- 列出某个分组的所有联系人
- 列出某个联系人所在的分组
- 按“联系人编号、姓名、手机号、所在分组”列出所有联系人(一列显示多个分组,逗号分隔)
- 列出尚不属于任何分组的联系人
- 列出尚无联系人的分组
- 能够按以下指定条件统计信息
- 按分组统计联系人人数
- 列出每个联系人的分组数
9.2.5 列出尚无联系人的分组
select g.id,g.name from groups gwhere(select count(*) from contact_group cg where cg.group_id=g.id)=0;
- 能够按以下指定条件查询筛选记录;
- 列出某个分组的所有联系人
- 列出某个联系人所在的分组
- 按“联系人编号、姓名、手机号、所在分组”列出所有联系人(一列显示多个分组,逗号分隔)
- 列出尚不属于任何分组的联系人
- 列出尚无联系人的分组
- 能够按以下指定条件统计信息
- 按分组统计联系人人数
- 列出每个联系人的分组数
9.3 数据统计与维护
9.3.1 统计
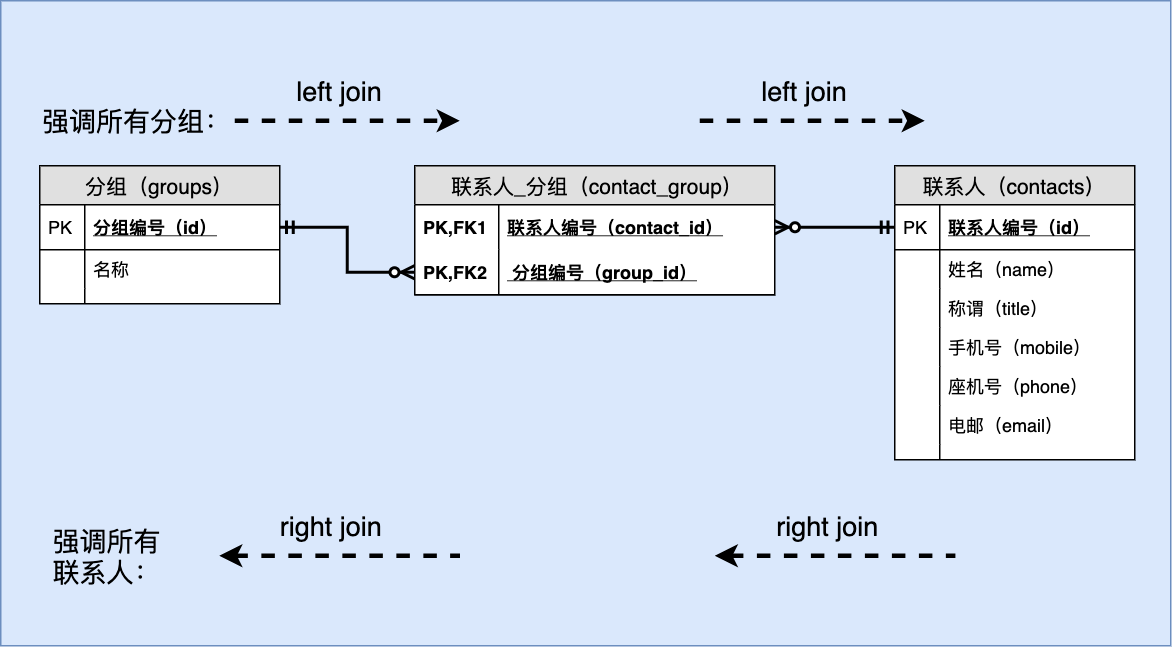
(1)按分组统计联系人人数
select g.id, g.name, count(c.id)from groups g left join contact_group cgon g.id=cg.group_idleft join contacts con cg.contact_id=c.idgroup by g.id;
- 能够按以下指定条件查询筛选记录;
- 列出某个分组的所有联系人
- 列出某个联系人所在的分组
- 按“联系人编号、姓名、手机号、所在分组”列出所有联系人(一列显示多个分组,逗号分隔)
- 列出尚不属于任何分组的联系人
- 列出尚无联系人的分组
- 能够按以下指定条件统计信息
- 按分组统计联系人人数
- 列出每个联系人的分组数
(2)列出每个联系人的分组数
select c.id, c.name, count(g.id)from groups g right join contact_group cgon g.id=cg.group_idright join contacts con cg.contact_id=c.idgroup by c.id;
- 能够按以下指定条件查询筛选记录;
- 列出某个分组的所有联系人
- 列出某个联系人所在的分组
- 按“联系人编号、姓名、手机号、所在分组”列出所有联系人(一列显示多个分组,逗号分隔)
- 列出尚不属于任何分组的联系人
- 列出尚无联系人的分组
- 能够按以下指定条件统计信息
- 按分组统计联系人人数
- 列出每个联系人的分组数
9.3.2 数据维护
新增一个联系人,并把他加到“同事”组。
insert into contacts (name,mobile) values('张洁1','13887879090');insert into contact_group(contact_id,group_id)values((select last_insert_id()),(select id from groups where name='同事'));
last_insert_id(): 最后一次插入或更新操作对应的自动增长列的值。
练习
1、新建一个与现有分组同名的分组,查看出错情况。
2、新建一个分组,把一个现有的联系人加入这个分组,并列出这个分组的所有联系人进行确认。
3、删除一个分组,确信这个分组的编号不再在 contact_group 表中出现。
4、删除一个联系人,确信这个联系人的编号不再在 contact_group 表中出现。
5、列出所有分组及所有联系人(全连接)。
第十章 案例六 具有关联属性的多对多关系:订单管理
10.1 解读设计稿
10.1 E-R 图
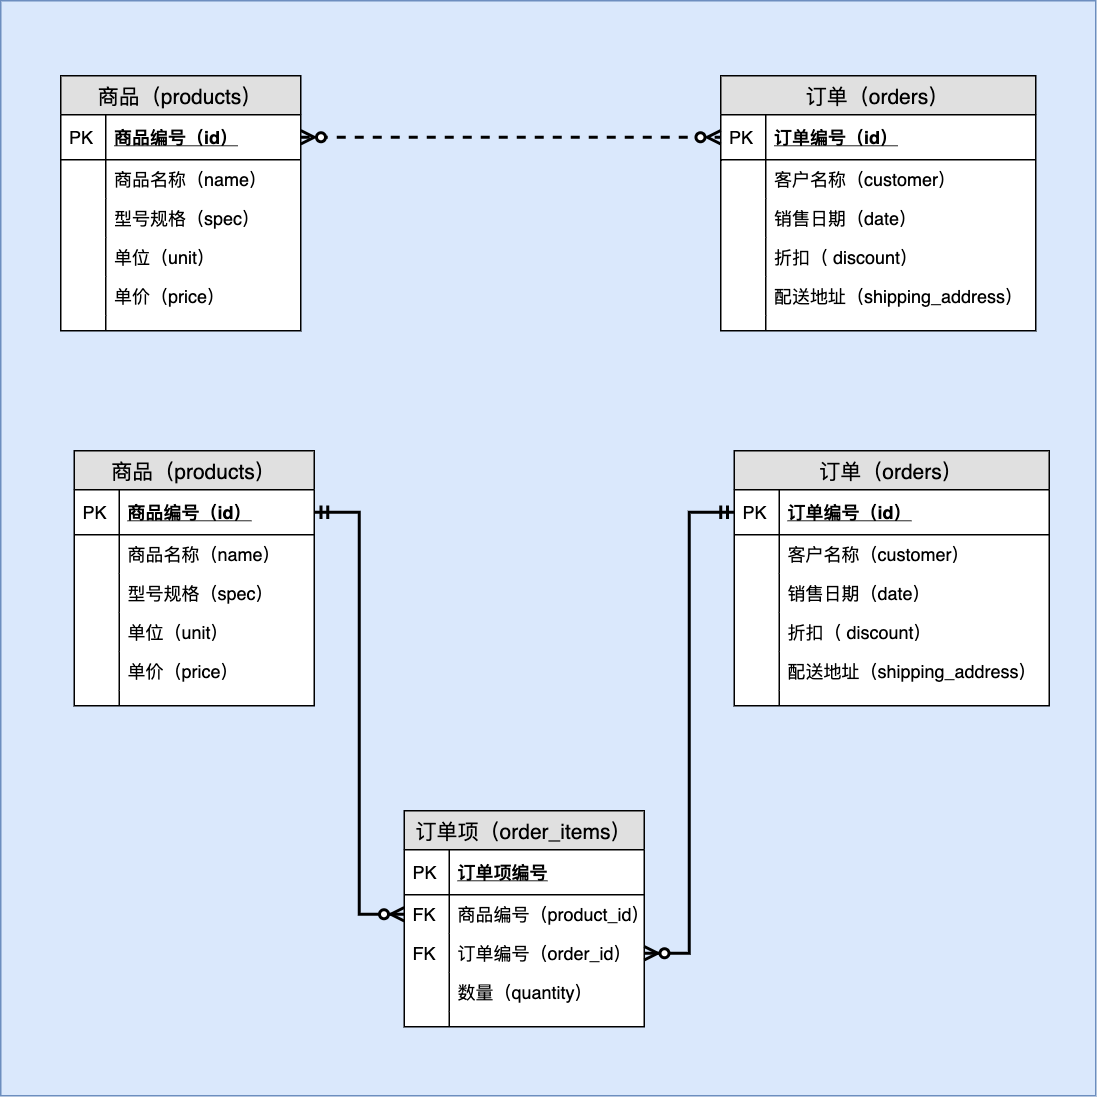
10.1.2 数据字典
(1)表定义
表名: 商品( products)
| 序号 | 列名 | 英文名 | 数据类型 | 必填? | 关键列 | 默认值 | 其它说明 |
|---|---|---|---|---|---|---|---|
| 1 | 商品编号 | id | BIGINT UNSIGNED | ✓ | PK | NULL | AUTO_INCREMENT |
| 2 | 名称 | name | VARCHAR(50) | ✓ | UNI | NULL | 与型号规格组合唯一 |
| 3 | 型号规格 | spec | VARCHAR(200) | ✓ | NULL | 与名称组合唯一 | |
| 4 | 单位 | unit | VARCHAR(10) | ✓ | NULL | ||
| 5 | 单价 | price | DECIMAL(10,2) UNSIGNED | ✓ | NULL |
表名: 订单(orders)
| 序号 | 列名 | 英文名 | 数据类型 | 必填? | 关键列 | 默认值 | 其它说明 |
|---|---|---|---|---|---|---|---|
| 1 | 订单编号 | id | BIGINT UNSIGNED | ✓ | PK | NULL | AUTO_INCREMENT |
| 2 | 客户名称 | customer | VARCHAR(50) | ✓ | NULL | ||
| 3 | 销售日期 | date | DATE | NOW() | |||
| 4 | 折扣 | discount | DECIMAL(3,2) UNSIGNED | 1.00 | 不大于 1.00 | ||
| 5 | 配送地址 | shipping_address | VARCHAR(200) | '' |
表名:订单项( order_items)
| 序号 | 列名 | 英文名 | 数据类型 | 必填? | 关键列 | 默认值 | 其它说明 |
|---|---|---|---|---|---|---|---|
| 1 | 订单编号 | order_id | BIGINT UNSIGNED | ✓ | PK,FK | NULL | 参照 orders.id 更新:级联 删除:级联 |
| 2 | 商品编号 | product_id | BIGINT UNSIGNED | ✓ | PK,FK | NULL | 参照 products.id 更新:级联 删除:限制 |
| 3 | 数量 | quantity | INT | 1 |
(2)触发器
表名:
| 序号 | 名称 | 时机 | 功能 | 其它 |
|---|---|---|---|---|
(3)视图
视图名称:
| 序号 | 列名 | 英文名 | 来自 | 其它说明 |
|---|---|---|---|---|
(4)存储过程与函数
| 序号 | 名称 | 功能 | 输入 | 返回值 | 其它 |
|---|---|---|---|---|---|
(5)用户及权限
| 用户名 | 登录位置 | 初始密码 | 权限说明 |
|---|---|---|---|
| db_2_6_admin | 所有 | 000000 | 对数据库具有所有权限 |
| db_2_6_user | 所有 | 000000 | 对数据库表具有增、删、改、查权限 |
10.1.3 从需求文档整理的数据查询需求
- 能够按以下指定条件查询筛选记录;
- 列出某个订单的商品项详情(名称、型号规格、单价、单位、数量)
- 列出某个商品对应的所有订单
- 能够按以下指定条件统计信息
- 列出每个订单的信息及其总额、折扣、折扣后的总额
- 列出某项商品的历史销量变化趋势(年月)
- 列出所有销售的收入变化趋势(年月)
- 统计每个客户的购买数量与总额,降序排序
10.2 数据查询
10.2.1 列出某个订单的商品项详情(名称、型号规格、单价、单位、数量)
select o.id,o.date,o.customer,p.*,oi.quantityfrom orders o, order_items oi, products pwhere o.id=oi.order_id and oi.product_id=p.id and o.id=1;
10.2.2 列出某个商品对应的所有订单
select p.id,p.name,p.spec,o.id,o.date,o.customerfrom products p, order_items oi, orders owhere p.id=oi.product_id and oi.order_id=o.id and p.id=1;
10.3 数据统计
10.3.1 列出每个订单的信息及其总额、折扣、折扣后的总额
select o.*, sum(p.price*oi.quantity) as sum, sum(p.price*oi.quantity)*o.discount as discount_sumfrom products p, order_items oi, orders owhere p.id=oi.product_id and oi.order_id=o.idgroup by o.id;
10.3.2 列出某项商品的历史销量变化趋势(年月)
select concat(year(o.date),'-',lpad(month(o.date),2,"0")) as yearmonth,p.id,p.name,p.spec,sum(p.price*oi.quantity) as total_price, sum(oi.quantity) as total_quantityfrom products p, order_items oi, orders owhere p.id=oi.product_id and oi.order_id=o.idgroup by yearmonthorder by yearmonth;
10.3.3 列出所有销售的收入变化趋势(年月)
select concat(year(o.date),'-',lpad(month(o.date),2,"0")) as yearmonth,sum(p.price*oi.quantity) as total_pricefrom products p, order_items oi, orders owhere p.id=oi.product_id and oi.order_id=o.idgroup by yearmonthorder by yearmonth;
10.3.4 统计每个客户的购买数量与总额,降序排序
select o.customer,sum(oi.quantity) as total_quantity, sum(p.price*oi.quantity) as total_pricefrom products p, order_items oi, orders owhere p.id=oi.product_id and oi.order_id=o.idgroup by o.customerorder by total_quantity desc, total_price desc;
第三部分 数据库的设计
第十 一章 数据库的设计原则
1 1.1 表的三个范式
范式是表的设计的规范模式。通常我们需要将表设计到第三范式的层次。
11.1.1 第一范式
(1)表的每个列的信息应当足够细化(原子性)
所谓“原子性”,就是说列的信息不能或不需要再细化。
看看下面这个表格:
| 编号 | 姓名 | 性别 | 出生日期 |
|---|---|---|---|
| 001 | 吴小燕 | 女 | 1998-11-23 |
表中各列是否足够细化,即具备“原子性”了呢?
事实上,原子性是相对的。比这个表对应的管理系统不要求对人的“姓”和“名”分开处理,那么,这张表的名列都具备了原子性。
但如果系统需要对人的“姓”和“名”分开处理,那么,“姓名”一列就不具备原子性,你应该各用一列来存储“姓”和“名”。
| 编号 | 姓 | 名 | 性别 | 出生日期 |
|---|---|---|---|---|
| 001 | 吴 | 小燕 | 女 | 1998-11-23 |
(2)表的单元格里不能存储多值
如果出现多值,就需要考虑拆分表格。
如以下表格就是不符合第一范式要求的:
联系人
| 姓名 | 电话 | 分组 |
|---|---|---|
| 李名 | 13030309887,18988977653 | 朋友,同事,同学 |
(3)每个表格行必须要有能够和其它行区分开来的一列(或多列的组合)
这样的列(或多列的组合)叫“候选键列”。
这样的列(或列的组合)可能有多个,可选定其中一个作为“主键”,其它的设定为“唯一键”
如以下表格也是不符合第一范式的:
会员名单
| 姓名 | 性别 | 出生日期 | 入会日期 |
|---|---|---|---|
| 张小敏 | 女 | 1998-02-12 | 2019-12-20 |
| 李娜 | 女 | 1999-11-23 | 2019-12-20 |
| 张小敏 | 女 | 1998-02-12 | 2019-12-20 |
同一个人?不同的人?
11.1.2 第二范式
(1)满足第一范式
(2)所有列都依赖于全部候选键列
即对于有多列组合候选键列的表来说,它的各个列的信息都同时与组合候选键列中的所有列有关。
比如,以下表格就不符合第二范式:
工时记录
| 职员编号 | 职员姓名 | 项目编号 | 项目名称 | 工时 |
|---|---|---|---|---|
| 1 | 周小小 | 17 | 光明路改造工程 | 68 |
| 1 | 周小小 | 21 | 海天小区装修 | 120 |
| 2 | 王明军 | 17 | 光明路改造工程 | 50 |
候选键列:职员编号+项目编号
“工时”列与候选键列相关(某职员在某工程上的工作时间)
“职员姓名”只与“职员编号”有关
“项目名称”只与“项目编号”有关
11.1.3 第三范式
(1)满足第二范式
(2)不能出现传递依赖
表中的列不能只依赖于其它非候选键列。
如以下表格就不符合第三范式:
员工信息
| 员工编号 | 姓名 | 性别 | 所属分公司 | 分公司地址 | 分公司电话 |
|---|---|---|---|---|---|
| 1 | 吴小娟 | 女 | 昆明分公司 | 昆明市盘龙区某路某号 | 0871-88987656 |
“所属分公司”决定于员工,因为它是员工的属性。
“分公司地址”和“分公司电话”只决定于“所属分公司”,“所属分公司”不是候选键列!
11.2 表设计要遵循的原则
11.2.1 正确识别管理的实体以及它们之间的相互关系
从需求描述中抽取管理涉及的事物,并确立它们之间的关系。
两张表可能有的关系是:“一对多”关系(特例“一对一”),“多对多关系”(需要分解为两个一对多关系)。
11.2.2 合理设计实体的属性(列)
需要满足第三范式。
11.2.3 处理多值列衍生新实体
(1)多值为实体的非共享属性值
非共享属性值,指实体专属的原子性信息,如手机号,银行卡号等。
在这种情况下,只需要把原来的表拆分成两张表(增加了一个实体),建立“一对多”关系就好。
联系人信息(需要记录多个手机号)
| 联系人编号 | 姓名 | 手机号 |
|---|---|---|
| 0103 | 王明 | 13887870987,13323467653 |
永远不要像这样:
联系人编号 姓名 手机号1 手机号2 0103 王明 13887870987 13323467653 因为通常你不知道需要预留多少个手机号码列(不要试图在以后轻易变动表结构)。
因此,“不要有同样信息的重复列”!
拆分:
联系人
| 联系人编号 | 姓名 |
|---|---|
| 0103 | 王明 |
联系人手机号
| 手机号 | 联系人编号 |
|---|---|
| 13887870987 | 0103 |
| 13323467653 | 0103 |
“手机号”和“联系人编号”设定为“组合主键”,也可人为添加一列自动增长列为“主键”,“手机号”和“联系人编号”则设定为“组合唯一键”。
“联系人编号”设定为“外键”参考“联系人”表的主键“联系人编号”。
(2)多值为需要共享的值或实体
如果值是需要共享的,就必须保持一致,从而应该把它们作为实体(单独建表进行管理)来对待。
如在某个应用中,一个“联系人”有多个共享的“分组”,意味着这些分组应该有前后一致的名称。“分组”就应该作为一个实体来对待,从而避免“朋友”和“朋 友”的不一致。
多值为共享的实体后,就需要拆分为三张表,建立两个一对多关系(增加了两个实体)。
比如以下联系人信息(只需要记录一个手机号):
| 姓名 | 手机 | 分组 |
|---|---|---|
| 李名 | 13030309887 | 朋友,同事,同学 |
| 王成 | 13398897875 | 同事,朋 友 |
拆分:
联系人
| 联系人编号 | 姓名 | 手机 |
|---|---|---|
| 0123 | 李名 | 13030309887 |
| 0124 | 王成 | 13398897875 |
分组
| 分组编号 | 分组名称 |
|---|---|
| 1 | 朋友 |
| 2 | 同事 |
| 3 | 同学 |
分组-联系人
| 分组编号 | 联系人编号 |
|---|---|
| 1 | 0123 |
| 2 | 0123 |
| 3 | 0123 |
| 1 | 0124 |
| 2 | 0124 |
“分组编号”与“联系人编号”组合唯一。
第十二章 案例一 单表设计:管理库存商品
1 2.1 需求分析
12.1.1 需求与原始数据
(1)需求描述
有一商店,需要把库存商品用数据库进行管理,需求如下:
- 能够根据商品名称、品牌、型号、规格的关键字及各种价格范围查询商品并排序;
- 能够进行各种统计
- 各种商品的库存总数及成本总额;
- 某种商品在各种型号上的库存总数及成本总额;
- 能够统计表中各类数据的平均值、合计值;
- 能够列出所有商品名称而不重复。
(2)原始库存商品数据
| 名称 | 描述(品牌型号规格等) | 单位 | 销售单价 | 成本单价 | 库存量 | 成本小计 | 售价小计 |
|---|---|---|---|---|---|---|---|
| 打印机 | HP DeskJet2622 | 台 | 429.00 | 360.00 | 12 | 4320 | 5148.00 |
| 打印机 | EPSON L4168 | 台 | 1499.00 | 1100.00 | 7 | 7700.00 | 10493.00 |
| 显卡 | 蓝宝石 RX580 2048SP 4G | 张 | 1099.00 | 899.00 | 23 | 20677.00 | 25277.00 |
| 显示器 | LG HDR10 27寸 4K | 台 | 2199.00 | 1699.00 | 21 | 35679.00 | 46179.00 |
| 显卡 | 蓝宝石 RX580 2304SP 8G | 张 | 2549.00 | 1899.00 | 16 | 30384.00 | 40784.00 |
| 显示器 | AOC I2490PXH5 23.8英寸 | 台 | 799.00 | 550.00 | 12 | 6600.00 | 9588.00 |
12.2 E-R 图
12.2.1 确定管理涉及的数据实体及其关系
在本例中,实体只有一个,即“商品”。
12.2.2 确定管理涉及的各实体的属性(列)
根据需求描述与原始数据,实体目前应包含以下属性:
名称、品牌、型号、规格、单位、销售单价、成本单价、库存量、成本小计、售价小计等。
按第三范式要求,属性确立为:
商品编号、名称、品牌、型号、规格、单位、销售单价、成本单价、库存量
商品编号为自动增长的数字主键,名称、品牌、型号、规格为组合候选键,设定为“唯一组合健”。
成本小计只依赖于成本单价及库存量,且可计算得到,去除;
售价小计只依赖于销售单价及库存量,且可计算得到,去除。
通常不需要能够从其它列计算出来的列,因为存储的值和计算结果可能造成不一致。比如“成本小计”=“成本单价”ד库存量”。如果改变了“成本单价”或“库存量”,“成本小计”就需要重新计算。除非有充分理由保留计算列(比如在计算复杂耗时的情况下出于对查询性能的考虑),那就要自行实现某种机制(如触发器)来保持数据的一致性。
12.2.3 绘制 E-R 图
根据以上分析,绘制 E-R图如下:
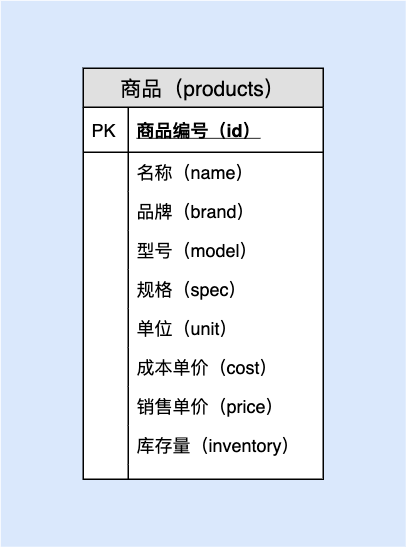
12.3 数据字典
12.3.1 表定义
表名: 商品( products)
| 序号 | 列名 | 英文名 | 数据类型 | 必填? | 关键列 | 默认值 | 其它说明 |
|---|---|---|---|---|---|---|---|
| 1 | 商品编号 | id | BIGINT UNSIGNED | ✓ | PK | NULL | AUTO_INCREMENT |
| 2 | 名称 | name | VARCHAR(50) | ✓ | UNI | NULL | 与品牌、型号、规格组合唯一 |
| 3 | 品牌 | brand | VARCHAR(200) | ✓ | NULL | 与名称、型号、规格组合唯一 | |
| 4 | 型号 | model | VARCHAR(200) | '' | 与名称、品牌、规格组合唯一 | ||
| 5 | 规格 | spec | VARCHAR(200) | '' | 与名称、品牌、型号组合唯一 | ||
| 6 | 单位 | unit | VARCHAR(10) | ✓ | NULL | ||
| 7 | 销售单价 | price | DECIMAL(10,2) | ✓ | NULL | >=0 | |
| 8 | 成本单价 | cost | DECIMAL(10,2) | ✓ | NULL | >=0 | |
| 9 | 库存量 | inventory | INT | ✓ | NULL | >=0 |
整理后的数据:
| 商品编号 | 名称 | 品牌 | 型号 | 规格 | 单位 | 销售单价 | 成本单价 | 库存量 |
|---|---|---|---|---|---|---|---|---|
| 1 | 打印机 | HP | DeskJet 2622 | 台 | 429.00 | 360.00 | 12 | |
| 2 | 打印机 | EPSON | L4168 | 台 | 1499.00 | 1100.00 | 7 | |
| 3 | 显卡 | 蓝宝石 | RX 580 | 2048SP 8G | 张 | 1099.00 | 899.00 | 23 |
| 4 | 显示器 | LG | HDR10 | 27寸 4K | 台 | 2199.00 | 1699.00 | 21 |
| 5 | 显卡 | 七彩虹 | RX 580 | 2304SP 8G | 张 | 2549.00 | 1899.00 | 16 |
| 6 | 显示器 | AOC | I2490PXH5 | 23.8英寸 | 台 | 799.00 | 550.00 | 12 |
空串与空值:
空串:''(两个紧靠着的引号间没有空隔),是一个空的字符串值,可参与字符串的运算。
空值:null,无值,真空!不能参与任何运算。比如不能做各种比较运算。
自动增长的 ID 用 INT 还是 BIGINT?
假定数据库系统很繁忙,并且数据量无限大,平均 1 秒产生一条新记录,用 INT 或 BIGINT 作 ID,什么时候会把可用的数值耗尽?
INT 无符号数可用 4294967295 / (365×24×60×60) = 136.19 年。
BIGINT 无符号数可用 18446744073709551615 / (365×24×60×60) = 584942417355.07 (5849 亿)年
12.3.2 触发器
(无)
12.3.3 视图
(无)
12.3.4 函数和存储过程
(无)
12.4 编写脚本
drop database if exists `db_3_1`;create database if not exists `db_3_1` default charset utf8mb4;use `db_3_1`;create table `products`(-- 列定义`id` bigint unsigned not null auto_increment,`name` varchar(100) not null,`brand` varchar(100) not null,`model` varchar(100) default '',`spec` varchar(100) default '',`unit` varchar(10) not null,`cost` decimal(8,2) not null,`price` decimal(8,2) not null,`inventory` int not null,-- 约束定义primary key(`id`),unique(`name`,`brand`,`model`,`spec`),check(`cost`>=0),check(`price`>=0),check(`inventory`>=0));-- 插入样例数据(用于测试等)INSERT INTO `products`(`id`,`name`,`brand`,`model`,`spec`,`unit`,`price`,`cost`,`inventory`)VALUES(null,'打印机','HP','DeskJet 2622','','台',429.00,360.00,12),(null,'打印机','EPSON','L4168','','台',1499.00,1100.00,7),(null,'显卡','蓝宝石','RX 580','2048P 4G','张',1099.00,899.00,23),(null,'显示器','LG','HDR10','27寸 4K','台',2199.00,1699.00,21),(null,'显卡','蓝宝石','RX 580','2304SP 8G','张',2549.00,1899.00,16),(null,'显示器','AOC','I2490PXH5','23.8英寸','台',799.00,550.00,12);
12.5 运行建库脚本并验证建库结果
12.5.1 运行脚本
MariaDB [(none)]> source [脚本所在路径\]脚本文件名;
12.5.2 验证建库结果
(1)查看表,确认表被正确建立
show tables;
(2)查看表的结构,确认列和约束被正确建立
-- 快速查看大致结构describe 表名;-- 查看详细的表定义(sql 脚本,带自动添加的默认参数)show create table 表名\G
12.6 数据操纵测试
根据需求分析中的数据操纵(增、删、改、查)需求,验证各表以及它们的相互关系的合理性。
请根据第二部分内容所学知识自行完成。
第十三章 案例二 一对一关系: 员工管理
1 3.1 需求分析
13.1.1 需求与原始数据
(1)需求描述
有一公司,用数据库管理人员信息,需求如下:
- 数据库用于记录员工的基本信息和银行帐户信息;
- 财务部门能够查看人员的所有信息,包括银行帐号信息;
- 其它部门只能看到人员的基本信息,不能查看员工银行帐号信息。
(2)原始员工记录数据
| 序号 | 身份证号 | 姓名 | 性别 | 出生日期 | 所在部门 | 工资卡开户行 | 银行卡号 |
|---|---|---|---|---|---|---|---|
| 1 | 531010198707231124 | 王小霞 | 女 | 1987-07-23 | 人事 | 中国银行 | 1234 5678 2345 1233 |
| 2 | 530103199802153211 | 李志强 | 男 | 1998-02-15 | 研发 | 中国银行 | 2323 1567 2387 9876 |
13.2 E-R 图
13.2.1 确定管理涉及的数据实体及其关系
在本例中,实体似乎只有一个,即“员工”。但从管理的角度来看,同一个员工的数据,有些数据(如银行帐户信息)只能由特定用户使用(如财务部门),从安全的角度考虑,可将它们从员工数据中剥离出来,建立具有“一对一”关系的两个实体。这样,便于从数据库系统层面限制特定用户的访问权限。
- [辨识的实体]
- 员工基本信息
- 管理人使用员工的基本信息。
- 员工银行帐号信息
- 管理和使用员工的帐户信息。
[辨识的表间关系]
每个“员工”具有一条“银行帐户”信息,每一条“银行帐户”信息属于一个“员工”,二者关系是“一对一的关系”,主表确定为“员工基本信息”,子表确定为“银行帐户信息”。
13.2.2 确定管理涉及的各实体的属性(列)
- 根据需求描述与原始数据,各实体应包含以下属性:
- 员工基本信息
- 员工编号(主键),身份证号(唯一键),姓名,性别,出生日期,所属部门。
银行帐户信息 - 帐户编号(主键),开户行,银行卡号,员工编号(外键,唯一键)
按第三范式要求,“性别”和“出生日期”均可从“身份证号”计算得到,为了保证数据的一致性,应当去除。但为了简洁起见,可保留这两个属性,但必须保证它们和身份证号中的信息一致(可用触发器进行维持)。
13.2.3 绘制 E-R 图
根据以上分析,绘制 E-R图如下:
13.3 数据字典
13.3.1 表定义
表名: 员工基本信息(employees)
| 序号 | 列名 | 英文名 | 数据类型 | 必填? | 关键列 | 默认值 | 其它说明 |
|---|---|---|---|---|---|---|---|
| 1 | 员工编号 | id | BIGINT UNSIGNED | ✓ | PK | NULL | AUTO_INCREMENT |
| 2 | 身份证号 | sid | CHAR(18) | ✓ | UNI | NULL | |
| 3 | 姓名 | name | VARCHAR( 50) | ✓ | NULL | ||
| 4 | 性别 | gender | CHAR(1) | NULL | 限于“男”和“女” | ||
| 5 | 出生日期 | birth_date | DATE | NULL | |||
| 6 | 所属部门 | department | VARCHAR(50) | ✓ | NULL |
整理后的数据:
| 员工编号 | 身份证号 | 姓名 | 性别 | 出生日期 | 所在部门 |
|---|---|---|---|---|---|
| 1 | 531010198707231124 | 王小霞 | 女 | 1987-07-23 | 人事 |
| 2 | 530103199802153211 | 李志强 | 男 | 1998-02-15 | 研发 |
表名: 银行帐户信息(bank_accounts)
| 序号 | 列名 | 英文名 | 数据类型 | 必填? | 关键列 | 默认值 | 其它说明 |
|---|---|---|---|---|---|---|---|
| 1 | 帐户编号 | id | BIGINT UNSIGNED | ✓ | PK | NULL | AUTO_INCREMENT |
| 2 | 开户行 | bank | VARCHAR(100) | ✓ | NULL | 与银行卡号组合唯一 | |
| 3 | 银行卡号 | card_no | VARCHAR(50) | ✓ | NULL | ||
| 4 | 员工编号 | employee_id | BIGINT UNSIGNED | ✓ | UNI | NULL | 外键,参考 employees.id 更新:级联 删除:级联 |
整理后的数据:
| 帐户编号 | 工资卡开户行 | 银行卡号 | 员工编号 |
|---|---|---|---|
| 1 | 中国银行 | 1234 5678 2345 1233 | 1 |
| 2 | 中国银行 | 2323 1567 2387 9876 | 2 |
13.3.2 触发器
表名:雇员信息(employees)
| 序号 | 名称 | 时机 | 功能 | 其它 |
|---|---|---|---|---|
| 1 | change_dob_gender_for_ins | 插入前 | 根据身份证号取出出生日期与性别信息填入相应列, 以保证出生日期和性别与身份证上的信息一致。 |
|
| 2 | change_dob_gender_for_upd | 更新前 | 同上 |
13.3.3 视图
(无)
13.3.4 函数和存储过程
(无)
13.4 编写脚本
drop database if exists `db_3_2`;create database if not exists `db_3_2` default charset utf8mb4;use `db_3_2`;create table `employees`(-- 列定义`id` bigint unsigned not null auto_increment,`sid` char(18) not null,`name` varchar(50) not null,`gender` char(1),`birth_date` date,`department` varchar(50) not null,-- 约束定义primary key(`id`),unique key(`sid`));create table `bank_accounts`(-- 列定义`id` bigint unsigned not null auto_increment,`bank` varchar(100) not null,`card_no` varchar(50) not null,`employee_id` bigint unsigned not null,-- 约束定义primary key(`id`),unique key(`bank`,`card_no`),foreign key(`employee_id`) references `employees`(`id`)on update cascade on delete cascade);delimiter $$create trigger change_dob_gender_for_ins before insert on employeesfor each rowbegindeclare gender_bit int;declare dob char(10);set gender_bit = cast(substring(NEW.sid,17,1) as int);set dob = concat(substring(NEW.sid,7,4),'-',substring(NEW.sid,11,2),'-',substring(NEW.sid,13,2));if gender_bit % 2 = 0 thenset NEW.gender='女';elseset NEW.gender='男';end if;if to_days(str_to_date(dob, '%Y-%m-%d')) is not null thenset NEW.birth_date=dob;elsesignal sqlstate '45000' set MESSAGE_TEXT = '身份证格式错误:日期';end if;end$$create trigger change_dob_gender_for_upd before update on employeesfor each rowbegindeclare gender_bit int;declare dob char(10);set gender_bit = cast(substring(NEW.sid,17,1) as int);set dob = concat(substring(NEW.sid,7,4),'-',substring(NEW.sid,11,2),'-',substring(NEW.sid,13,2));if gender_bit % 2 = 0 thenset NEW.gender='女';elseset NEW.gender='男';end if;if to_days(str_to_date(dob, '%Y-%m-%d')) is not null thenset NEW.birth_date=dob;elsesignal sqlstate '45000' set MESSAGE_TEXT = '身份证格式错误:日期';end if;end$$delimiter ;-- 插入样例数据(用于测试等)INSERT INTO `employees`(`id`,`sid`,`name`,`department`)VALUES(1,'531010198707231124','王小霞','人事'),(2,'530103199802153211','李志强','研发');INSERT INTO `bank_accounts`(bank,card_no,employee_id)values('中国银行','1234 5678 2345 1233',1),('中国银行','2323 1567 2387 9876',2);-- 注意观察性别和出生日期已经被正确填入select * from employees;
13.5 运行建库脚本并验证建库结果
13.5.1 运行脚本
MariaDB [(none)]> source [脚本所在路径\]脚本文件名;
13.5.2 验证建库结果
(1)查看表,确认表被正确建立
show tables;
(2)查看表的结构,确认列和约束被正确建立
-- 快速查看大致结构describe 表名;-- 查看详细的表定义(sql 脚本,带自动添加的默认参数)show create table 表名\G
(3)查看触发器
show triggers\G
13.6 数据操纵测试
请自行完成。
第十 四章 案例三 一对多关系:商品分类管理
14.1 需求分析
14.1.1 需求与原始数据
(1)需求描述
有一公司,用数据库对商品进行分类管理,商品可以按任意级别进行分类。数据查询需求如下:
- 可按分类关键字查询商品,显示商品分类(级联显示,如:服装 > 鞋 > 皮鞋...)及商品详情;
- 可按分类编号查询商品,显示商品分类(级联显示,如:服装 > 鞋 > 皮鞋...)及商品详情;
- 可按商品名称查找所有商品,显示商品分类(级联显示,如:服装 > 鞋 > 皮鞋...)及商品详情。
(2)原始数据(略)
14.2 E-R 图
14.2.1 确定管理涉及的数据实体及其关系
在本例中,可确定的实体有“商品”和“分类”。因为商品需要按任意级别进行分类,意味着分类是分级的,顶级分类 > 下级分类 > 下下级分类...,如果每级分类一个实体,则无法确定需要多少个“某级分类”实体。事实上,这种分级别的实体,它们具有同样的属性,可用一种“自关联”的实体来实现。
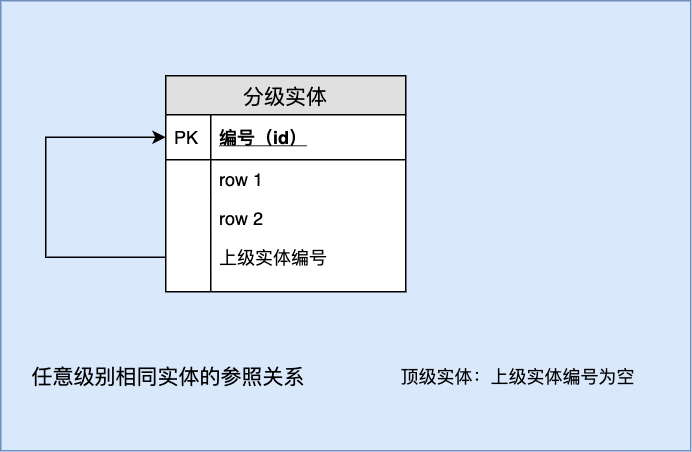
以“分类”为例,自关联的表实现“电器>家用电器>洗衣机”和“书籍>社科类>哲学类>外国作品”的例子:
| 分类编号 | 分类名称 | 上级分类编号 |
|---|---|---|
| 1 | 电器 | NULL |
| 2 | 家用电器 | 1 |
| 3 | 洗衣机 | 2 |
| 4 | 书籍 | NULL |
| 5 | 社科类 | 4 |
| 6 | 哲学类 | 5 |
| 7 | 外国作品 | 6 |
| 8 | 电冰箱 | 2 |
[辨识的实体]
商品分类
管理和使用商品的分级分类信息。
商品
管理和使用商品信息。
[辨识的表间关系]
每个“顶级分类”具有零个到多个“下级分类”,分类具有自关联的“一对多”关系;
每种“分类”具有多个“商品”,一个“商品”只属于一种分类。“分类”与“商品”是“一对多”的关系。
14.2.2 确定管理涉及的各实体的属性(列)
根据需求描述,各实体应包含以下属性:
商品分类
分类编号(主键),分类名称,分类说明,上级分类编号。
商品
商品编号(主键),商品代码,名称,品牌,型号,规格,单位,分类编号(外键)
表的设计满足第三范式要求。
14.2.3 绘制 E-R 图
根据以上分析,绘制 E-R图如下:
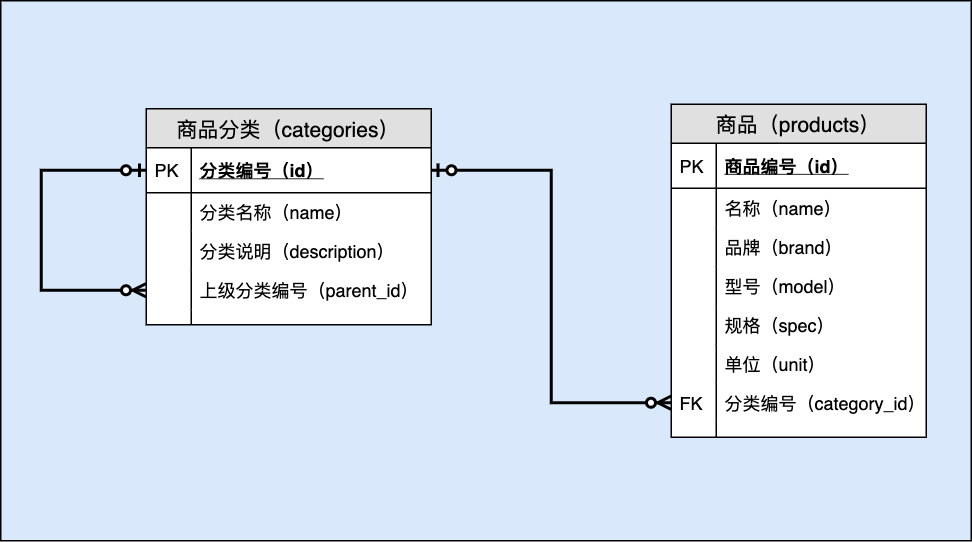
14.3 数据字典
14.3.1 表定义
表名: 商品分类( categories)
| 序号 | 列名 | 英文名 | 数据类型 | 必填? | 关键列 | 默认值 | 其它说明 |
|---|---|---|---|---|---|---|---|
| 1 | 分类编号 | id | BIGINT UNSIGNED | ✓ | PK | NULL | AUTO_INCREMENT |
| 2 | 商品代码 | code | CHAR(12) | ✓ | UNI | NULL | |
| 3 | 分类名称 | name | VARCHAR(50) | ✓ | NULL | ||
| 4 | 分类说明 | description | VARCHAR(200) | NULL | |||
| 5 | 上级分类编号 | parent_id | BIGINT UNSIGNED | FK | NULL | 参照 categories.id 更新:级联 删除:限制 |
表名: 商品(products)
| 序号 | 列名 | 英文名 | 数据类型 | 必填? | 关键列 | 默认值 | 其它说明 |
|---|---|---|---|---|---|---|---|
| 1 | 商品编号 | id | BIGINT UNSIGNED | ✓ | PK | NULL | AUTO_INCREMENT |
| 2 | 名称 | name | VARCHAR(100) | ✓ | NULL | 与品牌、型号、规格组合唯一 | |
| 3 | 品牌 | brand | VARCHAR(100) | ✓ | NULL | ||
| 4 | 型号 | model | VARCHAR(100) | '' | |||
| 5 | 规格 | spec | VARCHAR(100) | '' | |||
| 6 | 单位 | unit | VARCHAR(50) | ✓ | NULL | ||
| 7 | 分类编号 | category_id | BIGINT UNSIGNED | FK | NULL | 参照 employees.id 更新:级联 删除:置空 |
14.3.2 触发器
(无)
14.3.3 视图
(无)
14.3.4 函数和存储过程
| 序号 | 名称 | 功能 | 输入 | 返回值 | 其它 |
|---|---|---|---|---|---|
| 1 | get_cate_by_id | 获取 分类级联名称 | 分类 ID | VARCHAR(200), 级联名称,如: 电器>昆明市>盘龙区家用电器>洗衣机 |
函数 |
| 2 | get_cate_by_name | 获取一组分类级联名称 | 类别关键字 | 结果集:一组分类级联名称 | 过程 |
14.4 编写脚本
DROP DATABASE IF EXISTS `product_store`;CREATE DATABASE IF NOT EXISTS `product_store` DEFAULT CHARSET utf8mb4;USE `product_store`;CREATE TABLE `categories`(-- define columns`id` BIGINT UNSIGNED NOT NULL AUTO_INCREMENT,`name` VARCHAR(50) NOT NULL,`description` VARCHAR(200),`parent_id` BIGINT UNSIGNED,-- define constriantsCONSTRAINT `cate_pk` PRIMARY KEY (`id`),CONSTRAINT `cate-uni` UNIQUE KEY (`name`,`parent_id`),CONSTRAINT `cate-fk` FOREIGN KEY (`parent_id`) REFERENCES `categories`(`id`)ON UPDATE CASCADEON DELETE RESTRICT);CREATE TABLE `products`(-- define columns`id` BIGINT UNSIGNED NOT NULL AUTO_INCREMENT,`code` CHAR(12) NOT NULL,`name` VARCHAR(100) NOT NULL,`brand` VARCHAR(100) NOT NULL,`type` VARCHAR(100) DEFAULT '',`spec` VARCHAR(100) DEFAULT '',`unit` VARCHAR(50) NOT NULL,`category_id` BIGINT UNSIGNED,-- define constraintCONSTRAINT `prod_pk` PRIMARY KEY (`id`),CONSTRAINT `prod_code_uni` UNIQUE KEY (`code`),CONSTRAINT `prod_cate_fk` FOREIGN KEY (`category_id`) REFERENCES `categories`(`id`)ON UPDATE CASCADEON DELETE SET NULL);SET NAMES utf8;INSERT INTO `categories`VALUES(1,'电器','所有电器产品归为此类',null),(2,'服装','',null),(3,'食品','',null),(4,'家用电器','',1),(5,'工业电器','',1),(6,'空调制冷','',4),(7,'空调制冷','',5),(8,'空调','',6);INSERT INTO `products`VALUES(NULL,'P00000000001','中央空调','海尔','HR001','变频','台',8);DROP FUNCTION IF EXISTS `get_cate_by_id`;DROP PROCEDURE IF EXISTS `get_cate_by_name`;DELIMITER $$CREATE FUNCTION `get_cate_by_id`(cid BIGINT UNSIGNED) RETURNS VARCHAR(200)BEGINDECLARE cate_name VARCHAR(200);SET cate_name = '';get_name: LOOPSELECT `name`, `parent_id` INTO @name, @pid FROM `categories` WHERE `id`=cid;IF cate_name='' THENSET cate_name = @name;ELSESET cate_name = CONCAT(@name, '>' , cate_name);END IF;IF @pid IS NOT NULL THENSET cid = @pid;ITERATE get_name;ELSELEAVE get_name;END IF;END LOOP get_name;RETURN cate_name;END$$CREATE PROCEDURE `get_cate_by_name`(s_name VARCHAR(50))BEGINSELECT id,get_cate_by_id(`id`) FROM `categories` WHERE `name` LIKE CONCAT('%',s_name,'%') ORDER BY `id`;END$$DELIMITER ;SET NAMES gbk;SELECT * FROM `categories`;SELECT * FROM `products`;
14.5 运行建库脚本并验证建库结果
14.5.1 运行脚本
MariaDB [(none)]> source [脚本所在路径\]脚本文件名;
14.5.2 验证建库结果
(1)查看表,确认表被正确建立
show tables;
(2)查看表的结构,确认列和约束被正确建立
-- 快速查看大致结构describe 表名;-- 查看详细的表定义(sql 脚本,带自动添加的默认参数)show create table 表名\G
(3)查看函数
-- 列出数据库中定义的函数show function status where db='db_3_3'\G-- 显示函数 get_cate_by_id 的详细定义show create function get_cate_by_id\G
(4)查看存储过程
-- 列出数据库中定义的函数show procedure status where db='db_3_3'\G-- 显示函数 get_cate_by_name 的详细定义show create procedure get_cate_by_name\G
14.6 数据操纵测试
请插入必要的数据自行完成。
第十五章 案例四 多对多关系:工程项目管理
15.1 需求分析
15.1.1 需求与原始数据
(1)需求描述
有一工程设计公司,用数据库对工程人员在工程项目上的设计工时进行记录。一个设计人员可参与多个工程项目的设计,一个工程项目可有多个设计人员,每个工程项目具有特定的设计工时报酬。每个设计人员具有公司分配的 6 位工号。数据查询需求如下:
- 数据查询
- 查询某位设计人员参与的所有工程项目
- 查询某工程项目的所有参与人员
- 数据统计
- 统计所有设计人员在某项工程上的工时和相应报酬
(2)原始数据(略)
15.2 E-R 图
15.2.1 确定管理涉及的数据实体及其关系
在本例中,可确定的实体有“设计人员”和“工程项目”。
根据需求,一个“设计人员”可参与多个“工程项目”的设计,一个“工程项目”可有多个“设计人员”,“设计人员”与“工程项目”是“多对多”的关系。
因不可能在数据库中直接实现“多对多”的关系,我们需要增加另一个实体,将“多对多”关系分解成两个“一对多”关系。
“设计人员”与“工程项目” 之间的“参与设计”关系将二者联系在一起,这一关系产生了“工时”属性。
[辨识的实体]
设计人员
管理和使用设计人员的信息。
工程项目
管理和使用工程项目的信息。
设计记录
用于记录设计人员参与工程设计的情况
[辨识的表间关系]
“设计人员”与“工程项目”是“多对多”的关系,通过分解,一个“设计人员”与“设计记录”是“一对多”的关系,一个“工程项目”与“设计记录”也是“一对多”的关系。
15.2.2 确定管理涉及的各实体的属性(列)
根据需求描述,各实体应包含以下属性:
设计人员
人员编号(主键),工号(唯一),姓名,性别,出生日期。
工程项目
项目编号(主键),名称(唯一),地点,设计工时报酬。
设计记录
记录编号(主键),人员编号(外键),项目编号(外键),工时数。
表的设计满足第三范式要求。
15.2.3 绘制 E-R 图
根据以上分析,绘制 E-R图如下:
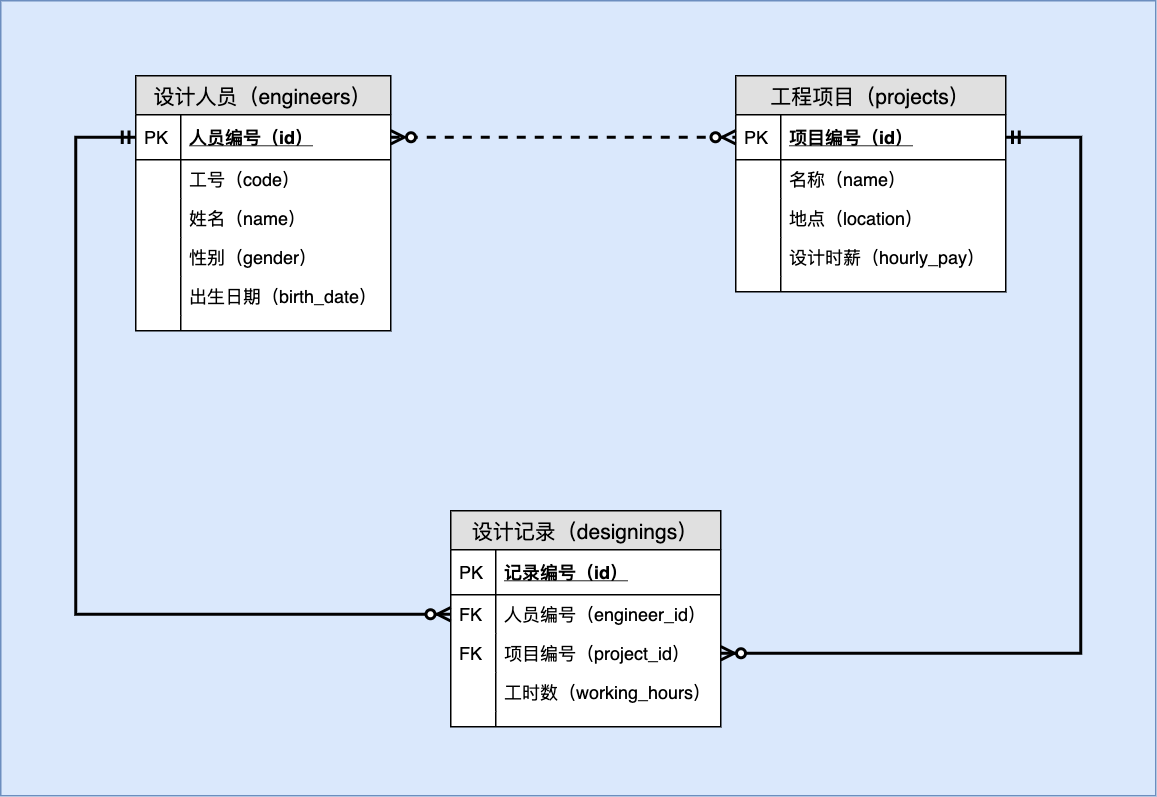
15.3 数据字典
15.3.1 表定义
表名: 设计人员(engineers)
| 序号 | 列名 | 英文名 | 数据类型 | 必填? | 关键列 | 默认值 | 其它说明 |
|---|---|---|---|---|---|---|---|
| 1 | 人员编号 | id | BIGINT UNSIGNED | ✓ | PK | NULL | AUTO_INCREMENT |
| 2 | 工号 | code | CHAR(6) | ✓ | NULL | ||
| 3 | 姓名 | name | VARCHAR(50) | ✓ | NULL | ||
| 4 | 性别 | gender | CHAR(1) | NULL | |||
| 5 | 出生日期 | birth_date | DATE | NULL |
表名: 工程项目( projects)
| 序号 | 列名 | 英文名 | 数据类型 | 必填? | 关键列 | 默认值 | 其它说明 |
|---|---|---|---|---|---|---|---|
| 1 | 项目编号 | id | BIGINT UNSIGNED | ✓ | PK | NULL | AUTO_INCREMENT |
| 2 | 名称 | name | VARCHAR(100) | ✓ | UNI | NULL | |
| 3 | 地点 | location | VARCHAR(200) | '' | |||
| 4 | 设计时薪 | hourly_pay | DECIMAL(8,2) | ✓ | NULL | >=0 |
表名: 设计记录(designings)
| 序号 | 列名 | 英文名 | 数据类型 | 必填? | 关键列 | 默认值 | 其它说明 |
|---|---|---|---|---|---|---|---|
| 1 | 记录编号 | id | BIGINT UNSIGNED | ✓ | PK | NULL | AUTO_INCREMENT |
| 2 | 人员编号 | engineer_id | BIGINT UNSIGNED | ✓ | FK | NULL | 参照 engineers.id 更新:级联 删除:限制 与“项目编号组合唯一” |
| 3 | 项目编号 | project_id | BIGINT UNSIGNED | ✓ | FK | NULL | 参照 projects.id 更新:级联 删除:限制 |
| 4 | 工时数 | working_hours | SMALL INT UNSIGNED | ✓ | NULL |
15.3.2 触发器
(无)
15.3.3 视图
(无)
15.3.4 函数和存储过程
(无)
15.4 编写脚本
drop database if exists `db_3_4`;create database if not exists `db_3_3` default charset utf8mb4;use `db_3_4`;create table `engineers`(-- 列定义`id` bigint unsigned not null auto_increment,`code` char(6) not null,`name` varchar(50) not null,`gender` char(1),`birth_date` date,-- 约束定义primary key(`id`),unique key(`code`),);create table `projects`(-- 列定义`id` bigint unsigned not null auto_increment,`name` varchar(100) not null,`location` varchar(200) default '',`hourly_pay` decimal(8,2) not null,-- 约束定义primary key(`id`),unique key(`name`));create table `designings`(-- 列定义`id` bigint unsigned not null auto_increment,`engineer_id` bigint unsigned not null,`project_id` bigint unsigned not null,`working_hours` smallint unsigned not null,-- 约束定义primary key(`id`),foreign key(`engineer_id`) references `engineers`(`id`)on update cascade on delete restrict,foreign key(`project_id`) references `projects`(`id`)on update cascade on delete restrict,unique key(`engineer_id`,`project_id`));insert into engineersvalues(1,'03031245','王小敏','女','1985-06-13'),(2,'03013267','周思明','男','1983-11-23');insert into projectsvalues(1,'光明路口改造项目','昆明市光明路',310.00),(2,'典雅小区 2 幢 1 单元 301 室装修','昆明市典雅小区二期',200.00);insert into designings(null,1,1,10),(null,1,2,2),(null,2,1,8),(null,2,2,3);
15.5 运行建库脚本并验证建库结果
15.5.1 运行脚本
MariaDB [(none)]> source [脚本所在路径\]脚本文件名;
15.5.2 验证建库结果
(1)查看表,确认表被正确建立
show tables;
(2)查看表的结构,确认列和约束被正确建立
-- 快速查看大致结构describe 表名;-- 查看详细的表定义(sql 脚本,带自动添加的默认参数)show create table 表名\G
15.6 数据操纵测试
请自行完成。
第十六章 几个综合案例
1 6.1 高校教务管理
16.1.1需求描述
有一家高校,希望用计算机软件管理教务工作。请为其设计数据库对管理数据进行存储和操作。高校划分系部,系部下有班级,每个班级可有一名教师担任辅导员,专职辅导员可担任多个班级的辅导员。各系部管理自己的教师,教师分为“专职教师”、“兼职教师”、“专职辅导员”等。专职辅导员不能授课,其余教师可以跨系部任课,兼职教师周课时不得超过 6,一学期只能上一门课。
系统需要对各类教师统计工作量(教学和辅导),并记录学生成绩。
- 数据查询
- 查询某系部的所有教师
- 查某班级的所有学生
- 查询某学期某教师的所有任课记录
- 查询某班某学期的所有授课课程
- 查询某教师辅导的所有在校班级
- 查询某班某课程的所有学生成绩
- 数据统计
- 统计每个教师在某学期的所有周课时数
16.1.2 确定管理涉及的数据实体及其关系
根据描述与分析,绘制 E-R图如下:
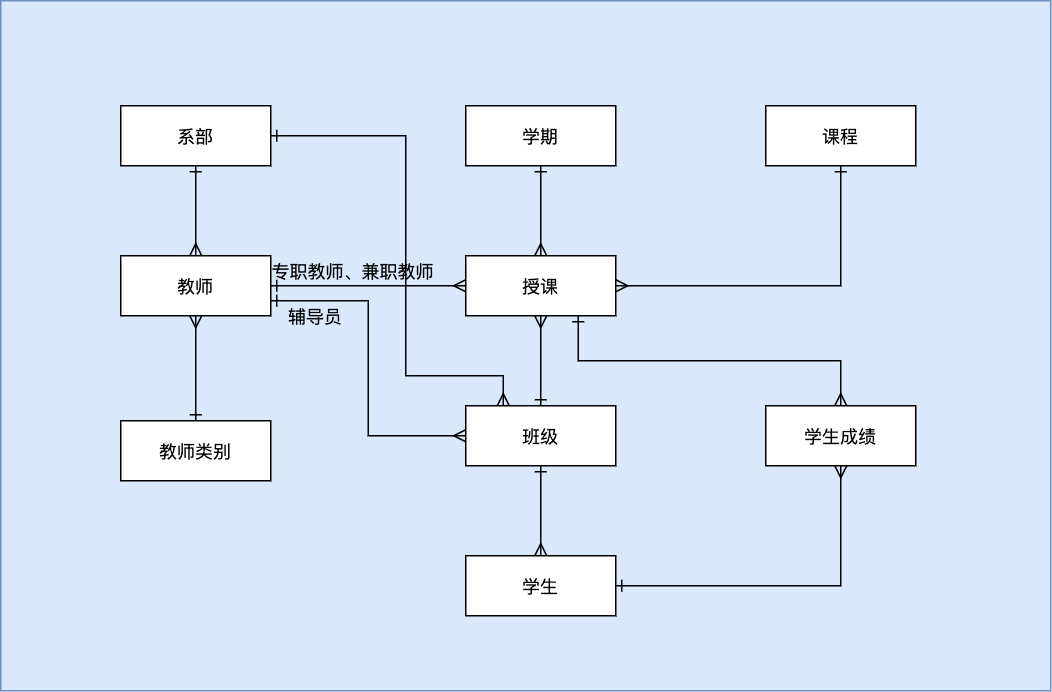
16.2 进销存管理
16.2.1 需求描述
某商店需要用计算机软件进行进销存及客户管理。成本核算采用先进先出法。商品可多级分类。
- 数据查询
- 查询商品的所有库存
- 列出某分类的所有商品
- 列出某客户的所有订单
- 列出本月过生日的所有客户
- 查询某商品的库存量
- 显示所有低于库存警戒线的商品
- 列出某商品的成本单价和库存量
- 数据统计
- 统计某商品在过去十二个月的每月销量
- 列出客户历史购买的商品数量和总额,从高到低排序
- 列出所有销售订单的销售总额、成本总额及毛利润
16.2.2 确定管理涉及的数据实体及其关系
根据描述与分析,绘制 E-R图如下:
附录
附录一 MySQL/MariaDB 常用数据类型速查表
(1)数值型
| 类型 | 大小 | 范围(有符号) | 范围(无符号) | 用途 |
|---|---|---|---|---|
| TINYINT | 1 字节 | (-128,127) | (0,255) | 微整数值 |
| SMALLINT | 2 字节 | (-32 768,32 767) | (0,65 535) | 小整数值 |
| MEDIUMINT | 3 字节 | (-8 388 608,8 388 607) | (0,16 777 215) | 中等整数值 |
| INT或INTEGER | 4 字节 | (-2 147 483 648,2 147 483 647) | (0,4 294 967 295) | 大整数值 |
| BIGINT | 8 字节 | (-9,223,372,036,854,775,808,9 223 372 036 854 775 807) | (0,18 446 744 073 709 551 615) | 极大整数值 |
| FLOAT | 4 字节 | (-3.402 823 466 E+38,-1.175 494 351 E-38),0,(1.175 494 351 E-38,3.402 823 466 351 E+38) | 0,(1.175 494 351 E-38,3.402 823 466 E+38) | 单精度浮点数值 |
| DOUBLE | 8 字节 | (-1.797 693 134 862 315 7 E+308,-2.225 073 858 507 201 4 E-308),0,(2.225 073 858 507 201 4 E-308,1.797 693 134 862 315 7 E+308) | 0,(2.225 073 858 507 201 4 E-308,1.797 693 134 862 315 7 E+308) | 双精度浮点数值 |
| DECIMAL | 对DECIMAL(M,D) ,如果M>D,为M+2否则为D+2 | 依赖于M和D的值 | 依赖于M和D的值 | 小数值 |
(2)日期和时间类型
| 类型 | 大小(字节) | 范围 | 格式 | 用途 |
|---|---|---|---|---|
| DATE | 3 | 1000-01-01/9999-12-31 | YYYY-MM-DD | 日期值 |
| TIME | 3 | '-838:59:59'/'838:59:59' | HH:MM:SS | 时间值或持续时间 |
| YEAR | 1 | 1901/2155 | YYYY | 年份值 |
| DATETIME | 8 | 1000-01-01 00:00:00/9999-12-31 23:59:59 | YYYY-MM-DD HH:MM:SS | 混合日期和时间值 |
| TIMESTAMP | 4 | 1970-01-01 00:00:00/2038 结束时间是第 2147483647 秒,北京时间 2038-1-19 11:14:07,格林尼治时间 2038年1月19日 凌晨 03:14:07 |
YYYYMMDD HHMMSS | 混合日期和时间值,时间戳 |
(3)字符串类型
| 类型 | 大小 | 用途 |
|---|---|---|
| CHAR | 0-255字节 | 定长字符串 |
| VARCHAR | 0-65535 字节 | 变长字符串 |
| TINYTEXT | 0-255字节 | 短文本字符串 |
| TEXT | 0-65 535字节 | 长文本数据 |
| MEDIUMTEXT | 0-16 777 215字节 | 中等长度文本数据 |
| LONGTEXT | 0-4 294 967 295字节 | 极大文本数据 |
(4)二进制类型(图像、音频、视频、二进制程序代码……)
| 类型 | 大小 | 用途 |
|---|---|---|
| TINYBLOB | 0-255字节 | 不超过 255 个字节的二进制数据 |
| BLOB | 0-65 535字节 | 二进制数据 |
| MEDIUMBLOB | 0-16 777 215字节 | 二进制中等长度数据 |
| LONGBLOB | 0-4 294 967 295字节 | 二进制极大长度数据 |
附录二 MySQL/MariaDB 比较运算与逻辑运算
比较运算
| 序号 | 运算符 | 含义 | 举例 |
|---|---|---|---|
| 1 | = | 等于 | name='王晓晓' |
| 2 | != | 不等于 | price!=800 |
| 3 | > | 大于 | count>1500 |
| 4 | >= | 大于或等于 | dateOfBirth>='1990-12-31' |
| 5 | < | 小于 | age<18 |
| 6 | <= | 小于等于 | age<=18 |
| 7 | between x and y | 介于 x 和 y 之间(含 x 和 y) | age between 18 and 60 |
| 8 | in (a,b,...) | 值等于 a,b,...中的任意一个 | loaction in ('昆明','上海','北京') |
| 9 | like 'xyz' | 像(匹配),% 代表零到任意多个任意字符的组合 | name like '李%' name like '%明' name like '%小%' |
逻辑运算
| 序号 | 运算符 | 含义 | 举例 |
|---|---|---|---|
| 1 | and | 并且 | a>10 and b>30(两条都要满足) |
| 2 | or | 或者 | a>10 or b>30(只要一条满足即可) |
| 3 | not | 不(否定) | name not like '%so%' id not in (1,10,12) |
| 4 | xor | 异或(相异为真) | age>18 xor title='' |
